Apuntes · Capítulo 14Computación moderna
Internet y una mirada a Python
Internet y una mirada a Python
Hasta ahora, cada programa del curso corrió solo, en una computadora. Leyó del teclado o de un archivo, y escribió en la terminal. La semana pasada medimos cuánto trabajo hace un programa según el tamaño de su entrada. Hoy levantamos la vista, y lo hacemos en dos direcciones.
La primera es internet: qué pasa entre el momento en que escriben una dirección en el navegador y el momento en que ven la página. Son programas que se mandan texto y bytes, con reglas que ustedes pueden leer con sus propios ojos. Lo veremos con un servidor que corre en su computadora, sin depender de la conexión del laboratorio.
La segunda es Python, un lenguaje distinto de C. Tomaremos un programa de primos que ya conocen y lo veremos en pseudocódigo, en C y en Python. Es una primera mirada: no se evalúa programar en Python. Lo que importa es que puedan leerlo y explicar qué cambió, qué se ganó y qué se pagó por eso.
Lectura. El código de este capítulo está en
code/week-14. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Casi todo funciona sin internet. Las pocas salidas que sí la usaron dicen la fecha, y ustedes no las necesitan para el laboratorio.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Internet es una red de redes” y “DNS: de nombres a números”. Es lo mínimo para seguir la clase.
- En clase: “HTTP: una conversación en texto”, “HTTPS: qué protege y qué no”, “Abrir una página, paso a paso”, “¿Por qué hay más de un lenguaje?”, “El mismo programa tres veces” y “Lo que alguien resolvió por debajo”.
- Después de clase: para el laboratorio, “El laboratorio” y “La Práctica 4”; para repasar, “Resumen” y “Ejercicios”. Opcional: “¿Cuál es más rápido?” y “Qué pasa cuando algo sale mal”.
Internet es una red de redes
Una red es un grupo de computadoras conectadas que pueden mandarse datos: las de un laboratorio, las de una casa con su wifi, las de una empresa. Internet es lo que resulta de conectar esas redes entre sí. Nadie la maneja entera. Cada red tiene su dueño, y todas siguen las mismas reglas para pasarse datos. A esas reglas se les llama protocolos.
Cuidado con una confusión frecuente: internet no es lo mismo que la web. Internet es la red. La web, con sus páginas y sus navegadores, es uno de los servicios que corren encima de ella. El correo electrónico y las videollamadas son otros.
Paquetes
Los datos no viajan de una sola pieza. Se cortan en paquetes (packets): trozos pequeños, y cada uno lleva anotada la dirección de destino y la de origen. Es como mandar un libro por encomienda en muchos sobres: cada sobre viaja por su cuenta, y al final hay que juntarlos en orden.
Cortar en paquetes tiene una ventaja: muchas conversaciones comparten el mismo cable, turnándose paquete por paquete, sin que una descarga grande bloquee a las demás.
Direcciones IP
La dirección que va en cada paquete es la dirección IP. Hay dos formatos en uso:
| Versión | Tamaño | Ejemplo |
|---|---|---|
| IPv4 | 32 bits, escritos como cuatro números de 0 a 255 | 192.168.1.20 |
| IPv6 | 128 bits, escritos en hexadecimal | ::1 |
Son números binarios, como todo lo que vieron en la semana 3. Los puntos solo facilitan la lectura.
Una dirección especial importa mucho hoy: 127.0.0.1 significa “esta misma computadora”. Los
paquetes que van ahí no salen a la red. Por eso todo el laboratorio funciona sin internet.
Routers: un salto a la vez
Un router es un equipo conectado a dos o más redes, que pasa paquetes de una a otra. Cuando le llega un paquete, mira la dirección de destino, consulta una tabla y decide a qué vecino entregarlo. Ese vecino hace lo mismo. Cada router solo decide el siguiente salto.
Se parece a preguntar por una dirección en una ciudad que no conocen: cada persona solo les dice
hacia dónde seguir. El comando traceroute intenta mostrar esos saltos. -n pide números en vez
de nombres, -q 1 hace una prueba por salto, -w 1 espera 1 segundo por cada una y -m 5 llega como
máximo a 5 saltos. Esta salida es del 2 de noviembre de 2026 y depende de la red:
$ traceroute -n -w 1 -q 1 -m 5 example.com
traceroute to example.com (104.20.23.154), 5 hops max, 60 byte packets
 1  172.17.0.1  0.026 ms
 2  *
 3  *
 4  *
 5  *
El primer salto, 172.17.0.1, es la salida de nuestro contenedor hacia el resto de la red, dentro de Docker. Un * significa
que no llegó respuesta a tiempo. No significa necesariamente que el paquete se perdió: muchos equipos no
responden a estas pruebas, o las bloquean, y la propia configuración de Docker puede impedir ver esas respuestas. En su red puede salir algo muy distinto, y no hace falta
que les funcione. example.com es un nombre reservado para ejemplos en documentación.
Lo que IP no promete: TCP
IP hace su mejor esfuerzo, y nada más. Un paquete se puede perder si un router está saturado. Dos paquetes pueden tomar caminos distintos y llegar en otro orden. IP no avisa de nada de esto.
Por encima de IP corre TCP (Transmission Control Protocol). Las dos computadoras primero acuerdan abrir una conexión. Después, TCP numera los bytes, el otro lado confirma lo que recibe y lo que no se confirma se vuelve a mandar. El programa que usa TCP ve una secuencia de bytes completa y en orden, y no se entera de los paquetes.
Falta una cosa. La dirección IP lleva hasta una computadora, pero en esa computadora corren muchos programas, como vimos en la semana 9. ¿Para cuál son los datos? Para eso está el puerto: un número de 0 a 65535 que identifica a un programa dentro de la computadora. Por costumbre, los servidores web usan el 80 para HTTP y el 443 para HTTPS. Nuestro servidor del laboratorio usa el 8014.
| Pregunta | Quién responde |
|---|---|
| ¿A qué computadora va? | IP, con la dirección IP |
| ¿A qué programa de esa computadora va? | TCP, con el puerto |
| ¿Llegó todo y en orden? | TCP |
| ¿Qué significan esos bytes? | El protocolo de la aplicación, como HTTP |
Idea clave. Cada protocolo resuelve su parte y se apoya en el de abajo. HTTP no sabe nada de routers, y los routers no saben nada de páginas web.
DNS: de nombres a números
Las personas recuerdan example.com. Los routers solo entienden direcciones IP. DNS (Domain Name
System) es el sistema que traduce nombres a direcciones. Funciona como una agenda de contactos gigante,
repartida en muchos servidores, y que nadie guarda completa.
Los nombres se leen de derecha a izquierda, de lo general a lo particular: com agrupa muchos dominios,
y example es uno de ellos. La búsqueda sigue ese orden. Su computadora le pregunta a un servidor llamado
resolvedor (resolver), que suele darlo su proveedor de internet o su universidad. Si él no sabe la
respuesta, pregunta por pasos:
| Paso | El resolvedor le pregunta a | Y le responde |
|---|---|---|
| 1 | Un servidor raíz | “Para com, pregúntale a estos” |
| 2 | Un servidor de com |
“Para example.com, pregúntale a estos” |
| 3 | El servidor de example.com |
“La dirección es esta” |
El resolvedor guarda la respuesta un tiempo, en una cache: la misma idea de la semana 9, ahora con nombres. Por eso la mayoría de las preguntas se responden sin dar los tres pasos.
El comando dig hace una pregunta de DNS y muestra la respuesta. También esta salida es del 2 de
noviembre de 2026 y depende de la red. La recortamos:
$ dig example.com A
;; ANSWER SECTION:
example.com.		377	IN	A	104.20.23.154
example.com.		377	IN	A	172.66.147.243

;; Query time: 95 msec
;; SERVER: 192.168.65.7#53(192.168.65.7) (UDP)
A pide una dirección IPv4. El 377 son los segundos que esa respuesta puede seguir en la cache. Hay dos
direcciones porque un nombre puede tener varias. SERVER es el resolvedor al que se le preguntó, que aquí
es el de Docker. La pregunta viajó por UDP, un protocolo más simple que TCP, sin conexión ni
reenvíos: si no hay respuesta, se vuelve a preguntar.
Sin internet, dig example.com no obtiene respuesta. Pero el nombre localhost funciona igual, porque
no se le pregunta a DNS: está en un archivo de esta computadora, /etc/hosts. El comando getent hosts
busca un nombre como lo haría un programa. Esta salida depende de cómo esté configurada la máquina:
$ getent hosts localhost
::1             localhost ip6-localhost ip6-loopback
::1 es la versión IPv6 de 127.0.0.1.
Error común. Pensar que DNS trae la página. DNS solo responde con una dirección. Si DNS falla, el navegador dice que no encuentra el sitio, aunque el sitio y la red estén bien.
HTTP: una conversación en texto
HTTP (HyperText Transfer Protocol) es el protocolo de la web. Tiene dos papeles. El cliente (client), como el navegador, pide algo. El servidor (server) es un programa que espera pedidos y los responde. Cada intercambio es una petición (request) y una respuesta (response).
Vamos a verlo con nuestro propio servidor. Para esto necesitan dos terminales dentro del entorno del
curso, porque el servidor se queda corriendo en una mientras preguntan desde la otra. En Codespaces,
dividan la terminal. Con Docker, abran otra terminal en la laptop y corran env/run.sh otra vez: entra al
mismo contenedor. En las dos, vayan a code/week-14.
En la primera terminal:
$ python3 server.py
Servidor en http://127.0.0.1:8014/ (Ctrl+C para detener)
El programa no termina: está esperando. Eso hace un servidor. server.py está escrito en Python, con
su biblioteca estándar. No hace falta entenderlo todavía. Se detiene con Ctrl+C, como vieron en la semana 1.
En la segunda terminal usamos curl, un cliente de línea de comandos. Es como un navegador que no dibuja
nada. La opción -v (verbose) le pide que muestre la conversación:
$ curl -v http://127.0.0.1:8014/saludo
*   Trying 127.0.0.1:8014...
* Connected to 127.0.0.1 (127.0.0.1) port 8014
* using HTTP/1.x
> GET /saludo HTTP/1.1
> Host: 127.0.0.1:8014
> User-Agent: curl/8.14.1
> Accept: */*
>
* Request completely sent off
< HTTP/1.1 200 OK
< Server: ServidorDelCurso/1.0
< Date: Mon, 02 Nov 2026 14:50:34 GMT
< Content-Type: text/plain; charset=utf-8
< Content-Length: 20
<
Buenos días, Perú
* Connection #0 to host 127.0.0.1 left intact
Las líneas tienen tres marcas. * es un comentario de curl. > es lo que curl mandó. < es lo que
recibió. La fecha y la versión de curl cambian de una corrida a otra.
Lean ese intercambio por partes.
La URL. http://127.0.0.1:8014/saludo dice el protocolo, la computadora, el puerto y la ruta. Sin
puerto, http usa el 80. Sin ruta, se pide /. Como aquí la computadora es un número, no hizo falta DNS.
La petición. La primera línea tiene el método, la ruta y la versión. GET significa “dame esto”. Hay
otros métodos, como POST, que manda datos, por ejemplo al llenar un formulario. Las líneas que siguen son
encabezados (headers): un nombre, dos puntos y un valor. Host dice a qué nombre se dirige la petición,
porque en una misma computadora pueden vivir muchos sitios. En HTTP/1.1 es obligatorio. Una línea
vacía marca el final.
La respuesta. La primera línea tiene la versión, el código de estado y su explicación. Siguen los encabezados y la línea vacía. Después viene el cuerpo (body), que es el contenido pedido.
Content-Length: 20 dice cuántos bytes tiene el cuerpo. Cuenten: Buenos días, Perú y su salto de línea son
18 caracteres. Pero í y ú ocupan 2 bytes en UTF-8, así que son 20. Es lo mismo que vieron con strlen("año").
En la primera terminal, el servidor anotó el pedido. La fecha cambia:
127.0.0.1 - - [02/Nov/2026 14:50:34] "GET /saludo HTTP/1.1" 200 -Es texto de verdad
La opción -i de curl incluye en la salida los encabezados de la respuesta, y -s (silent) oculta su barra de progreso:
$ curl -si http://127.0.0.1:8014/
HTTP/1.1 200 OK
Server: ServidorDelCurso/1.0
Date: Mon, 02 Nov 2026 14:50:34 GMT
Content-Type: text/html; charset=utf-8
Content-Length: 78

<!DOCTYPE html>
<html>
<body>
<h1>Hola desde el servidor</h1>
</body>
</html>
El cuerpo ahora es HTML, el lenguaje en que se escriben las páginas. Un navegador recibe exactamente
este texto y lo dibuja. Content-Type le dice cómo interpretar los bytes del cuerpo. Una página real suele
nombrar imágenes, estilos y programas, y el navegador hace una petición más por cada uno que no
tenga guardado. Abrir una página casi nunca es una sola petición.
En HTTP/1.1, cada línea de los encabezados termina en dos bytes, \r y \n, no solo en el \n que usamos en
C. No se ven en la terminal, pero el comando od -c los muestra. Eso importa para el laboratorio. Recortamos la salida a
las dos primeras líneas con head -2:
$ curl -si http://127.0.0.1:8014/saludo | od -c | head -2
0000000   H   T   T   P   /   1   .   1       2   0   0       O   K  \r
0000020  \n   S   e   r   v   e   r   :       S   e   r   v   i   d   o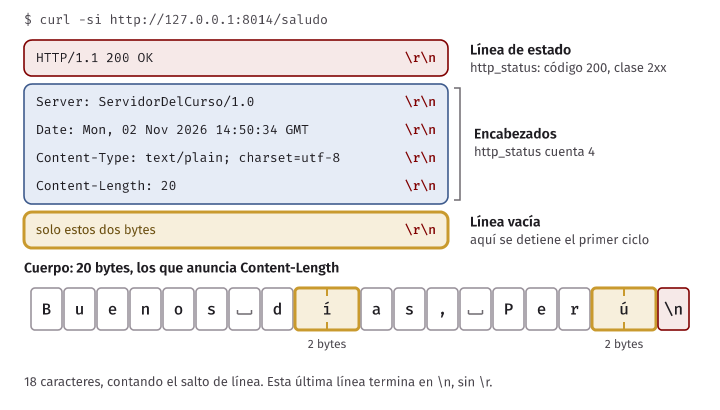
Códigos de estado
El primer dígito del código dice de qué tipo es la respuesta:
| Clase | Significa | Ejemplos |
|---|---|---|
| 1xx | Información, sigan | 100 Continue |
| 2xx | Funcionó | 200 OK |
| 3xx | Vayan a otro lugar | 301 Moved Permanently |
| 4xx | El cliente pidió algo mal | 403 Forbidden, 404 Not Found |
| 5xx | Falló el servidor | 500 Internal Server Error, 503 Service Unavailable |
Pidamos una ruta que no existe. curl -si nos deja ver el código y el cuerpo:
$ curl -si http://127.0.0.1:8014/nada
HTTP/1.1 404 Not Found
Server: ServidorDelCurso/1.0
Date: Mon, 02 Nov 2026 14:50:34 GMT
Content-Type: text/plain; charset=utf-8
Content-Length: 22

No existe esa página
Noten algo: el 404 es una respuesta normal de HTTP. La red funcionó, el servidor corrió y respondió. Simplemente
dijo que no tiene eso. Si el servidor estuviera apagado no habría código ninguno, porque nadie responde. Prueben a
detenerlo y pedir de nuevo con curl -sS -i: da un error de conexión. La opción -s calla los errores, y -S los vuelve a mostrar.
Nuestra ruta /error devuelve un 500 a propósito, para que lo vean:
$ curl -si http://127.0.0.1:8014/error
HTTP/1.1 500 Internal Server Error
Server: ServidorDelCurso/1.0
Date: Mon, 02 Nov 2026 14:50:34 GMT
Content-Type: text/plain; charset=utf-8
Content-Length: 32

Algo falló dentro del servidor
Un código lo escribe un programa: el servidor decide qué responder. En un sitio real, un 500 suele querer
decir que el programa detrás de la página encontró un error que no supo manejar. Y no es automático. Si
la función que atiende en un servidor como server.py se cae con un error, no se manda ningún 500: curl -sS -i dice Empty reply from server.
Error común. Leer un 500 como “ustedes hicieron algo mal”. Los 4xx apuntan al pedido. Los 5xx apuntan al servidor, y reintentar el mismo pedido quizá funcione más tarde.
HTTP/2 y HTTP/3
Lo que vimos es HTTP/1.1, que es texto. Las versiones más nuevas cambian la forma de viajar, y conservan las mismas ideas de métodos, rutas, encabezados y códigos:
| Versión | Cómo viaja |
|---|---|
| HTTP/1.1 | Texto sobre TCP |
| HTTP/2 | Binario sobre TCP, con varias peticiones a la vez en una conexión |
| HTTP/3 | Binario sobre QUIC, un protocolo que corre sobre UDP y ya incluye el cifrado |
Así respondió un servidor real el 2 de noviembre de 2026, usando HTTP/2. -I pide solo los
encabezados. La salida está recortada y depende de la red. HTTP/2 manda los nombres de los encabezados en minúsculas:
$ curl -sI https://example.com/
HTTP/2 200
date: Mon, 02 Nov 2026 14:50:41 GMT
content-type: text/html; charset=utf-8
HTTPS: qué protege y qué no
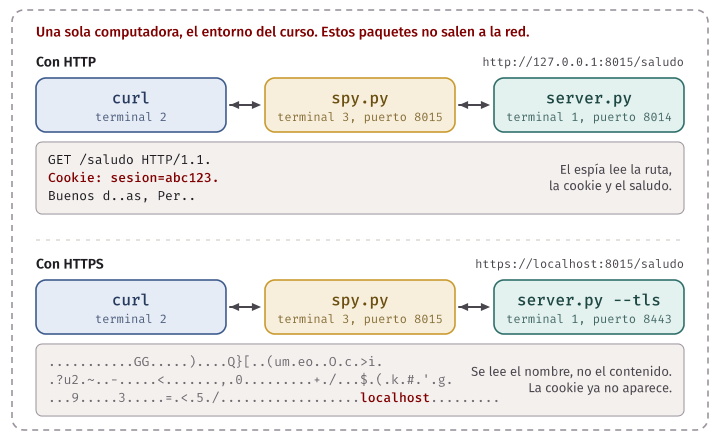
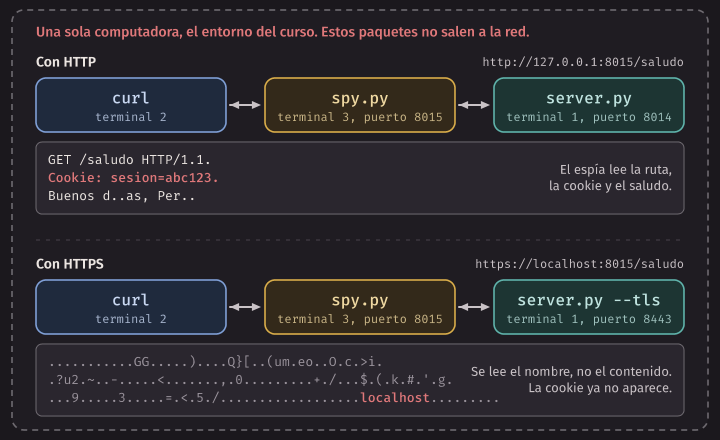
Un paquete pasa por muchos equipos que no son suyos. Con HTTP, cualquiera de ellos puede leerlo. Vamos a
comprobarlo con spy.py: un programa que se pone en medio de una conexión y escribe lo que pasa por ahí. Hace
en pequeño lo que puede hacer cualquier equipo de la ruta. Solo sirve dentro de su computadora.
Necesitan una tercera terminal, también en code/week-14, con el servidor aún corriendo en la primera:
$ python3 spy.py 8015 8014
Espía en el puerto 8015, reenvía al 8014
Pedimos la página a través del espía, en el puerto 8015. Le agregamos una cookie: un dato que un
sitio le pide guardar al navegador, y que el navegador devuelve en cada petición. Muchas veces es lo que
identifica su sesión, y quien lo copie puede hacerse pasar por ustedes. -H agrega un encabezado:
$ curl -s -H "Cookie: sesion=abc123" http://127.0.0.1:8015/saludo
Buenos días, Perú
Y el espía escribió esto. Los bytes que no se pueden imprimir salen como un punto, como el \r al final de cada línea. En otra
corrida, los bytes pueden llegar repartidos en otros pedazos y con otras cuentas:
--- cliente a servidor, 107 bytes
GET /saludo HTTP/1.1.
Host: 127.0.0.1:8015.
User-Agent: curl/8.14.1.
Accept: */*.
Cookie: sesion=abc123.
.

--- servidor a cliente, 147 bytes
HTTP/1.1 200 OK.
Server: ServidorDelCurso/1.0.
Date: Mon, 02 Nov 2026 14:51:47 GMT.
Content-Type: text/plain; charset=utf-8.
Content-Length: 20.
.

--- servidor a cliente, 20 bytes
Buenos d..as, Per..
Lo leyó todo, también la cookie.
HTTPS es HTTP dentro de una conexión protegida por TLS (Transport Layer Security). HTTP no cambia: los mismos métodos y los mismos códigos. Lo que cambia es que, antes de mandar la petición, cliente y servidor acuerdan una clave secreta, y desde ahí todo viaja cifrado: convertido en bytes que no se pueden leer sin esa clave, ni cambiar sin que se note. Cómo se acuerda una clave delante de todos usa matemática que queda para otro curso.
Probemos lo mismo con cifrado. Primero make cert crea un certificado de prueba, en build/. Dentro de un
momento vemos qué es. Detengan el servidor y el espía con Ctrl+C y levanten estos dos, cada uno en su terminal:
$ make cert
$ python3 server.py --tls
Servidor en https://localhost:8443/ (Ctrl+C para detener)
$ python3 spy.py 8015 8443
Espía en el puerto 8015, reenvía al 8443La misma petición, con https. --cacert le dice a curl en qué certificado confiar:
$ curl -s --cacert build/cert.pem -H "Cookie: sesion=abc123" https://localhost:8015/saludo
Buenos días, Perú
El cliente recibió lo mismo. El espía ahora ve esto. Mostramos solo el comienzo, y los bytes cambian en cada corrida:
--- cliente a servidor, 1569 bytes
...........GG.....)....Q}[..(um.eo..O.c.>i. ...a....:....xQE@Q
.?u2.~..-.....<.......,.0.........+./...$.(.k.#.'.g.
...9.....3.....=.<.5./..................localhost.........
...........................h2.http/1.1.........1.....6.4.........................
Ya no aparecen la ruta, la cookie ni el saludo. Pero fíjense en lo que sí se lee: localhost, el nombre del
sitio. El cliente lo manda sin cifrar al comenzar, para que el servidor sepa qué certificado presentar.
Qué ve quien administra la red
Con todo esto se puede responder a una pregunta práctica. Quien administra la red del laboratorio, o de un
wifi público, ve los paquetes que pasan. Si ustedes abren https://example.com/notas:
| Dato | ¿Lo puede ver? | Por qué |
|---|---|---|
| Direcciones IP y puertos | Sí | Los routers los necesitan para entregar los paquetes |
El nombre example.com |
Normalmente sí | Va en la pregunta de DNS y al comenzar TLS |
| Cuándo, y cuántos bytes | Sí | Se ve por el tráfico, sin leerlo |
La ruta /notas |
No | Va dentro de la petición cifrada |
| Encabezados y cookies | No | También van cifrados |
| Contraseñas y contenido | No | También van cifrados |
Hay técnicas más nuevas que cifran también la pregunta de DNS y el nombre, pero no cuenten con ellas si no saben que están activas.
El certificado: con quién están hablando
Cifrar no basta. ¿De qué sirve una conversación secreta si es con un impostor? Un certificado es un
documento digital que dice “esta clave pertenece a este nombre”, firmado por una autoridad de certificación, en la que
el navegador ya confía. Sin ese respaldo, el cliente se niega a seguir. Es lo que pasa si no le damos --cacert, y nuestro
certificado de prueba no lo firmó ninguna autoridad. La salida está recortada:
$ curl -s -S https://localhost:8443/saludo
curl: (60) SSL certificate problem: self-signed certificate
Por eso, cuando un navegador avisa que el certificado no es válido, el aviso merece atención.
Lo que HTTPS no protege
- Que el sitio sea honesto. El candado o el ícono del sitio, cuya forma cambia según el navegador, solo dice que hablan cifrado con quien tiene ese nombre. Una página falsa en un nombre parecido, hecha para robar contraseñas, también puede tener su certificado.
- Lo que pasa en las puntas. Al llegar al servidor, los datos se descifran. Si el servidor los guarda mal o tiene un bug, HTTPS no ayuda. Tampoco ayuda si su computadora tiene un programa malicioso.
- Una computadora administrada por otros. Quien administra una máquina puede hacer que ella confíe en un certificado suyo, y así leer su tráfico. Lo que dijimos arriba vale para quien solo controla la red.
Idea clave. HTTPS protege el contenido en el camino, y también que nadie lo cambie sin que se note, además de confirmar con qué nombre hablan. No oculta con quién hablan ni dice si pueden confiar en ese alguien.
Abrir una página, paso a paso
Ya tenemos todas las piezas. Esto es lo que ocurre al abrir https://example.com/, como un algoritmo:
algoritmo abrir_pagina(nombre, ruta)
    ip ← preguntar_a_dns(nombre)
    conexion ← abrir_tcp(ip, 443)
    canal ← iniciar_tls(conexion, nombre)
    respuesta ← pedir_http(canal, "GET", ruta)
    si codigo(respuesta) = 200 entonces
        dibujar(cuerpo(respuesta))
    sino
        escribir "Mostrar el error ", codigo(respuesta)
    fin si
fin algoritmo
El orden no es arbitrario. Cada paso necesita el anterior:
| Paso | Qué se hace | Necesita | Quién puede leerlo en el camino |
|---|---|---|---|
| 1. DNS | Traducir el nombre a una IP | El nombre | Normalmente, los equipos de la ruta |
| 2. TCP | Abrir la conexión con esa IP, puerto 443 | La IP | Los equipos de la ruta ven IP y puerto |
| 3. TLS | Revisar el certificado y acordar la clave | La conexión | Los equipos de la ruta ven el nombre |
| 4. HTTP | Pedir la ruta y recibir la página | El canal cifrado | Nadie más que las dos puntas |
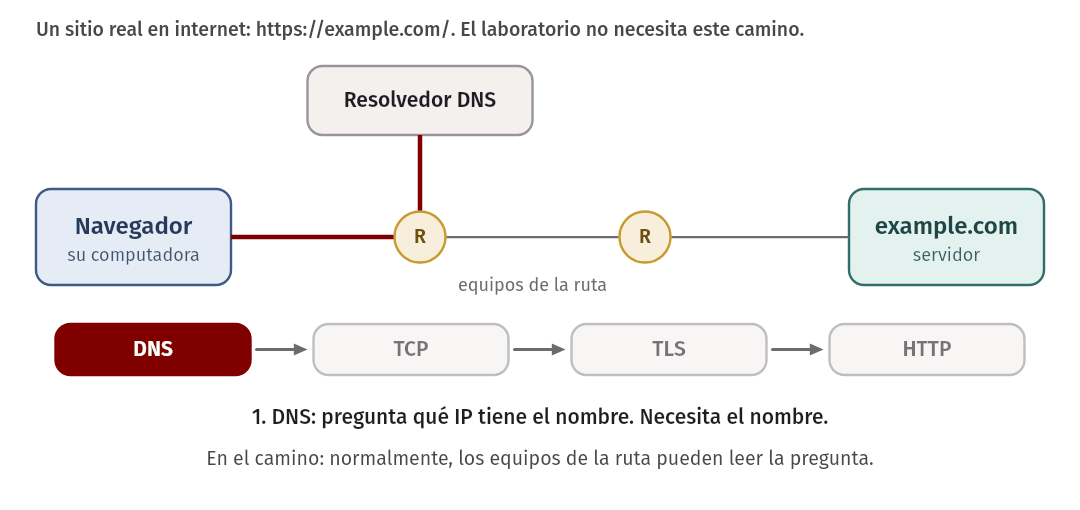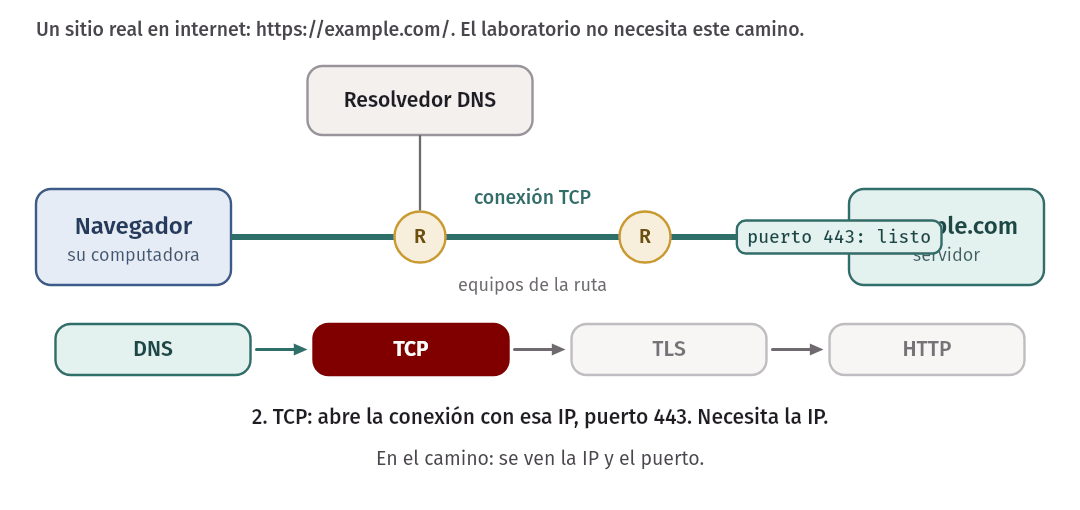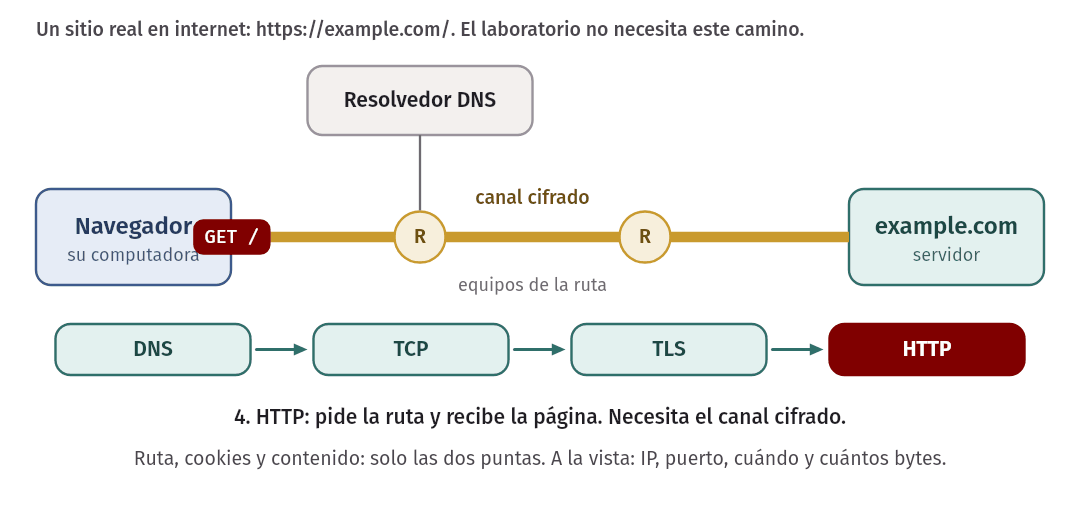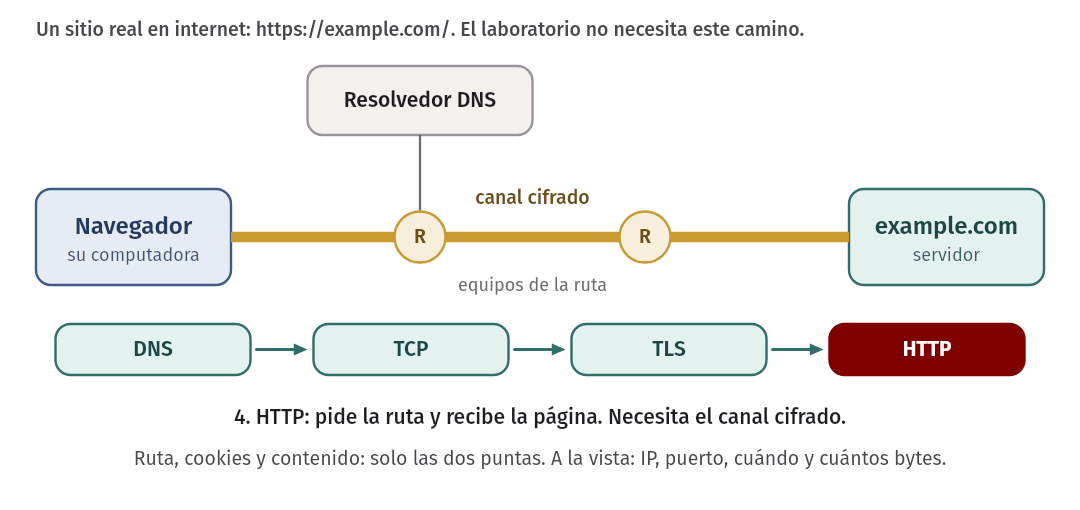
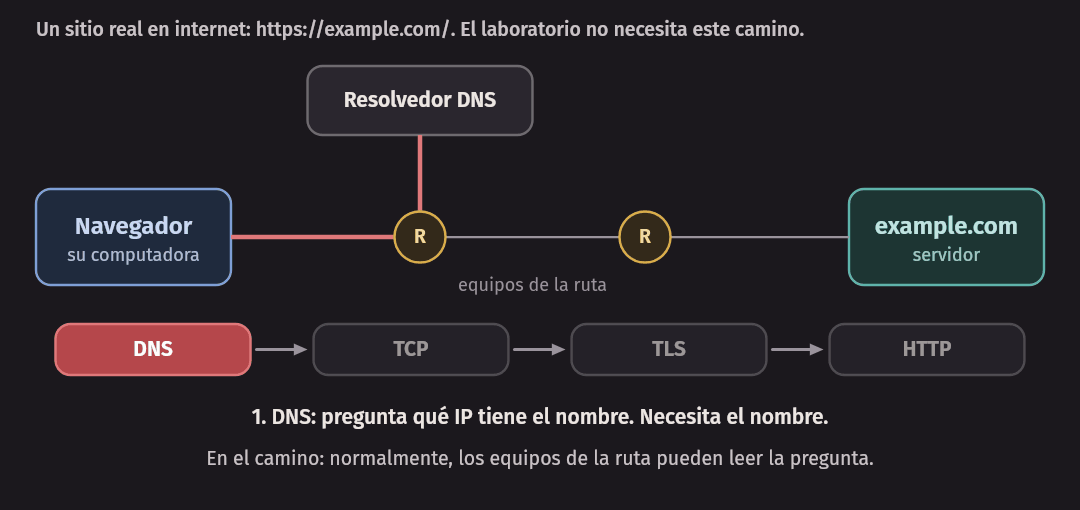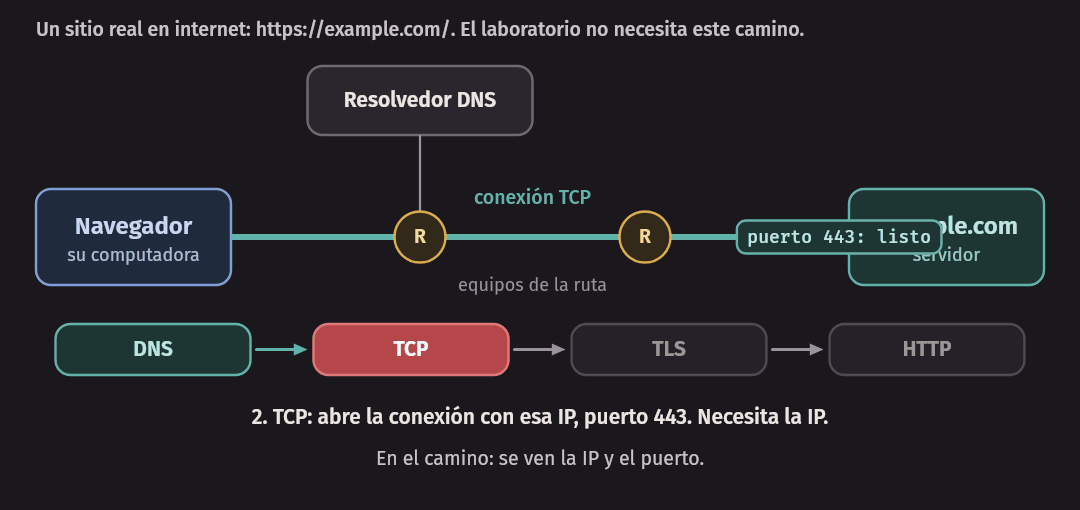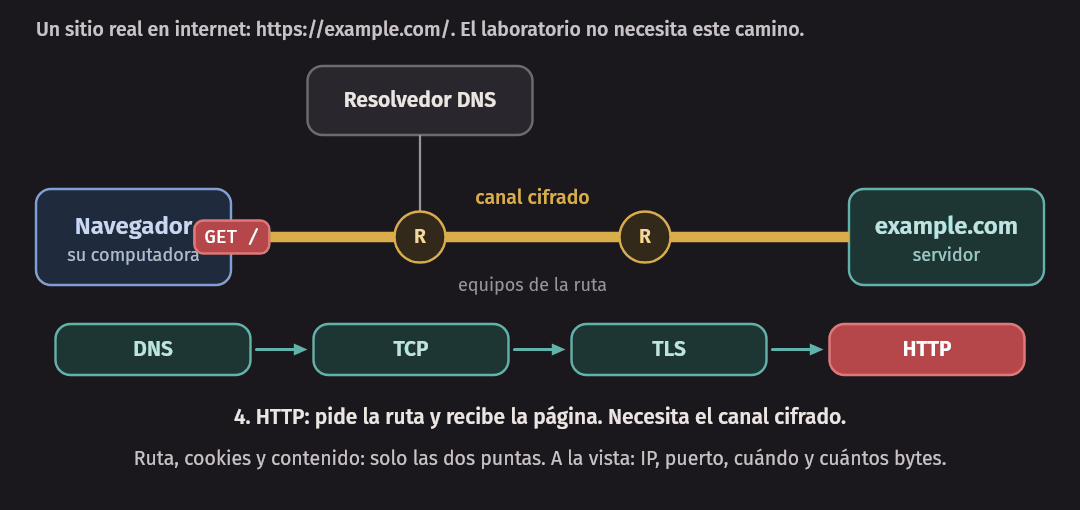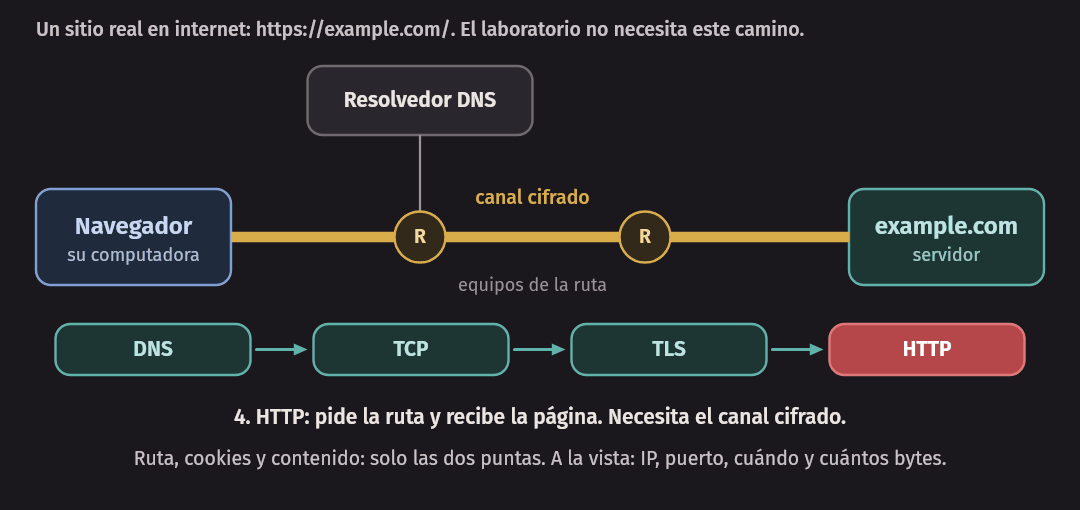
Dos precisiones. Si el navegador ya tiene la IP o la conexión de una visita reciente, se salta esos pasos. Y con HTTP/3, QUIC reúne los pasos 2 y 3 sobre UDP, en vez de usar TCP; el orden de las ideas es el mismo.
¿Por qué hay más de un lenguaje?
Cambiamos de tema. Escribimos server.py en Python, en unas 80 líneas. Hacer lo mismo en C pediría bastante
más: conexiones de red, cadenas con límites, memoria. A cambio, un programa en C suele correr más rápido y da control sobre cada
byte. Ningún lenguaje gana en todo:
| Se necesita | Suele elegirse | Por qué |
|---|---|---|
| Un sistema operativo, o el programa de un equipo con muy poca memoria | C | Control de la memoria y velocidad, sin nada encima |
| Una herramienta rápida de escribir, o procesar datos | Python | Se escribe poco y trae muchas bibliotecas |
| Algo que corra dentro del navegador | JavaScript | Los navegadores lo ejecutan directamente |
Compilado e interpretado
En la semana 1 vimos que gcc traduce C a código máquina. Una vez compilado, el ejecutable corre sin gcc, y
la CPU ejecuta sus instrucciones directamente. Esto se llama compilar.
Un intérprete es un programa que lee otro programa y hace lo que dice, mientras corre. El programa python3
es uno, y hace dos pasos. Traduce su archivo a bytecode: instrucciones sencillas para una máquina imaginaria, no
para la CPU. Después, un ciclo escrito en C las recorre una por una y hace lo que cada una pide. Se puede ver ese bytecode. Estas
instrucciones cambian de una versión de Python a otra:
def add_one(x):
    return x + 1
$ python3 show_bytecode.py
5 RESUME 0
6 LOAD_FAST_BORROW 0 (x)
LOAD_SMALL_INT 1
BINARY_OP 0 (+)
RETURN_VALUEC con gcc |
Python con python3 |
|
|---|---|---|
| Qué se ejecuta | Código máquina, en la CPU | Bytecode, en un intérprete escrito en C |
| Cuándo se detectan errores de tipos | Muchos, al compilar | Al correr esa línea |
| Se necesita para correrlo | Solo el ejecutable, para esa CPU y ese sistema | python3 y el archivo fuente |
Precisión: “compilado” e “interpretado” describen cómo se ejecuta un lenguaje en una herramienta, no al lenguaje en sí. Existen intérpretes de C. Y hay versiones de Python que traducen partes a código máquina mientras corren. Lo de esta tabla describe lo que usamos en este curso.
El mismo programa tres veces
Tomemos un programa hecho de piezas que ya conocen: contar los primos hasta un límite, como en la semana 6, con la
función is_prime de la semana 7, que prueba divisores solo hasta la raíz.
Primero, el pseudocódigo:
algoritmo es_primo(n)
    si n < 2 entonces
        devolver falso
    fin si
    d ← 2
    mientras d ≤ n div d hacer
        si n mod d = 0 entonces
            devolver falso
        fin si
        d ← d + 1
    fin mientras
    devolver verdadero
fin algoritmo

algoritmo contar_primos()
    leer limite
    cuenta ← 0
    para n desde 2 hasta limite hacer
        si es_primo(n) entonces
            cuenta ← cuenta + 1
        fin si
    fin para
    escribir "Hay ", cuenta, " primos hasta ", limite
fin algoritmo
En C, en primes.c:
int is_prime(int n) {
    if (n < 2) {
        return 0;
    }
    int d = 2;
    while (d <= n / d) {
        if (n % d == 0) {
            return 0;
        }
        d = d + 1;
    }
    return 1;
}

int main(void) {
    int limit;
    if (scanf("%d", &limit) != 1) {
        printf("Entrada inválida\n");
        return 1;
    }
    int count = 0;
    for (int n = 2; n <= limit; n++) {
        if (is_prime(n)) {
            count = count + 1;
        }
    }
    printf("Hay %d primos hasta %d\n", count, limit);
    return 0;
}
Y en Python, en primes.py:
def is_prime(n):
    if n < 2:
        return False
    d = 2
    while d <= n // d:
        if n % d == 0:
            return False
        d = d + 1
    return True


limit = int(input())
count = 0
for n in range(2, limit + 1):
    if is_prime(n):
        count = count + 1
print(f"Hay {count} primos hasta {limit}")
Se parece mucho al pseudocódigo. Sin saber Python, ya pueden leerlo. Corramos los dos con el mismo límite:
$ echo 100 | build/primes
Hay 25 primos hasta 100
$ echo 100 | python3 primes.py
Hay 25 primos hasta 100
Para seguirlo a mano, veamos is_prime(15) en Python. Es igual que en C:
d |
n // d |
¿d <= n // d? |
n % d |
Qué hace |
|---|---|---|---|---|
| 2 | 7 | sí | 1 | sigue |
| 3 | 5 | sí | 0 | devuelve False |
Qué cambió al leerlo
| En C | En Python | Qué significa |
|---|---|---|
int n, int count |
n, count |
Las variables no declaran tipo. El tipo lo tiene el valor, y se revisa al correr |
{ y } |
: y la sangría |
La sangría es la estructura. Si la cambian, cambia el programa |
; al final |
Nada | El salto de línea termina la instrucción |
return 0; y return 1; |
return False y return True |
Python tiene un tipo propio para verdadero y falso |
for (int n = 2; n <= limit; n++) |
for n in range(2, limit + 1): |
range(a, b) da de a hasta b - 1. Por eso el + 1 |
Un for con índice sobre un arreglo |
for grade in grades: |
Recorre los elementos de una lista, sin índice |
scanf y su revisión |
int(input()) |
input lee una línea, e int la convierte en entero. Si no puede, da un error |
printf("%d", count) |
print(f"{count}") |
Una cadena con f delante reemplaza lo que hay entre llaves |
main |
Nada | El archivo se ejecuta de arriba abajo |
int is_prime(int n) |
def is_prime(n): |
def define una función, sin tipos |
El programa de C tiene el #include y main, que aquí no aparecen. Python no se compila aparte: se corre con
python3 primes.py.
La división no es igual
En C, / depende del tipo de los operandos, como vieron en la semana 2. En Python, / siempre da un número con decimales, y la
división entera es //. Por eso primes.py usa n // d, que corresponde al div del pseudocódigo:
$ build/division
3
3.5
$ python3 division.py
3.5
3
El programa de C calcula 7 / 2 y 7.0 / 2. El de Python, 7 / 2 y 7 // 2. Pasar de un lenguaje a otro sin
mirar esto da errores silenciosos.
¿Cuál es más rápido?
Midamos. La palabra time antes de un comando lo corre y dice cuánto tardó: real es el tiempo de reloj, y user
y sys son el tiempo de CPU usado en el programa y en el sistema operativo.
Hay que medir bien. Los sanitizers agregan revisiones en cada acceso a la memoria y hacen más lento el programa. Por eso el Makefile construye también build/primes_fast, con -O2, que le pide a gcc que
optimice, y sin sanitizers. limit.txt contiene 1000000.
Estos tiempos son de una corrida en la laptop donde se prepararon estos apuntes, y dependen de la máquina. Si los corren dos veces, tampoco saldrán iguales:
$ time build/primes_fast < limit.txt
Hay 78498 primos hasta 1000000

real	0m0.088s
user	0m0.068s
sys	0m0.015s
$ time python3 primes.py < limit.txt
Hay 78498 primos hasta 1000000

real	0m3.627s
user	0m3.512s
sys	0m0.014s
En esta corrida, Python tardó unas 40 veces más. En otra corrida seguida, con la máquina más ocupada, los tiempos fueron 0.226 s y 5.544 s:
unas 25 veces. No es una constante. La versión de build/primes, sin -O2 y con sanitizers, tardó 0.322 s, y aún así mucho menos que Python.
Por qué un ciclo en Python suele ser más lento
Miren d = d + 1. Con -O2, en C eso es típicamente una instrucción de la CPU: gcc ya sabe que d es un int, y cuánto
ocupa. En Python, el intérprete tiene que hacer varias cosas en cada vuelta:
- Leer la siguiente instrucción de bytecode, y decidir qué hacer con ella.
- Buscar qué tipo tiene el valor de
d, que podría ser un entero, un texto o cualquier otra cosa. - Elegir la suma que corresponde a ese tipo, y revisar el resultado.
- Guardar el resultado como un objeto: un entero no es solo su número. También lleva su tipo y otros datos.
Eso último se puede medir. Un int de C ocupa 4 bytes en este entorno. En Python, el tamaño depende de la versión y de la
máquina, y crece con el número:
$ python3 int_size.py
28
40
Son 28 bytes para el 1 y 40 para 2 ** 100, donde ** es la potencia.
Pero no siempre gana C
Ahora una comparación distinta. La misma lista de 50 000 números, ordenada de dos maneras. selection_sort.c usa
ordenamiento por selección, el de la semana 13, compilado con -O2. sort_library.py llama a sorted, de Python. sort_size.txt contiene 50000.
Los tiempos dependen de la máquina:
$ time build/selection_sort_fast < sort_size.txt
menor: 0, mayor: 100001

real	0m2.192s
user	0m2.181s
sys	0m0.002s
$ time python3 sort_library.py < sort_size.txt
menor: 0, mayor: 100001

real	0m0.056s
user	0m0.020s
sys	0m0.003s
No comparen estos 2 s con los de la semana 13. Allá la selección era una función aparte, y este programa la tiene dentro de
main. Con los mismos datos y en una función aparte, aquí tardó unos 0.9 s: el compilador no optimizó igual los dos códigos.
Por eso solo comparamos programas que se midieron igual.
Ganó Python, y por mucho. Hay dos razones. Selección crece como N², y sorted usa un algoritmo que crece mucho más despacio.
Además, sorted no corre en bytecode: está escrito en C, dentro de Python. Es lo mismo que usar qsort en C en vez de
escribir su propio ordenamiento.
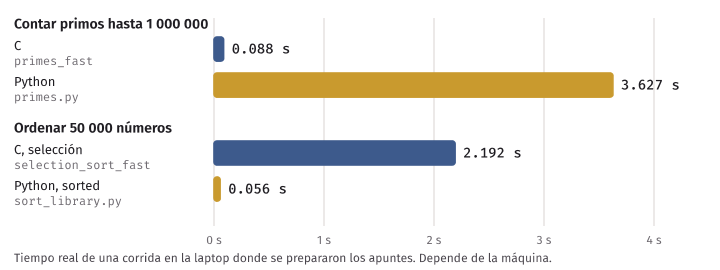
Idea clave. Un mismo ciclo suele ser mucho más lento en Python que en C, y conviene saberlo. Pero el algoritmo importa más que el lenguaje, y muchos programas en Python pasan buena parte del tiempo dentro de bibliotecas escritas en C. Antes de decir que algo es lento, mídanlo.
Qué pasa cuando algo sale mal
La mayor diferencia para quien programa no está en la velocidad, sino en cómo aparecen los errores.
Un índice fuera de rango
errors/index_out.c lee un índice y lo usa sin revisarlo. Lo compilamos sin sanitizers y corremos con el índice 7, en
un arreglo de 5. Como vieron en la semana 9, es comportamiento indefinido. No hubo mensaje de error, y salió un número sin sentido, en
esta corrida:
$ gcc -Wall -Wextra -std=c17 errors/index_out.c -o build/index_out_plain
$ echo 7 | build/index_out_plain
65535
Con sanitizers sí hay aviso, solo porque los agregamos y porque esta ejecución pasó por ahí. El informe está recortado:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/index_out.c -o build/index_out
$ echo 7 | build/index_out
errors/index_out.c:11:26: runtime error: index 7 out of bounds for type 'int [5]'
==93639==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff7cc0005c at pc 0xaaaaaf5a14c8 bp 0xffffe981d8c0 sp 0xffffe981d8d8
READ of size 4 at 0xffff7cc0005c thread T0
El mismo programa en Python, errors/index_out.py. La ruta del archivo está recortada:
$ echo 7 | python3 errors/index_out.py
Traceback (most recent call last):
  File ".../errors/index_out.py", line 4, in <module>
    print(values[index])
          ~~~~~~^^^^^^^
IndexError: list index out of range
Python revisa el índice en cada acceso, siempre. Es parte de lo que cuesta su ciclo. El error dice el archivo, la línea y la causa, y el programa se detiene antes de leer memoria ajena. En C, esa revisión es responsabilidad de quien programa.
Cuidado, porque revisar no significa que todo índice raro sea un error. En Python, un índice negativo cuenta desde el final. El
mismo -1 que en C es un error, en Python es válido:
$ echo -1 | python3 errors/index_out.py
20
Un entero que no cabe
En la semana 3 vieron que un int tiene un tamaño fijo. Si un cálculo con signo se sale del rango, es comportamiento indefinido. factorial.c
lee n de la entrada para que UBSan pueda vigilarlo al correr. Con 12 cabe. Con 13 no, y el número que aparece después del aviso está mal, en esta corrida:
$ echo 12 | build/factorial
12! = 479001600
$ echo 13 | build/factorial
factorial.c:12:16: runtime error: signed integer overflow: 479001600 * 13 cannot be represented in type 'int'
13! = 1932053504En Python, los enteros crecen todo lo que haga falta. No hay overflow en este sentido, mientras haya memoria:
$ echo 13 | python3 factorial.py
13! = 6227020800
$ echo 25 | python3 factorial.py
25! = 15511210043330985984000000
Un detalle que van a encontrar si prueban números muy grandes: el cálculo funciona, pero Python se niega por defecto a convertir
a texto un entero de más de 4300 dígitos. Con 2000 el programa termina en un ValueError que lo explica. Es un límite
de impresión, no un overflow.
Un error de tipos
C revisa los tipos al compilar. Python lo descubre al correr, y solo si llega a esa línea. La última línea de
errors/late_error.py (cuya primera línea es un comentario, que aquí no se muestra) suma un número y un texto:
n = int(input())
if n > 0:
    print("positivo")
else:
    print(n + "x")
$ echo 5 | python3 errors/late_error.py
positivo
$ echo -1 | python3 errors/late_error.py
Traceback (most recent call last):
File ".../errors/late_error.py", line 6, in <module>
print(n + "x")
~~^~~~~
TypeError: unsupported operand type(s) for +: 'int' and 'str'Con la entrada 5 el programa parece perfecto, y el bug sigue ahí. Las pruebas importan más cuanto menos revisa el compilador.
Un texto y sus letras
$ build/text_length
4
$ python3 text_length.py
3
4
strlen("año") cuenta bytes, como saben. En Python, len("año") cuenta caracteres, y encode da los 4 bytes en UTF-8. Los bytes no
desaparecieron. Python se encarga de ellos.
Lo que alguien resolvió por debajo
Durante 13 semanas lucharon con detalles que en Python no aparecen, aunque siguen ahí: el propio python3 es, en su mayor parte, un
programa escrito en C, y alguien ya los resolvió allí:
| En C, ustedes | En Python |
|---|---|
Declaran un arreglo con capacidad fija y llevan n aparte (semanas 9 y 10) |
Una lista conoce su tamaño, y crece con append |
| Pasan la longitud a cada función, porque un arreglo se pasa como dirección | len(lista) funciona en cualquier lugar |
Terminan las cadenas en '\0' y cuidan el tamaño del buffer |
Un texto sabe su largo, y no hay '\0' que cuidar |
Comparan cadenas con strcmp, porque == compara direcciones |
== compara el contenido |
Revisan el resultado de scanf, fgets y fopen |
Si algo falla y nadie lo maneja, un error detiene el programa |
| Revisan los índices, o usan sanitizers | Cada acceso se revisa |
Eso no es gratis. Se paga con velocidad, con memoria, y con errores que aparecen al correr en vez de al compilar. Y entender esa
cuenta es justo lo que ustedes pueden hacer ahora: saben qué es un arreglo en memoria, y por eso pueden imaginar qué tiene
que hacer append cuando se acaba el espacio.
Idea clave. Python es cómodo porque alguien resolvió por debajo lo que ustedes ya vieron en C. Por eso aprendimos C primero: lo que está debajo de cualquier otro lenguaje ya no es un misterio.
El laboratorio
El laboratorio tiene tres partes. Ninguna necesita internet: todo pasa en 127.0.0.1. Si no pueden abrir un codespace
por falta de conexión, trabajen con Docker en una laptop, con la imagen ya construida.
1. Ver HTTP por dentro
Levanten el servidor en una terminal con python3 server.py, y desde otra corran curl -v http://127.0.0.1:8014/saludo. En
su salida identifiquen la línea de petición, los encabezados que mandó curl, el código de estado, los encabezados de la
respuesta y el cuerpo. Después miren en la primera terminal qué anotó el servidor.
2. El 404, y resumir respuestas con C
Pidan /nada y /error, y comparen los códigos. Después van a escribir un programa propio en C: lab/http_status.c lee una respuesta
HTTP de la entrada y la resume. Junta lo que vieron en las semanas 11 y 12 con el formato de hoy. El -i de curl manda
los encabezados a la salida, y el | se la pasa a su programa. Debe funcionar así:
$ curl -si http://127.0.0.1:8014/saludo | build/lab/http_status
código: 200
clase: 2xx
encabezados: 4
cuerpo: 20 bytes
El algoritmo es este. es_linea_vacia compara con \r\n y con \n:
algoritmo resumir_respuesta()
    si no se pudo leer linea entonces
        escribir "La entrada está vacía"
        devolver 1
    fin si
    codigo ← codigo_de_estado(linea)
    si codigo = -1 entonces
        escribir "No es una respuesta HTTP"
        devolver 1
    fin si
    encabezados ← 0
    mientras se pudo leer linea y no es_linea_vacia(linea) hacer
        encabezados ← encabezados + 1
    fin mientras
    bytes ← 0
    mientras se pudo leer linea hacer
        bytes ← bytes + longitud(linea)
    fin mientras
    escribir "código: ", codigo
    escribir "clase: ", codigo div 100, "xx"
    escribir "encabezados: ", encabezados
    escribir "cuerpo: ", bytes, " bytes"
    devolver 0
fin algoritmo
El archivo ya trae main, con la lectura de la primera línea y lo que se escribe al final. Falta lo marcado con TAREA:
parse_statusrecibe la primera línea. Devuelve el código, o -1 si la línea no tiene la forma correcta.sscanfpuede llevar texto fijo en el formato, que debe coincidir tal cual. Así quesscanf(line, "HTTP/%15s %d", version, &code)exige que la línea empiece conHTTP/, guarda hasta 15 bytes de la versión en unchar version[16], y luego lee un entero. Revisen que devuelva 2. También debe rechazar los códigos fuera de 100 a 599.is_blank_linedice si una línea está vacía. Recuerden que HTTP usa\r\n. Si solo comparan con\n, una respuesta real nunca tendrá una línea vacía, y contarán el cuerpo como si fueran encabezados.- Los dos ciclos de
mainconfgets. El primero cuenta encabezados, y se detiene en la primera línea vacía, sin contarla. El segundo suma constrlenlos bytes de lo que queda. Sumen bytes, no líneas: una línea más larga que el buffer llega en varios pedazos. Una línea vacía dentro del cuerpo también es cuerpo.
Las líneas del encabezado deben caber en LINE_SIZE. Una más larga se contaría dos veces. Para este laboratorio lo aceptamos, y es la pregunta 4 del
repaso de la semana 12.
Prueben sin servidor, con printf, que escribe el \r que ustedes le pidan. Así no dependen de nada más:
$ printf 'HTTP/1.1 404 Not Found\r\nA: 1\r\n\r\nhola\n' | build/lab/http_status
código: 404
clase: 4xx
encabezados: 1
cuerpo: 5 bytes
Se compila con make build/lab/http_status, y se comprueba con make test-lab. Las pruebas levantan su propio servidor,
en un puerto libre, así que no hace falta tener uno corriendo. Python no se evalúa: de primes.py solo comprueban que corre y que coincide con C.
3. Comparar C con Python
Corran build/primes_fast y primes.py con time, usando limit.txt, como arriba. Anoten en un comentario, al final de lab/http_status.c,
qué líneas cambiaron entre los dos programas y cuántas veces más tardó Python en su máquina. Corran cada uno dos veces para ver cuánto varía el tiempo.
Si quieren ir más allá, repitan el experimento del espía con HTTP y con HTTPS. Las pruebas de make test hacen lo mismo y lo comprueban.
La Práctica 4
Esta semana, la sesión de laboratorio es para la Práctica 4. El laboratorio de arriba es trabajo autónomo y sus temas
entran en el examen final. La práctica cubre struct, archivos, búsqueda y eficiencia, de las semanas 12 y 13.
Los temas de internet y Python de este capítulo no entran. El formato y las reglas están en
practicas/README.md.
Resumen
- Internet es una red de redes. Los datos viajan en paquetes, con direcciones IP, y cada router decide solo el siguiente
salto.
127.0.0.1es la propia computadora: esos paquetes no salen a la red. - IP no garantiza la entrega. TCP abre una conexión, reenvía lo perdido y entrega los bytes en orden. El puerto dice a qué programa van.
- DNS traduce nombres a direcciones IP, pregunta por partes y guarda las respuestas en una cache.
- HTTP es petición y respuesta. HTTP/1.1 es texto: línea de petición o de estado, encabezados terminados en
\r\n, línea vacía y cuerpo. HTTP/2 es binario, y HTTP/3 corre sobre QUIC. - Códigos de estado: 200 funcionó, 404 el cliente pidió algo que no existe, 500 falló el servidor. Sin servidor no hay código.
- HTTPS es HTTP sobre TLS. Protege la ruta, los encabezados y el contenido en el camino, y el certificado confirma el nombre. Quedan a la vista las IP, los puertos, normalmente el nombre del sitio, el momento y la cantidad de datos. No dice si el sitio es honesto.
- Al abrir una página: DNS, TCP, TLS, HTTP.
gcccompila C a código máquina.python3traduce a bytecode y lo interpreta. Esas palabras describen la herramienta, no el lenguaje.- En Python no se declaran tipos, la sangría es estructura,
/da decimales y//es la división entera. - Un ciclo en Python suele ser más lento que en C, porque en cada paso revisa tipos y maneja objetos. Pero el algoritmo pesa más:
sortedle ganó a selección en C. Medir sin sanitizers, y sabiendo que los tiempos dependen de la máquina. - En C, un índice fuera de rango es comportamiento indefinido y puede no dar aviso. En Python da
IndexError, y un índice negativo cuenta desde el final. Los enteros de Python no tienen overflow. Los errores de tipos aparecen al correr esa línea. - Python es cómodo porque alguien resolvió por debajo lo que ustedes vieron en C.
Ejercicios
-
Ordenen lo que pasa al abrir
https://example.com/: TLS, DNS, HTTP y TCP. Para cada paso, digan qué necesita del anterior. -
¿Qué significan 200, 404 y 500? Para 404 y 500, digan si conviene revisar el pedido o avisar a quien administra el sitio. ¿Qué ven si el servidor está apagado? Compruébenlo deteniendo
server.pyy pidiendo concurl -sS -i. -
Escriban en orden las líneas de texto que manda un cliente HTTP/1.1 para pedir
/notasen el sitioexample.com, sin encabezados opcionales. ¿En qué se reconoce el final de la petición? -
El cuerpo de una respuesta es
año 2026, seguido de un salto de línea. ¿Qué valor llevaContent-Length? Cuenten a mano. -
En una red ajena abren
https://example.com/notascon su cookie de sesión. ¿Qué de esto puede ver quien administra la red: la IP del sitio, la ruta, la cookie, el nombreexample.com, la cantidad de bytes? ¿Cambia si eshttp://? Justifiquen con lo que mostróspy.py. -
Un sitio aparece como seguro en el navegador y pide su contraseña del banco. El nombre del sitio se parece al del banco, pero no es igual. ¿Qué asegura el candado, y qué no?
-
Sigan a mano
is_prime(25)enprimes.py, con una tabla como la deis_prime(15). ¿Qué pasaría con 25 si la condición delwhilefuerad < n // d? -
Lean este programa en Python. Sin correrlo, digan qué escribe, y escríbanlo en C:
grades = [14, 9, 17, 11, 20] count = 0 for grade in grades: if grade >= 11: count = count + 1 print(count) -
Corran
errors/index_out.pycon los índices 4, 5, -1, -5 y -6. Antes de cada uno, digan qué esperan. ¿Cuáles de esos valores serían comportamiento indefinido enerrors/index_out.c? -
¿Por qué
echo 13 | build/factorialda un aviso de UBSan yecho 13 | python3 factorial.pyno? ¿Qué le costó a Python evitarlo? -
Copien
limit.txta otro archivo, cambien el límite a2000000, y midanbuild/primes_fastyprimes.py. ¿Cuántas veces más tarda cada uno que con1000000? ¿Sale la misma razón entre C y Python? ¿Qué parte de su respuesta depende de su máquina? -
En una copia de
lab/http_status.c, para no cambiar lo que revisamake test-lab, agreguen una línea que diga si el cuerpo mide lo que anuncia el encabezado. Pista: lean el número consscanf(line, "Content-Length: %d", &announced), dentro del ciclo de encabezados. Pruébenlo con/saludo, y con una respuesta escrita por ustedes en la que mienta.