Apuntes · Capítulo 15Computación moderna
Inteligencia artificial y ética
Inteligencia artificial y ética
La semana pasada vieron cómo viaja la información por internet y dieron una primera mirada a Python. Hoy cerramos el curso con el tema del que más se habla: la inteligencia artificial (IA), el campo que construye programas para tareas que asociamos con la inteligencia, como reconocer spam, traducir o conversar.
Durante todo el curso, ustedes escribieron las reglas de sus programas. Hoy veremos programas cuyas reglas salen de los datos. Seguiremos a mano cuatro ejemplos pequeños: un filtro de spam, un modelo que se equivoca por memorizar, una neurona artificial y un modelo de lenguaje de juguete. Con ellos podrán responder tres preguntas: en qué se diferencia programar de entrenar, por qué un modelo se evalúa con datos que no vio, y por qué un asistente puede inventar una respuesta y darla con seguridad.
Después viene lo que no se resuelve con un programa: el sesgo, la privacidad y la responsabilidad de quien construye o usa estos sistemas. En el laboratorio harán la única actividad del curso donde se permite usar IA generativa, y su habilidad central es una que ya tienen: comprobar una respuesta con pruebas.
Lectura. El código de este capítulo está en
code/week-15. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Estos programas no son para escribirlos: están para que los números del capítulo se puedan comprobar. Lo importante es seguir las ideas a mano.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Dos formas de resolver un problema” y “Entrenar un modelo, a mano”. Es lo mínimo para seguir la clase.
- En clase: “Evaluar con datos que el modelo no vio”, “Una red neuronal: muchos pesos que se ajustan”, “Qué hace un LLM: predecir el siguiente token”, “Por qué responde con seguridad aunque esté equivocado”, “Por qué los fundamentos siguen importando” y “Ética: el software afecta a personas”.
- Después de clase: para el laboratorio, “El laboratorio: comprobar antes de creer”; para repasar, “Repaso para el examen final”, “Resumen” y “Ejercicios”. Opcional: “Qué sigue en la carrera”.
Dos formas de resolver un problema
Queremos separar el correo no deseado, o spam, del correo normal. Un programa como los que ya saben escribir usaría reglas pensadas por una persona:
algoritmo es_spam_con_reglas(palabras)
    si palabras ≥ 2 entonces
        devolver 1
    fin si
    devolver 0
fin algoritmo
Aquí palabras es cuántas palabras sospechosas trae el correo, como “premio” o “gratis”. El 2 lo
escogió alguien, por intuición. Si esa persona se equivoca, o si los correos cambian con el tiempo,
alguien tiene que volver a pensar la regla.
La otra forma es machine learning: dar datos de ejemplo a un programa, para que busque en ellos la regla.
| Programar reglas | Machine learning | |
|---|---|---|
| Quién fija la regla | Una persona | Un programa, a partir de ejemplos |
| Qué hace falta | Entender el problema hasta poder escribirlo | Muchos ejemplos buenos, con su respuesta |
| Cómo se corrige | Cambiando el código | Cambiando los datos o el modelo, y entrenando otra vez |
| Se puede explicar | Se lee la regla | Depende del modelo; a veces es muy difícil |
| Cuándo conviene | La regla se puede escribir con claridad, como el IGV | Es difícil escribir la regla, como reconocer una voz |
Ninguna columna gana siempre. No tiene sentido entrenar un modelo para calcular el IGV: la regla exacta ya se conoce, y un modelo solo agregaría errores.
Tres palabras más antes de seguir:
- Un modelo (model) es lo que decide: una función con números que se pueden ajustar.
- El entrenamiento (training) es ajustar esos números con ejemplos.
- Un dataset es un conjunto de datos de ejemplo.
Si cada ejemplo trae su respuesta correcta, o etiqueta, se habla de aprendizaje supervisado (supervised learning). Es el único tipo de machine learning que veremos en detalle.
Idea clave. Programando, ustedes escriben la regla y la computadora la aplica. Entrenando, ustedes dan ejemplos con su respuesta y la computadora busca una regla. En los dos casos, el resultado es un programa que puede estar mal.
Entrenar un modelo, a mano
Nuestro modelo será el más simple posible: un umbral u. Un correo es spam si tiene u
palabras sospechosas o más. Entrenarlo es elegir u. Estos son los 11 correos de entrenamiento,
inventados para el ejemplo:
| Palabras sospechosas | 0 | 0 | 1 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| ¿Es spam? | no | no | no | no | no | no | sí | sí | no | sí | sí |
El correo con 6 palabras que no es spam está en negrita. Digamos que es un boletín de ofertas que alguien sí pidió. Los datos reales traen casos así.
El algoritmo prueba cada umbral, cuenta sus errores y se queda con el mejor. En un empate, se queda con el primero que encontró:
algoritmo contar_errores(correos, n, u)
    errores ← 0
    para i desde 0 hasta n - 1 hacer
        respuesta ← (correos[i].palabras ≥ u)
        si respuesta ≠ correos[i].etiqueta entonces
            errores ← errores + 1
        fin si
    fin para
    devolver errores
fin algoritmo

algoritmo entrenar_umbral(correos, n)
    mejor_u ← 0
    menos_errores ← contar_errores(correos, n, 0)
    para u desde 1 hasta 9 hacer
        errores ← contar_errores(correos, n, u)
        si errores < menos_errores entonces
            menos_errores ← errores
            mejor_u ← u
        fin si
    fin para
    devolver mejor_u
fin algoritmo
La comparación correos[i].palabras ≥ u da 1 si es verdadera y 0 si no, igual que en C.
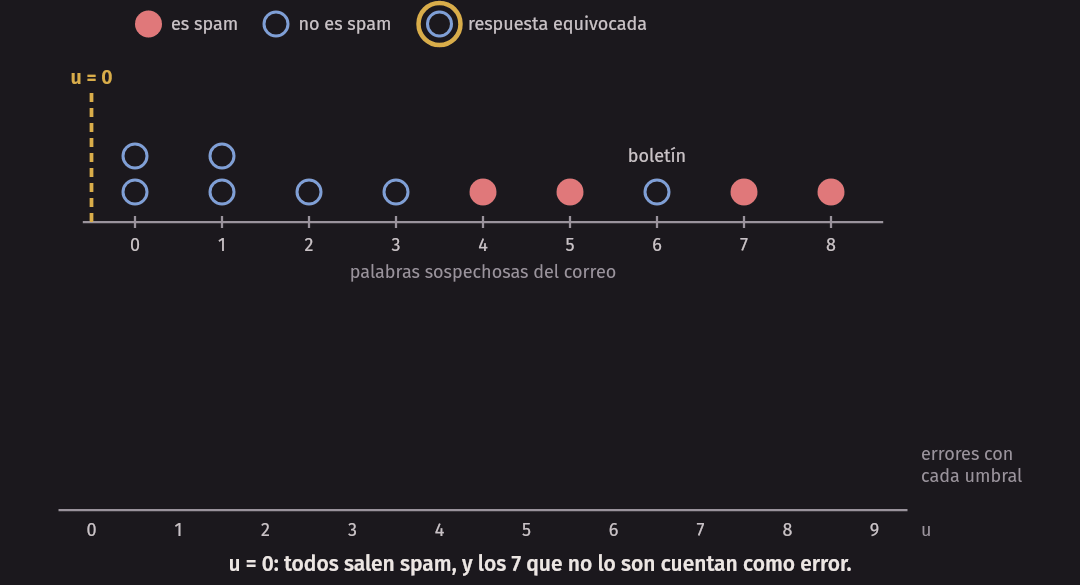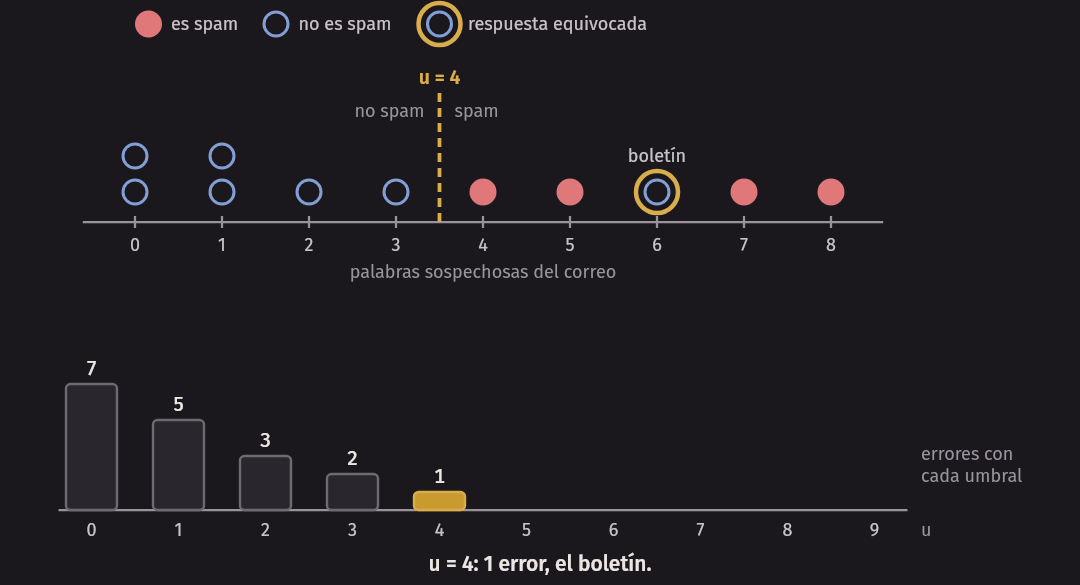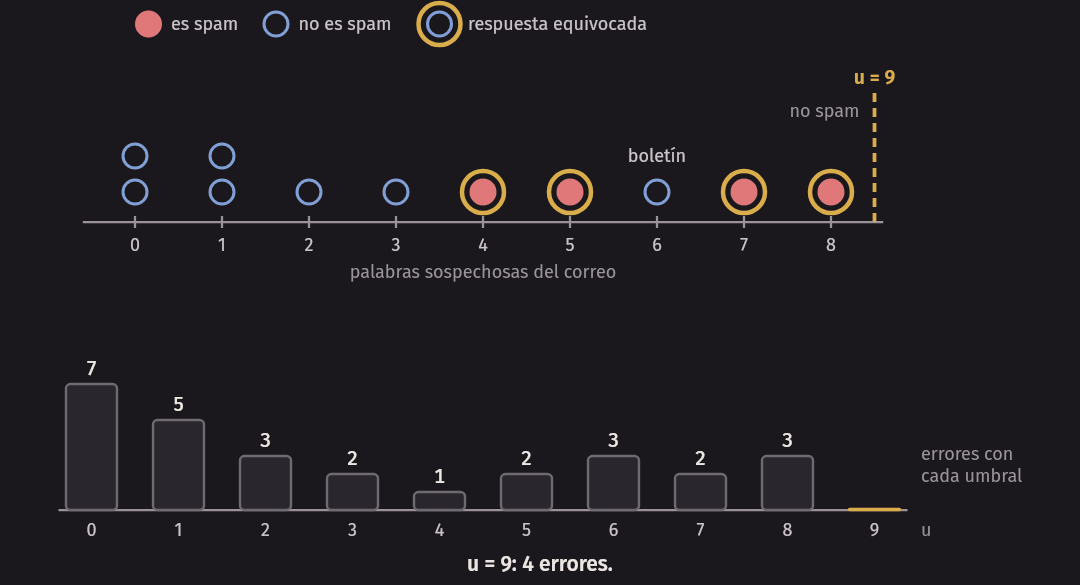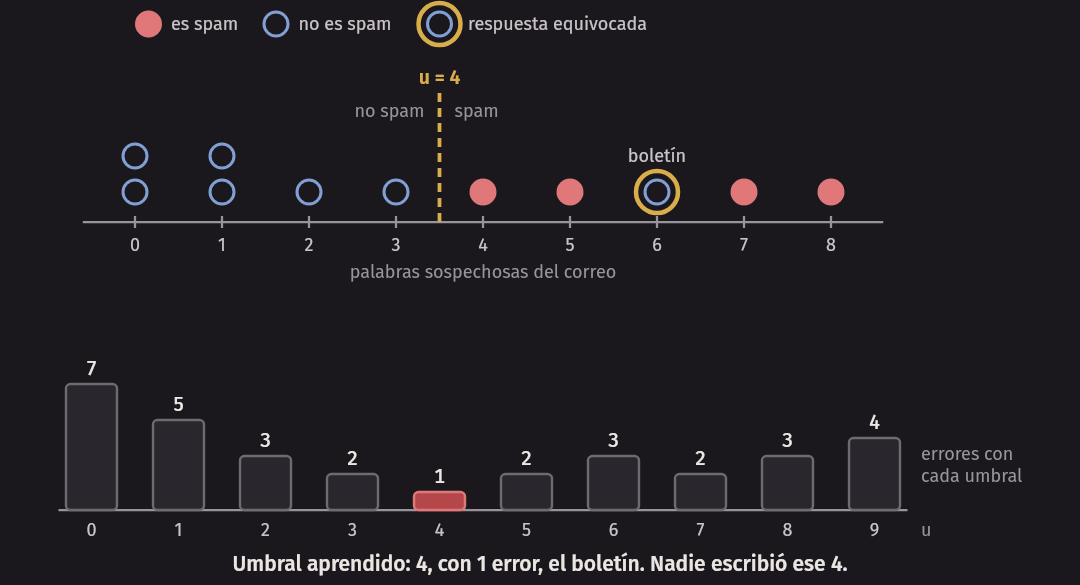
Sigan a mano u = 4. Todos los correos con menos de 4 palabras quedan como “no spam”, y aciertan.
Los de 4 o más quedan como spam: aciertan todos, salvo el boletín. Es un solo error. Con u = 3 hay
dos: el correo de 3 palabras, que no es spam, y el boletín. Con u = 5 también hay dos: el correo
de 4 palabras, que sí es spam, y el boletín.
En C, spam_models.c usa un arreglo de struct, como en la semana 12:
struct mail {
    int words;   // palabras sospechosas
    int spam;    // la etiqueta: 1 si es spam, 0 si no
};
int train_threshold(const struct mail mails[], int n) {
int best_u = 0;
int best_errors = errors_threshold(mails, n, 0);
for (int u = 1; u <= MAX_WORDS; u++) {
int errors = errors_threshold(mails, n, u);
if (errors < best_errors) {
best_errors = errors;
best_u = u;
}
}
return best_u;
}Corrámoslo. Por ahora miren solo la primera parte:
$ build/spam_models
Errores en entrenamiento según el umbral
u = 0: 7
u = 1: 5
u = 2: 3
u = 3: 2
u = 4: 1
u = 5: 2
u = 6: 3
u = 7: 2
u = 8: 3
u = 9: 4
Umbral aprendido: 4

Modelo                  entrenamiento     prueba
Regla a mano (u = 2)             3/11        2/8
Umbral aprendido                 1/11        1/8
Memorizador                      0/11        3/8
Nadie escribió el 4 en el programa. Salió de los datos, y con otros datos saldría otro. Esa es toda la diferencia con la regla de arriba, donde el 2 lo eligió una persona. “Aprender”, en machine learning, significa esto: ajustar números para cometer menos errores en los ejemplos. No hay que imaginar nada más.
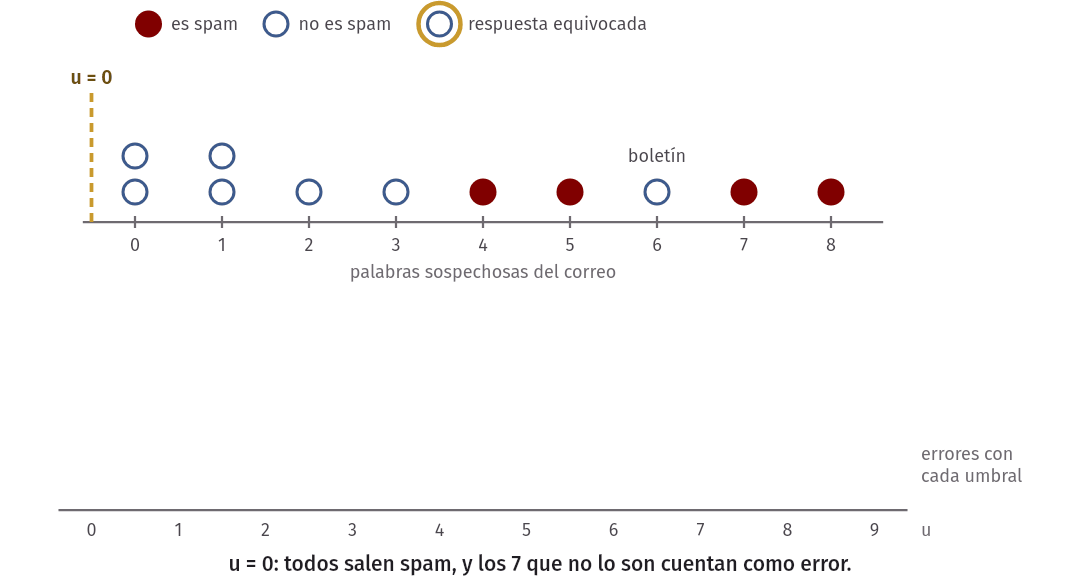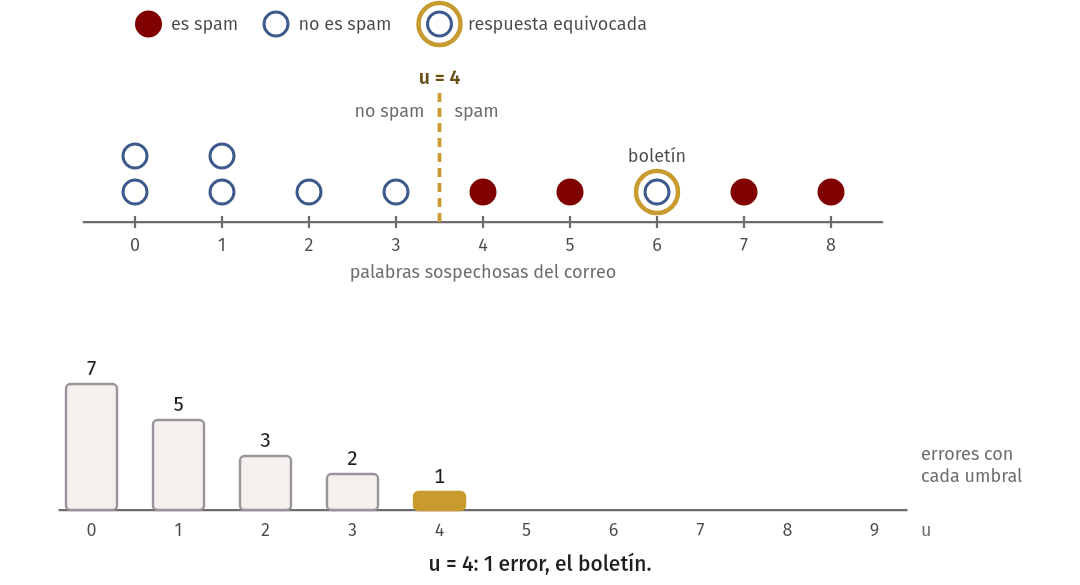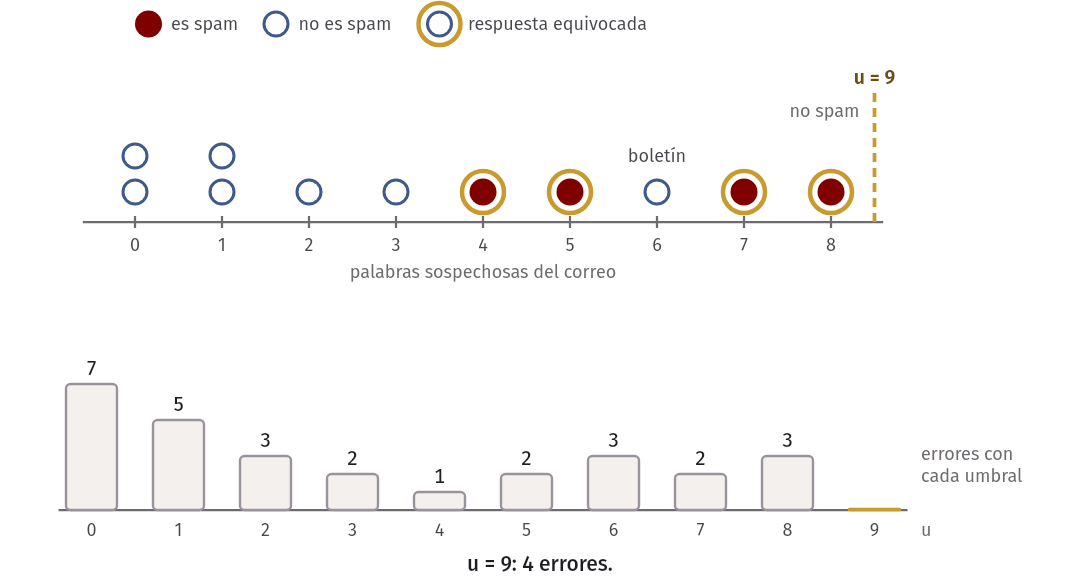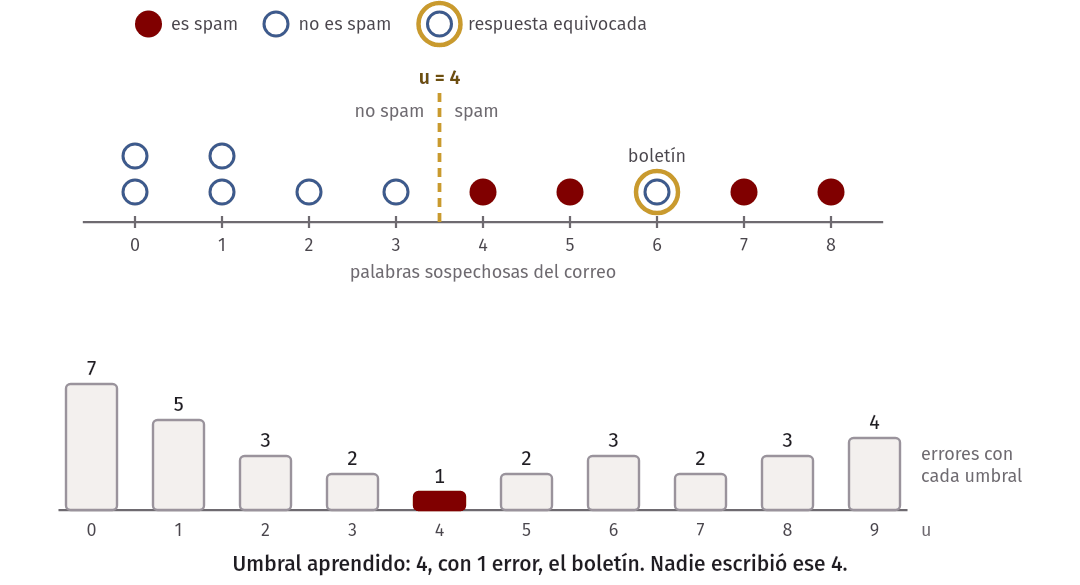
Un filtro real no mira un solo número. Mira muchas señales, y ajusta muchos números en lugar de uno. Pero el esquema es el mismo: ejemplos, una medida del error, y un ajuste que la baja.
Evaluar con datos que el modelo no vio
Ahora la segunda parte de la salida. Las dos columnas cuentan errores, pero en correos distintos. La primera usa los 11 correos de entrenamiento. La segunda usa 8 correos que apartamos antes de entrenar, llamados datos de prueba:
| Palabras sospechosas | 0 | 1 | 2 | 2 | 3 | 4 | 6 | 6 |
|---|---|---|---|---|---|---|---|---|
| ¿Es spam? | no | no | no | no | sí | sí | sí | sí |
La tercera fila de esa salida es un modelo nuevo, el memorizador. Guarda todos los correos de entrenamiento. Para un correo nuevo, busca el más parecido entre los guardados y copia su etiqueta. En un empate, usa el primero que encontró:
algoritmo memorizador(entrenamiento, n, palabras)
    mejor ← 0
    menor_distancia ← -1
    para i desde 0 hasta n - 1 hacer
        distancia ← valor absoluto de (entrenamiento[i].palabras - palabras)
        si menor_distancia = -1 o distancia < menor_distancia entonces
            menor_distancia ← distancia
            mejor ← i
        fin si
    fin para
    devolver entrenamiento[mejor].etiqueta
fin algoritmo| Modelo | Errores en entrenamiento | Errores en prueba |
|---|---|---|
Regla a mano (u = 2) |
3 de 11 | 2 de 8 |
Umbral aprendido (u = 4) |
1 de 11 | 1 de 8 |
| Memorizador | 0 de 11 | 3 de 8 |
Si solo miráramos el entrenamiento, el memorizador parecería perfecto. Claro: cada correo se encuentra a sí mismo entre los guardados. Pero miren qué pasa con los correos nuevos de 6 palabras, que sí son spam. El memorizador recuerda al boletín, y responde “no spam” las dos veces. También falla con el de 3 palabras. El umbral solo falla con ese último.
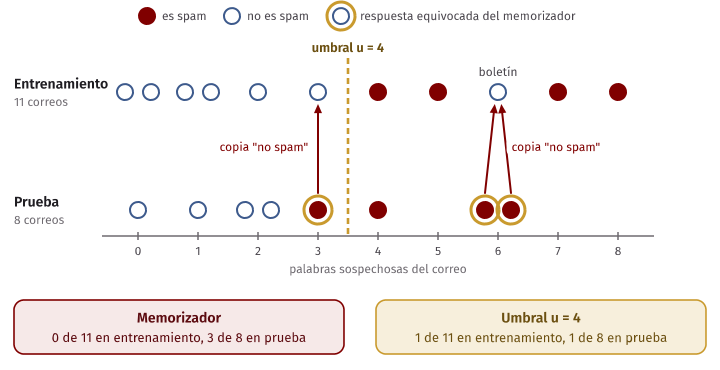
Esto se llama overfitting o sobreajuste: el modelo se ajusta tanto a sus datos de entrenamiento, incluidas sus rarezas, que le va peor con datos nuevos. El memorizador aprendió de memoria al boletín, en vez de aprender que muchas palabras sospechosas suelen indicar spam.
Es lo mismo que estudiar un examen memorizando las respuestas de la práctica. Con las mismas preguntas se saca 20, y esa nota no dice nada sobre lo que pasará con preguntas nuevas. Por eso los datos se separan antes de entrenar:
| Conjunto | Para qué sirve | Cuándo se usa |
|---|---|---|
| Entrenamiento | Ajustar el modelo | Durante el entrenamiento |
| Prueba | Estimar cómo le irá con datos nuevos | Al final |
Idea clave. Un modelo se evalúa con datos que no vio, porque lo que importa es cómo le irá con los casos nuevos. El error en los datos de entrenamiento puede ser muy bajo solo porque el modelo los memorizó.
Error común. Probar el modelo con los datos de prueba, cambiarlo, volver a probar, y repetir hasta que salga bien. Así los datos de prueba terminan influyendo en el modelo, y ya no son datos que no vio. El resultado sale demasiado optimista.
Dos límites de este ejemplo, para no sacar más conclusiones de la cuenta:
- Con 8 correos, la diferencia entre 1 y 3 errores es poca evidencia. Son pocos datos para poder seguirlos a mano. Una evaluación seria usa muchos más.
- Una buena nota en prueba no es una garantía. Si los correos del futuro son distintos de los que reunimos, por ejemplo porque quienes envían spam cambian de palabras, el modelo puede empeorar.
Una red neuronal: muchos pesos que se ajustan
El umbral tiene un solo número que ajustar. Veamos un modelo que se parece más a los que se usan
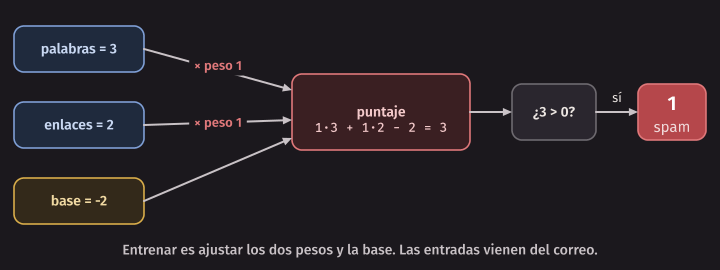
hoy. Una neurona artificial recibe varios números, multiplica cada uno por un peso (weight),
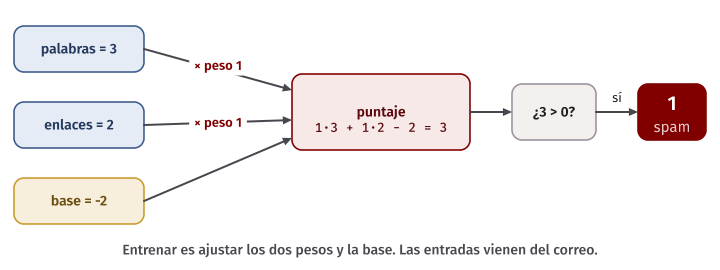
suma todo con un número más, que no depende de las entradas y que llamaremos base, y responde 1 si el puntaje sale mayor que 0.
Con dos entradas:
puntaje = peso_palabras × palabras + peso_enlaces × enlaces + baseEl peso dice cuánto importa cada entrada. Un peso grande y positivo empuja hacia el spam, y uno negativo empuja en contra. Se llama neurona porque la idea se inspiró de lejos en las neuronas del cerebro, pero no es un modelo de cómo funciona un cerebro: es aritmética.
¿De dónde salen los pesos? Aquí empiezan en 0, y cada error los mueve un poco. Este es uno de los ajustes más antiguos, el del perceptrón:
algoritmo entrenar_neurona(correos, n)
    peso_palabras ← 0
    peso_enlaces ← 0
    base ← 0
    errores ← 1
    mientras errores > 0 hacer
        errores ← 0
        para i desde 0 hasta n - 1 hacer
            puntaje ← peso_palabras × correos[i].palabras + peso_enlaces × correos[i].enlaces + base
            respuesta ← (puntaje > 0)
            cambio ← correos[i].etiqueta - respuesta
            si cambio ≠ 0 entonces
                errores ← errores + 1
            fin si
            peso_palabras ← peso_palabras + cambio × correos[i].palabras
            peso_enlaces ← peso_enlaces + cambio × correos[i].enlaces
            base ← base + cambio
        fin para
    fin mientras
fin algoritmo
Si la neurona acierta, cambio vale 0 y nada se mueve. Si dijo 0 y era 1, cambio vale +1, y los
pesos suben en proporción a las entradas. Si dijo 1 y era 0, bajan. neuron.c agrega un límite de
10 vueltas por seguridad, porque este ciclo solo termina si existen pesos que aciertan todos los
ejemplos. Con estos cuatro correos (palabras, enlaces), existen:
$ build/neuron
vuelta correo  puntaje resp etiq  w_pal w_enl  base
     1 (3,2)        0    0    1      3     2     1
     1 (1,0)        4    1    0      2     2     0
     1 (2,2)        8    1    1      2     2     0
     1 (0,1)        2    1    0      2     1    -1
     2 (3,2)        7    1    1      2     1    -1
     2 (1,0)        1    1    0      1     1    -2
     2 (2,2)        2    1    1      1     1    -2
     2 (0,1)       -1    0    0      1     1    -2
     3 (3,2)        3    1    1      1     1    -2
     3 (1,0)       -1    0    0      1     1    -2
     3 (2,2)        2    1    1      1     1    -2
     3 (0,1)       -1    0    0      1     1    -2
Vueltas: 3. Errores en la última: 0
Cada fila muestra el puntaje y la respuesta con los pesos que había antes, y los pesos después del ajuste. Sigan las dos primeras filas:
| Correo | Puntaje | Respuesta | Etiqueta | cambio |
Nuevos pesos y base |
|---|---|---|---|---|---|
| (3, 2) | 0·3 + 0·2 + 0 = 0 | 0 | 1 | +1 | 0+3 = 3, 0+2 = 2, 0+1 = 1 |
| (1, 0) | 3·1 + 2·0 + 1 = 4 | 1 | 0 | -1 | 3-1 = 2, 2-0 = 2, 1-1 = 0 |
En la tercera vuelta ya no hay ningún error. Los pesos finales dicen: palabras y enlaces valen igual, y hacen falta más de 2 entre los dos para llamarlo spam. Nadie escribió esa regla.
Por qué capas
Una sola neurona tiene límites. La más conocida es XOR, la compuerta de la semana 4: da 1 cuando a
y b son distintos. Una neurona con dos entradas no puede calcularla. Con varias neuronas en capas,
sí: las dos primeras calculan OR y NAND (NOT AND), y una tercera hace el AND de esas dos salidas.
Eso ya es una pequeña red neuronal (neural network): neuronas cuyas salidas son las entradas de
otras. Aquí escribimos los pesos a mano, para que se puedan seguir. network.c también prueba una
sola neurona con todos los pesos enteros de -3 a 3, y ninguna combinación lo logra:
$ build/network
a b  or nand  salida
0 0   0    1       0
0 1   1    1       1
1 0   1    1       1
1 1   1    0       0
Una sola neurona: 0 de 343 combinaciones de pesos dan XOR
Esa búsqueda solo cubre esos pesos. Pero tampoco hay otros: el ejercicio 6 les pide probarlo para cualquier peso.
Las redes que se usan hoy son esta misma idea a una escala enorme, con dos diferencias técnicas. Sus neuronas dan números graduales en vez de solo 0 o 1, y sus pesos no se ajustan con la regla de arriba, sino con un método que usa derivadas y se estudia en cursos posteriores. Lo que hay que retener no cambia.
Idea clave. Una red neuronal es una función con muchos pesos. Entrenar es ajustar esos pesos para cometer menos errores en los ejemplos. Por eso lo que aprende depende de los datos que recibió.
Qué hace un LLM: predecir el siguiente token
Un LLM (large language model, modelo grande de lenguaje) es un modelo entrenado con muchísimo texto para una tarea que se enuncia en una línea: dado un texto, predecir qué viene después.
No trabaja con letras ni necesariamente con palabras, sino con tokens, fragmentos de texto: una palabra corta, o un pedazo de una larga. Genera una respuesta prediciendo un token, agregándolo al texto, y prediciendo el siguiente otra vez.
Podemos construir un modelo de juguete con lo que saben de C. Será lo más simple posible: los tokens
son palabras separadas por espacios, y para predecir, solo se mira la última palabra. Entrenar es
contar qué palabra viene después de cada una. Este es todo su texto de entrenamiento, en
corpus.txt. Las personas y los artículos son inventados:
$ cat corpus.txt
la capital de perú es lima .
la capital de chile es santiago .
la capital de colombia es bogotá .
la ciudad más poblada de perú es lima .
garcía publicó un artículo sobre redes en 2019 .
flores publicó un artículo sobre redes en 2019 .
quispe publicó un artículo sobre memoria en 2021 .
Después de es, por ejemplo, aparecen lima dos veces, santiago una y bogotá una. Al continuar
un texto, el modelo elige la palabra más frecuente, y en un empate la que apareció primero:
algoritmo siguiente(pares, n, palabra)
    mejor ← -1
    para i desde 0 hasta n - 1 hacer
        si pares[i].primera = palabra entonces
            si mejor = -1 o pares[i].cuenta > pares[mejor].cuenta entonces
                mejor ← i
            fin si
        fin si
    fin para
    devolver mejor
fin algoritmo

algoritmo continuar(pares, n, palabra)
    actual ← palabra
    pasos ← 0
    mientras actual ≠ "." y pasos < 12 hacer
        mejor ← siguiente(pares, n, actual)
        si mejor = -1 entonces
            escribir "[sin datos]"
            devolver
        fin si
        escribir pares[mejor].segunda
        actual ← pares[mejor].segunda
        pasos ← pasos + 1
    fin mientras
fin algoritmo
La función de C que elige:
int most_frequent(const struct pair pairs[], int n, const char word[]) {
    int best = -1;
    for (int i = 0; i < n; i++) {
        if (strcmp(pairs[i].first, word) == 0) {
            if (best == -1 || pairs[i].count > pairs[best].count) {
                best = i;
            }
        }
    }
    return best;
}
Pidamos que continúe tres textos. next_token lee uno por línea. Antes de cada resultado escribe
las cuentas de la última palabra:
$ printf 'la capital de perú es\nla capital de chile es\nla capital de ecuador es\n' | build/next_token
tras "es": lima 2/4 santiago 1/4 bogotá 1/4
la capital de perú es lima .
tras "es": lima 2/4 santiago 1/4 bogotá 1/4
la capital de chile es lima .
tras "es": lima 2/4 santiago 1/4 bogotá 1/4
la capital de ecuador es lima .
Paren a mirar esto. La primera respuesta es correcta. La segunda es falsa, aunque el dato está en el
texto de entrenamiento. La tercera también, sobre un país que nunca vio. Las tres salen igual,
por el mismo mecanismo y con las mismas cuentas. El 2/4 tampoco es la probabilidad de que la frase
sea cierta: dice con qué frecuencia venía lima después de es en ese texto. El programa no tiene
ninguna variable para “esto es verdad”.
Un LLM real es muchísimo mejor que este juguete:
| Modelo de juguete | LLM real |
|---|---|
| Unas pocas líneas de texto | Una cantidad enorme de texto |
| Tokens que son palabras | Tokens que pueden ser pedazos de palabras |
| Una tabla de cuentas | Una red neuronal, cuyos pesos se ajustan para predecir el siguiente token |
| Solo mira la última palabra | Tiene en cuenta un contexto largo, por eso distingue Chile de Perú |
| Siempre elige la más frecuente | Suele sortear entre las probables, por eso una misma pregunta puede dar respuestas distintas |
Por eso un LLM responde bien muchas preguntas, y lo que aparece muchas veces en su texto de entrenamiento suele salir bien. También hay productos que agregan otros pasos, como buscar en documentos o correr código. Y después de entrenarlo con texto, por lo general se sigue ajustando con ejemplos de conversaciones, para que responda como asistente. El núcleo sigue siendo predecir el texto que viene.
Por qué responde con seguridad aunque esté equivocado
Un modelo que predice el siguiente token produce texto probable, y un texto probable no siempre es verdadero. Cuando un modelo de lenguaje da una respuesta falsa como si fuera cierta se habla de alucinaciones. La palabra es una metáfora: describe el resultado, sin afirmar nada sobre intenciones.
Veamos el caso de la pregunta de repaso: ¿por qué un modelo puede citar un artículo que no existe?
$ printf 'quispe publicó\n' | build/next_token
tras "publicó": un 3/3
quispe publicó un artículo sobre redes en 2019 .
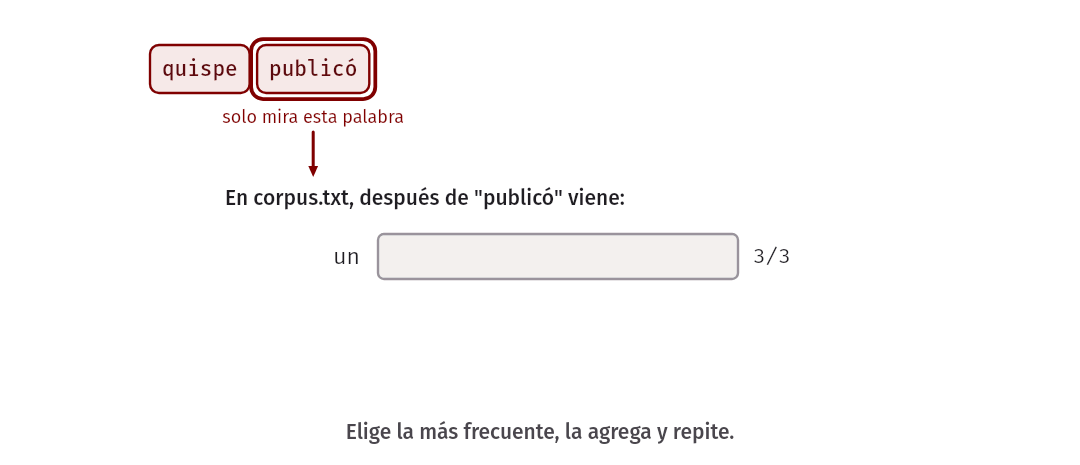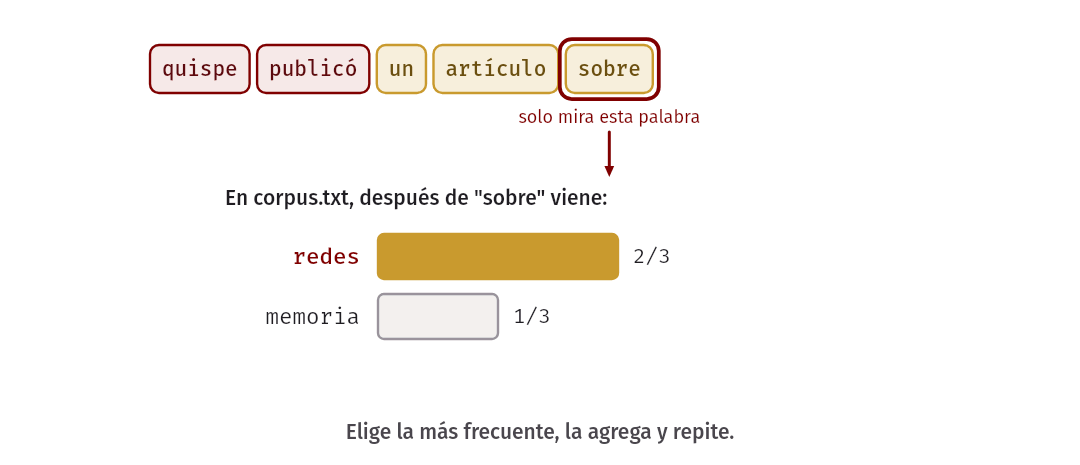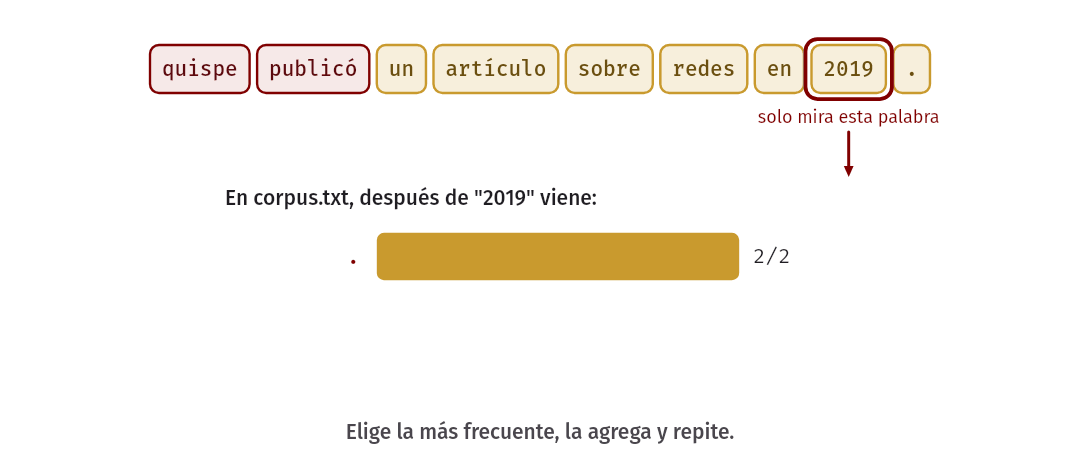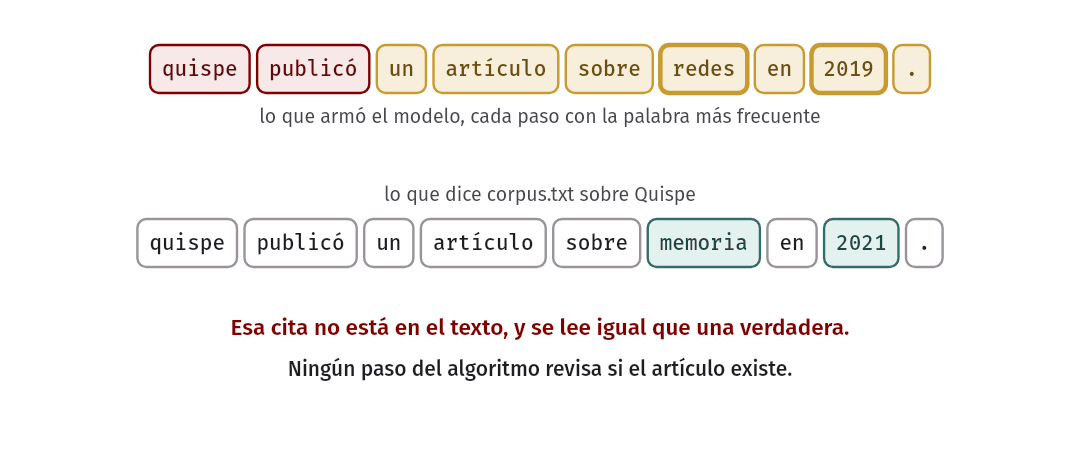
Esa frase no está en corpus.txt. Quispe escribió sobre memoria en 2021. El modelo armó una
cita completa con pedazos que sí aparecían, porque cada paso era el más probable. Se lee igual que
las citas de verdad, y tiene su autor, su tema y su año. Por eso una cita falsa es tan difícil de
notar sin ir a buscarla. Ningún paso del algoritmo revisa si el artículo existe.
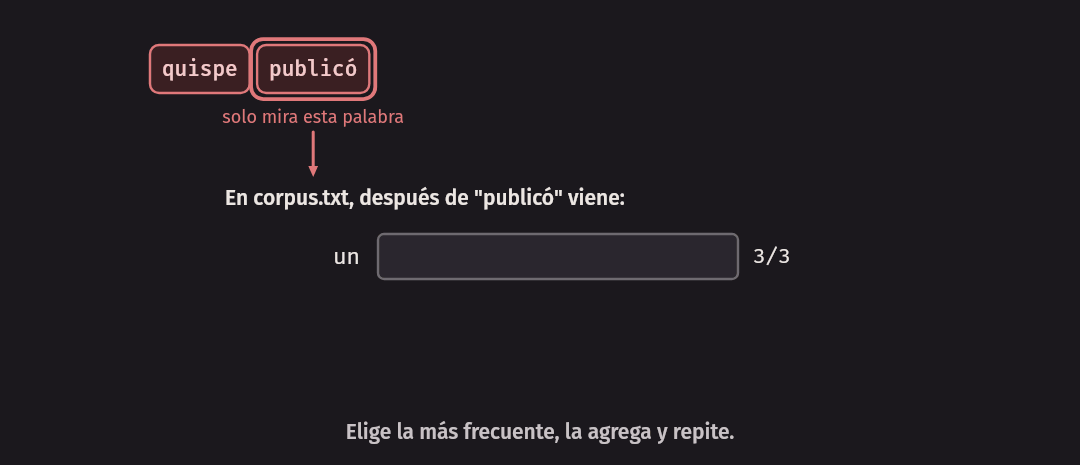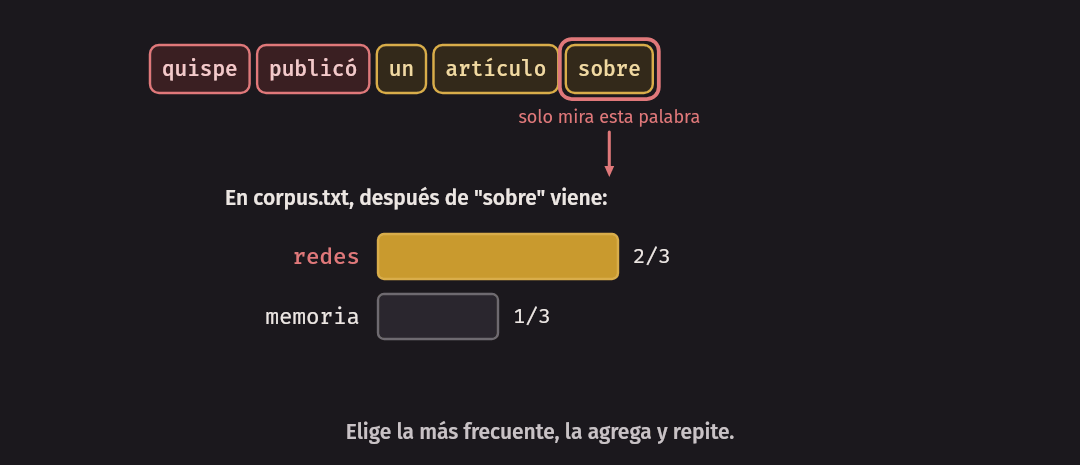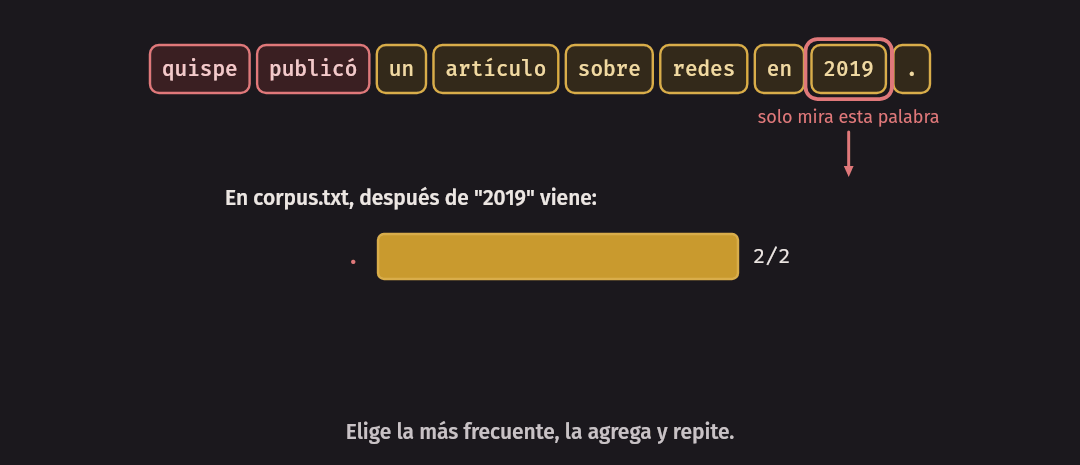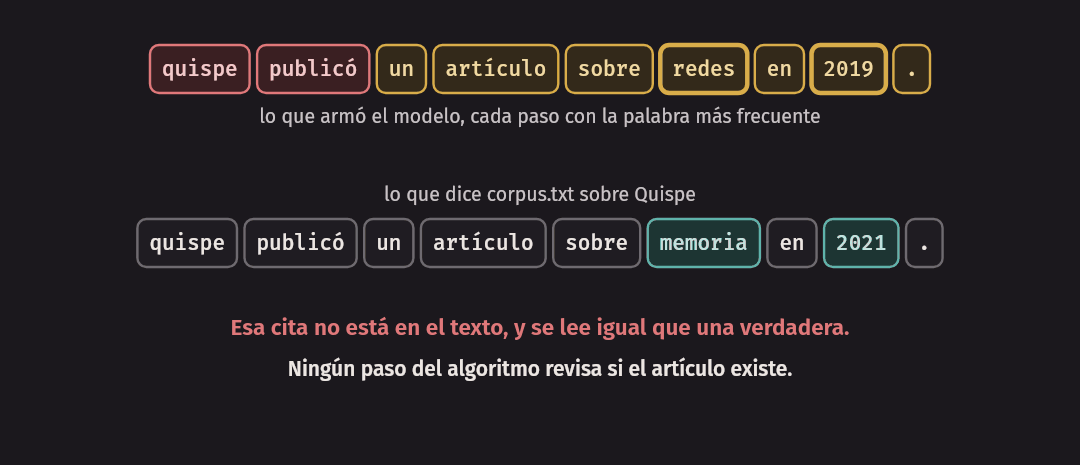
¿De dónde viene la seguridad? Una razón es que el tono también es texto. Muchos textos afirman cosas sin dudar, y un modelo que predice texto produce afirmaciones así. Un modelo puede escribir “no lo sé”, pero esas palabras también son texto predicho: no garantizan que haya medido lo que sabe. Por eso el tono de una respuesta no dice si es correcta.
¿Entonces el modelo entiende lo que dice? Es una pregunta abierta, y en parte depende de qué se llame entender. No hace falta resolverla para trabajar bien. Lo práctico no cambia: la respuesta se comprueba.
Sus límites:
- Se equivoca con seguridad. Puede inventar datos, citas, funciones de biblioteca y resultados de cuentas.
- Depende de los datos de entrenamiento. Lo que falta en ellos, lo que está mal en ellos y lo que pasó después de reunirlos se nota en las respuestas.
- Hereda sesgos. Lo veremos más abajo.
- Una respuesta correcta hoy no asegura la de mañana. Puede cambiar con otra pregunta parecida, o con otra corrida.
Un caso real. En el proceso Mata contra Avianca, en un tribunal federal de Nueva York, dos abogados presentaron un escrito que citaba sentencias judiciales que no existían, generadas por un chatbot, un programa que conversa. Cuando la corte las cuestionó, siguieron defendiéndolas por un tiempo. El 22 de junio de 2023, el juez les impuso a ellos y a su estudio una multa de 5 000 dólares. El juez escribió que usar una herramienta de IA confiable no es impropio en sí mismo; el problema es que los abogados siguen siendo responsables de que lo que presentan sea exacto. Bastaba con buscar las sentencias.
Idea clave. Un LLM genera el texto que probablemente viene, y su mecanismo básico no incluye comprobarlo. Una respuesta segura, bien escrita y con citas todavía puede ser falsa. Comprobarla es trabajo de quien la usa.
Por qué los fundamentos siguen importando
Si un asistente puede escribir C, ¿para qué aprendieron C? Porque para juzgar una respuesta hay que saber el tema.
Esta función devuelve el último carácter de una cadena. Se ve bien, y con "hola" devuelve a:
char last_char(const char s[]) {
    int n = strlen(s);
    return s[n - 1];
}
¿Ven el problema? Quien no sabe cómo se guarda una cadena no lo va a ver, y tampoco va a saber qué
prueba escribir. Quien ya trabajó con cadenas y buffer overflows sabe qué buscar: con la cadena vacía, n
vale 0, y s[-1] está fuera del arreglo. Es comportamiento indefinido. En errors/last_char.c, el
sanitizer lo reporta, porque la prueba sí pasa por ese caso.
Todo lo del curso sirve justamente para eso:
| Lo que aprendieron | Lo que les permite revisar |
|---|---|
| Seguir un programa a mano (semanas 1 a 7) | Saber qué hace el código, sin confiar en la explicación |
Pruebas con assert y casos borde (semana 7) |
Encontrar el caso que falla |
Mensajes de gcc y de los sanitizers (desde la semana 2) |
Notar los errores que el código no muestra a simple vista |
| Overflow y decimales (semana 3) | Dudar de una cuenta que parece bien |
| Contar pasos (semana 13) | Notar que una solución no sirve con datos grandes |
Lo más importante no cambia con ninguna herramienta: el que entiende un problema es quien puede decir si ya quedó resuelto.
Ética: el software afecta a personas
Un programa que decide algo sobre una persona tiene efectos sobre esa persona. Las tres preguntas de esta parte aparecen en cualquier sistema de software, y en los que usan machine learning se notan más.
Sesgo
Un sesgo (bias) es un error sistemático que perjudica a ciertos casos o grupos. No hace falta mala intención. Un modelo aprende de los datos, así que si los datos reflejan decisiones injustas del pasado, o si un grupo casi no aparece en ellos, el modelo lo repite.
Un caso real. El 10 de octubre de 2018, la agencia Reuters informó que Amazon había dejado de lado un sistema experimental para ordenar currículos. Se había entrenado con currículos recibidos durante 10 años, la mayoría de hombres, y aprendió a bajarles el puntaje a los que incluían la palabra “women’s” (de mujeres). Los ingenieros lo corrigieron para esos términos, pero nadie podía asegurar que no encontrara otras formas de discriminar, y el equipo se disolvió. Según el mismo reportaje, los reclutadores miraron sus recomendaciones sin depender solo de ellas, y la empresa dijo que nunca lo usaron para evaluar candidatos. Nadie programó la regla “bajarles el puntaje a las mujeres”: salió de los datos.
Eso enseña algo importante: quitar una columna no basta. Si un modelo de crédito no recibe el sexo de la persona, pero sí su distrito, su trabajo o sus compras, esos datos pueden decir mucho de lo que se quiso quitar.
Hagamos la pregunta de repaso. Un sistema decide a quién se le aprueba un crédito. Antes de confiar en él, preguntarían:
- Datos. ¿Con qué datos se entrenó? ¿De qué años y de qué personas? ¿Quiénes faltan? Si solo hay datos de quienes recibieron un crédito, no sabemos qué habría pasado con los rechazados.
- Evaluación. ¿Se evaluó con datos que no vio? ¿Cuál es el error en cada grupo, y no solo en promedio?
- Tipos de error. Rechazar a quien sí iba a pagar no es lo mismo que aprobar a quien no iba a pagar. ¿Quién paga por cada error?
- Explicación. ¿Se puede saber por qué rechazó a alguien?
- Reclamo. ¿Puede una persona pedir que un humano revise la decisión?
- Responsabilidad. Si el sistema hace daño, ¿quién responde?
- Seguimiento. ¿Alguien sigue midiendo los resultados cuando ya está en uso?
Ninguna tiene una respuesta automática. No basta con “el modelo tiene buena nota”.
Privacidad
Los modelos necesitan datos, y muchos datos son de personas. Un prompt es el texto que se le da al modelo. Hay dos momentos en que eso importa:
- Al entrenar. ¿De dónde salieron los datos? ¿Las personas lo saben? ¿Podría el modelo repetir algo privado que estaba en ellos?
- Al usarlo. Lo que escriben en un asistente en línea viaja a la computadora de otra organización. HTTPS, que vieron la semana pasada, protege el camino, pero no lo que el destino haga después con el texto. Según sus condiciones, puede guardarlo o usarlo para entrenar.
Una regla práctica: no pongan en un prompt lo que no pondrían en un correo a un desconocido. Eso incluye datos personales, notas o documentos de otras personas, contraseñas, y lo que una empresa les confió.
Autoría y responsabilidad
Un buen profesional responde por lo que entrega, venga de donde venga:
- Quien usa la herramienta responde por el resultado. “Lo escribió el asistente” no es una defensa, como vimos con los abogados.
- Sean honestos sobre lo que usaron. En muchos lugares hay reglas para declararlo. Quién tiene los derechos sobre un texto generado o qué licencia tiene el código que se le parece son preguntas que todavía se discuten.
- Si no lo pueden explicar, no lo entreguen.
- Avisen cuando algo no está bien probado, sobre todo si alguien puede salir perjudicado.
La regla de este curso. Según el sílabo, las herramientas de IA generativa están prohibidas en el curso, salvo en la actividad guiada de esta semana. La razón: en el primer curso de la carrera, el trabajo de escribir el código y equivocarse es justamente lo que les da con qué juzgar una respuesta. Las prácticas y los exámenes siguen siendo individuales.
El laboratorio: comprobar antes de creer
El laboratorio tiene dos partes y un repaso. Los archivos están en
code/week-15/lab.
Parte 1: tres funciones sospechosas
lab/suspect.c trae is_prime, max_of_array y copy_text. Se escribieron para esta actividad, y
cada una tiene un bug a propósito. Compilan sin advertencias, y lab/tests.c trae una prueba de
cada una, que pasa. Su trabajo es:
- Agregar en
lab/tests.cpruebasasserthasta que cada función falle. Primero piensen qué caso la haría fallar. - Correr
make test-lab. Informa por separado, para cada función, si sus pruebas detectan el bug. El programabuild/lab/testsno sirve aquí, porque se detiene en el primerassertque falla. - Solo entonces, corregir
lab/suspect.c. - Correr
make test-labotra vez.
make test-lab hace algo que no hemos hecho antes: prueba sus pruebas. Enlaza su tests.c con
la versión original de las funciones, y sus pruebas deben fallar. Después lo enlaza con su versión
corregida, y deben pasar. Una prueba que siempre pasa no sirve de nada, y una que siempre falla
tampoco. Además, make test-lab revisa sus funciones con casos que no están en sus pruebas. Repartir un
programa en varios archivos se aprende en cursos posteriores; aquí make lo hace por ustedes.
Veamos la idea con otra función, la de la transcripción A de lab/transcripts.md, un ejemplo
escrito para esta actividad. Debía contar notas de 11 o más, pero dice grades[i] > 11, y la prueba
que trae pasa. El programa errors/passing_border.c agrega una prueba con una nota de 11 exacta:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/passing_border.c -o build/passing_border
$ build/passing_border
passing_border: errors/passing_border.c:21: main: Assertion `count_passing(border, 3) == 2' failed.
Según la terminal, después puede aparecer Aborted, como en la semana 7. El compilador no dice
nada, porque el programa es C válido. El sanitizer tampoco, porque no hay ningún error de memoria.
Solo lo encontró una prueba que sabía qué respuesta esperar, y quien la escribió tenía que saber
que el 11 es el borde. Esa transcripción ya queda resuelta: si usan las transcripciones en el
laboratorio, trabajen con las otras.
Error común. Pedirle al asistente la función y también sus pruebas, y creer que pasar esas pruebas es suficiente. Las pruebas pueden tener el mismo error de razonamiento que la función. Como en el ejemplo de arriba, pasan aunque el código esté mal. Sus casos los piensan ustedes.
Con una función como copy_text, ojo con el tamaño: el sanitizer solo avisa si la escritura se sale
de un arreglo. Si la prueba usa un destino de 20 bytes y le pasa size igual a 20 con un texto
corto, nunca se llega a salir. Prueben un destino del tamaño exacto y un texto que no cabe.
Parte 2: la actividad guiada
Usen el asistente que permita la universidad. Es la única vez en el curso:
- Antes de preguntar, escriban qué debe hacer la función y sus casos borde. Escojan una de las
que ya escribieron, en clase o en los ejercicios:
my_strlen,is_palindrome,count_passing,to_upper,reverse. - Pidan la función en C, sin datos personales en el prompt.
- Léanla. ¿Qué línea no pueden explicar?
- Compílenla con
gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined. - Pruébenla con sus propias pruebas
assert. - Anoten en la hoja
lab/activity_sheet.mdqué hizo bien, qué error encontraron y cómo lo detectaron.
Es posible que no encuentren ningún error. También es un resultado válido, y hay que anotarlo con cuidado: las pruebas solo dicen que la función funciona en los casos que revisaron.
Si no hay asistente o no hay internet. Usen las transcripciones impresas de
lab/transcripts.md. Son ejemplos escritos para esta actividad, no salidas reales de un
asistente, y traen el código en lab/transcripts/. Tienen los mismos pasos. Sin internet,
Codespaces no abre: quien tenga Docker en su laptop puede compilar ahí; los demás siguen las
funciones a mano, en papel, con una tabla de variables, igual que en un examen.
Parte 3: repaso
El tiempo que quede es para la sección que sigue.
Repaso para el examen final
El examen final cubre todo el curso, con énfasis en las semanas 9 a 15. El formato sugerido está en exams/README.md. Revisen si
pueden hacer esto sin mirar:
| Semanas | Pueden hacerlo sin mirar si… |
|---|---|
| 1 a 7 | Siguen a mano un programa con ciclos y funciones. Convierten entre bases. Explican qué es el overflow. |
| 9 | Dibujan un arreglo en memoria y explican qué pasa con a[n]. |
| 10 | Explican por qué una función puede cambiar un arreglo recibido. Dibujan una cadena con su '\0'. |
| 11 | Usan las funciones de string.h y recorren una matriz. |
| 12 | Definen un struct, y leen un archivo de texto revisando cada resultado. |
| 13 | Siguen a mano la búsqueda binaria y cuentan sus comparaciones. Comparan N, log N y N². |
| 14 | Explican qué hacen DNS y HTTP, y qué protege HTTPS. |
| 15 | Responden las cinco preguntas de la guía de esta semana y explican las ideas de este capítulo con los ejemplos a mano. |
Y el método sigue siendo el mismo: predecir antes de correr, y después comprobar.
Qué sigue en la carrera
Este curso fue una primera mirada a toda la computación, y casi cada semana es la semilla de un curso entero. Los nombres y el orden los fija el plan de estudios, pero estos son los temas que les esperan:
| Lo que vieron | Lo que se estudia después |
|---|---|
| Funciones y pruebas | Programación, a fondo, con recursión y abstracción |
| Arreglos, búsqueda y eficiencia | Estructuras de datos y algoritmos |
Bits, memoria, gdb |
Arquitectura de computadoras y sistemas operativos |
| Lógica y compuertas | Matemática discreta y teoría de la computación |
Archivos y struct |
Bases de datos |
| Internet y HTTP | Redes de computadoras |
| Neurona, entrenar y evaluar | Inteligencia artificial y machine learning |
| Pruebas, responsabilidad | Ingeniería de software |
Las herramientas van a cambiar, muchas veces, durante su carrera. Lo que han practicado aquí no: entender un problema, partirlo, escribir una solución, dudar de ella y comprobarla.
Resumen
- Programar es escribir la regla. En machine learning, un programa busca la regla a partir de ejemplos. Ninguna forma gana siempre.
- En aprendizaje supervisado, cada ejemplo trae su etiqueta. Entrenar es ajustar los números del modelo para cometer menos errores.
- Un modelo se evalúa con datos que no vio. El overfitting es ajustarse a las rarezas del entrenamiento y empeorar con datos nuevos: el memorizador cometió 0 errores de 11 en entrenamiento y 3 de 8 en prueba.
- Una red neuronal es una función con muchos pesos, organizada en capas. Cada neurona multiplica, suma y decide. No es un modelo de un cerebro.
- Un LLM predice el siguiente token, una y otra vez. Produce texto probable, que no siempre es verdadero.
- Las alucinaciones son respuestas falsas dichas como ciertas. El mecanismo básico no comprueba nada, y el tono no dice si la respuesta es correcta.
- Para juzgar una respuesta hay que saber el tema. Los fundamentos son lo que permite escribir la prueba que falla.
- Sesgo: un modelo repite lo que hay en sus datos, aunque se le quite una columna. Privacidad: lo que se escribe en un servicio en línea sale de sus manos.
- Responsabilidad: quien usa la herramienta responde por el resultado. En este curso, la IA generativa solo se permite en la actividad guiada de esta semana.
- Una prueba sirve si puede fallar: debe fallar con el código malo y pasar con el bueno, y solo dice algo de los casos que revisa.
Ejercicios
-
Para cada problema, digan si usarían reglas escritas a mano o machine learning, y por qué: calcular el IGV de una compra, reconocer si una foto tiene un gato, decidir si un año es bisiesto, detectar spam.
-
Agreguen a los datos de entrenamiento un correo de 3 palabras que sí es spam, y sigan a mano
entrenar_umbral. ¿Qué umbral sale? ¿Cuántos errores comete, en entrenamiento y en los 8 correos de prueba? -
Sigan a mano el memorizador con los 11 correos de entrenamiento. ¿Qué responde para un correo de 9 palabras? Si se agrega a los datos de prueba un correo de 6 palabras que no es spam, ¿cuántos errores tienen el memorizador y el umbral
u = 4? ¿Qué muestra eso sobre evaluar con pocos datos? -
Un equipo informa que su modelo no cometió ningún error, pero lo evaluó con los mismos datos con los que lo entrenó. ¿Qué le preguntarían? ¿Por qué ese número no dice cómo le irá con datos nuevos?
-
Usen los pesos finales de la neurona de
neuron.c(1,1y base-2). ¿Qué responde con los correos (1, 1), (4, 0) y (0, 0)? Después, empiecen con todo en 0 y hagan un solo paso de entrenamiento con el correo (2, 1), de etiqueta 1. ¿Cuáles son los nuevos pesos y la nueva base? -
Demuestren que ninguna neurona de dos entradas calcula XOR, con cualesquiera pesos
w_ayw_by cualquierbase. Pista: escriban las cuatro desigualdades. Sumen las de (0, 1) y (1, 0), y compárenlo con las de (0, 0) y (1, 1). -
Agreguen a
corpus.txt, a mano en papel, la líneala capital de ecuador es quito .. ¿Cómo quedan las cuentas después dees? ¿Qué responde ahora el modelo parala capital de ecuador es? ¿Qué tendría que cambiar en el modelo para que acierte? ¿Por qué agregar el dato no bastó? -
Sigan a mano
continuarparaflores publicócon elcorpus.txtoriginal. ¿La frase que resulta está en el texto? ¿Y conquispe publicó? ¿Qué les dice eso sobre una cita que da un LLM? Con esa idea, respondan: ¿cómo comprobarían una cita, sin preguntarle otra vez al mismo modelo? -
Esta función debe devolver el promedio de un arreglo de
int, connal menos 1. Pasa la prueba de abajo. Escriban unassertque falle, expliquen por qué y corríjanla.double average(const int a[], int n) { int total = 0; for (int i = 0; i < n; i++) { total = total + a[i]; } return total / n; } int grades[2] = {10, 20}; assert(average(grades, 2) == 15.0);Aquí
==sí se puede usar condouble: como vieron en la semana 3, 15.0 y otros valores como 10.5 se guardan exactos en binario. -
Un asistente escribe una función que pasa la prueba que le pidieron. Hagan una lista de lo que revisarían antes de usarla. Incluyan al menos un caso de cada tipo: lectura, compilación, casos borde, memoria y responsabilidad.
-
Una municipalidad quiere ordenar a las personas para un subsidio con un modelo entrenado con las decisiones de los últimos años. Mencionen dos formas en que podría aparecer un sesgo sin que nadie lo programe, y dos preguntas que harían antes de usarlo.
-
¿Cuáles de estos prompts escribirían en un asistente en línea? Expliquen cada caso: una duda sobre qué hace
strncpy; la lista de notas de sus compañeros, con sus nombres, para que calcule el promedio; el código de su práctica calificada; una función propia de este laboratorio, sin datos personales.