Apuntes · Capítulo 13Memoria y datos
Búsqueda, ordenamiento y eficiencia
Búsqueda, ordenamiento y eficiencia
La semana pasada guardamos los datos de muchos estudiantes en un arreglo de struct, leídos
de un archivo. Con eso aparece una pregunta muy común: ¿cómo encuentro a un estudiante? Si
son 30, cualquier método sirve. Si son un millón, el método decide si la respuesta llega de
inmediato o si hay que esperar.
Hasta ahora nos preguntábamos si un programa funciona. Hoy agregamos otra pregunta: ¿cuánto trabajo hace, y cómo crece ese trabajo cuando crecen los datos? Veremos dos formas de buscar y dos de ordenar, y las compararemos de dos maneras: contando pasos y midiendo segundos.
Al final hay una sección sobre recursión, una forma distinta de repetir, que se ve a fondo en el curso Introducción a la Programación.
Lectura. El código de este capítulo está en
code/week-13. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Búsqueda lineal” y “Búsqueda binaria”. Es lo mínimo para seguir la clase.
- En clase: “Contar pasos en lugar de medir segundos”, “Cómo crecen N, log N y N²”, “Ordenamiento por selección”, “
qsort: ordenar sin saber cómo” y “Cuándo vale la pena ordenar”.- Después de clase: para el laboratorio, “Medir tiempo con
clock” y “El laboratorio, paso a paso”; para repasar, “Resumen” y “Ejercicios”. Opcional: ✂️ “Recursión”, si no se llegó a ver en clase.
Búsqueda lineal
La idea más simple es mirar los elementos uno por uno, desde el inicio, hasta encontrar el valor o hasta que se acaben. Se llama búsqueda lineal (linear search). Devuelve el índice donde encontró el valor, o -1 si no está. Se usa -1 porque ningún índice vale eso.
algoritmo busqueda_lineal(lista, n, valor)
    para i desde 0 hasta n - 1 hacer
        si lista[i] = valor entonces
            devolver i
        fin si
    fin para
    devolver -1
fin algoritmo
En C, con const porque solo lee el arreglo, y con la longitud aparte, como en la semana 10:
int linear_search(const int a[], int n, int value) {
    for (int i = 0; i < n; i++) {
        if (a[i] == value) {
            return i;
        }
    }
    return -1;
}
Sigamos a mano la búsqueda del 17 en las notas 14, 9, 17, 11, 20 y 9:
i |
a[i] |
¿a[i] == 17? |
|---|---|---|
| 0 | 14 | no |
| 1 | 9 | no |
| 2 | 17 | sí, se devuelve 2 |
$ build/linear_search
Buscar 17 devuelve 2
Buscar 13 devuelve -1
La búsqueda lineal tiene una gran ventaja: funciona con cualquier arreglo, ordenado o no. Si un valor se repite, como el 9, devuelve el primero que encuentra. Su desventaja se ve en la búsqueda del 13: para decir que un valor no está, tuvo que mirar los seis elementos.
Búsqueda binaria
Piensen en cómo adivinar un número del 1 al 100 si les dicen “es mayor” o “es menor”. Nadie empieza por 1, 2, 3. Se empieza por 50, porque esa sola respuesta descarta la mitad. Después se prueba en el medio de lo que queda, y así hasta llegar.
Eso es la búsqueda binaria (binary search). Se mira el elemento del medio. Si es el valor, se terminó. Si es menor que el valor, todo lo que está a su izquierda también es menor, y se descarta. Si es mayor, se descarta todo lo que está a su derecha.
Idea clave. La búsqueda binaria exige datos ordenados. Al ver un solo elemento descarta muchos otros sin mirarlos, y eso solo es correcto si el orden garantiza qué hay a cada lado.
Dos índices marcan la parte que todavía puede tener el valor: bajo y alto, ambos incluidos.
algoritmo busqueda_binaria(lista, n, valor)
    bajo ← 0
    alto ← n - 1
    mientras bajo ≤ alto hacer
        medio ← bajo + (alto - bajo) div 2
        si lista[medio] = valor entonces
            devolver medio
        sino si lista[medio] < valor entonces
            bajo ← medio + 1
        sino
            alto ← medio - 1
        fin si
    fin mientras
    devolver -1
fin algoritmo
En C, con los nombres low, high y mid:
int binary_search(const int a[], int n, int value) {
    int low = 0;
    int high = n - 1;
    while (low <= high) {
        int mid = low + (high - low) / 2;
        if (a[mid] == value) {
            return mid;
        } else if (a[mid] < value) {
            low = mid + 1;
        } else {
            high = mid - 1;
        }
    }
    return -1;
}
Las pruebas de binary_search.c cubren los bordes: el primero, el último, un valor menor que
todos, uno mayor que todos, uno que cae entre dos, un arreglo vacío y uno de un solo elemento.
Seguirla a mano
El programa binary_trace.c escribe los índices de cada paso, con este arreglo de 10 códigos:
| Índice | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| Código | 2 | 5 | 8 | 12 | 16 | 23 | 38 | 56 | 72 | 91 |
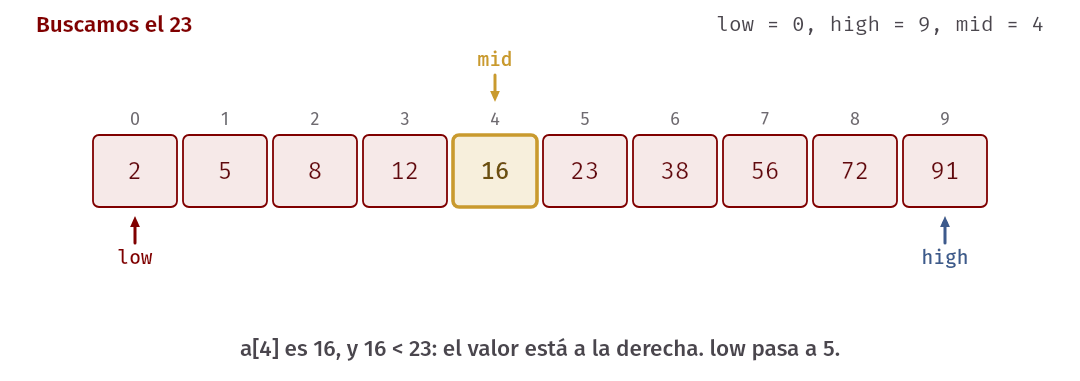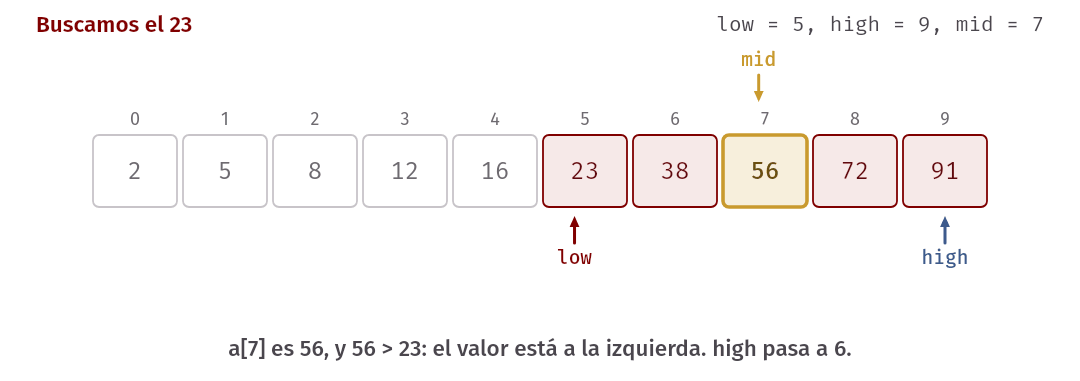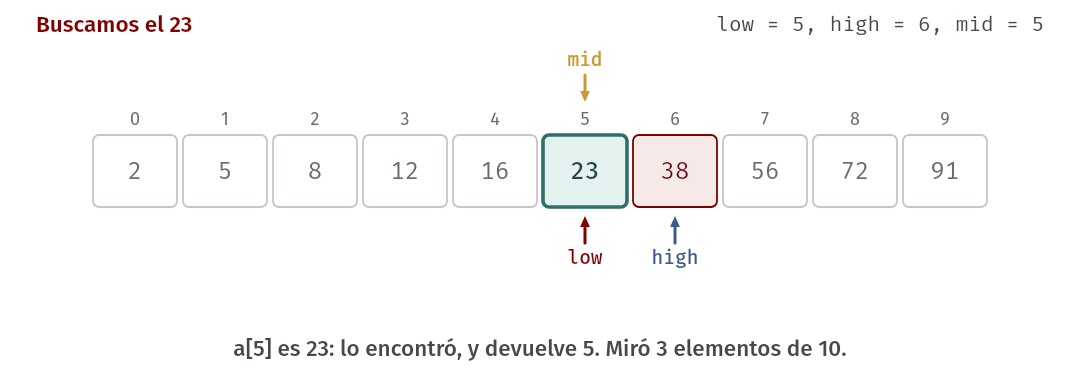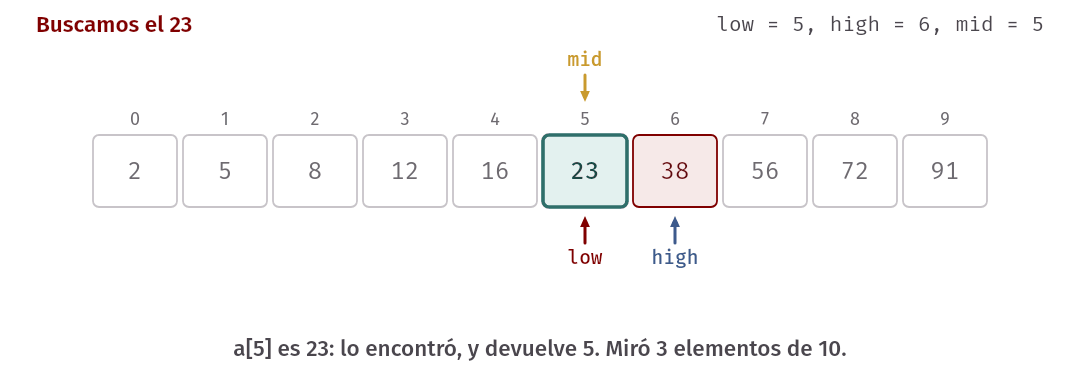
Buscamos el 23:
$ echo 23 | build/binary_trace
low = 0, high = 9, mid = 4, a[mid] = 16
low = 5, high = 9, mid = 7, a[mid] = 56
low = 5, high = 6, mid = 5, a[mid] = 23
Resultado: 5
Paso a paso:
| Paso | low |
high |
mid |
a[mid] |
Qué se concluye |
|---|---|---|---|---|---|
| 1 | 0 | 9 | 4 | 16 | 16 < 23: el valor está a la derecha, low pasa a 5 |
| 2 | 5 | 9 | 7 | 56 | 56 > 23: el valor está a la izquierda, high pasa a 6 |
| 3 | 5 | 6 | 5 | 23 | lo encontró, y devuelve 5 |
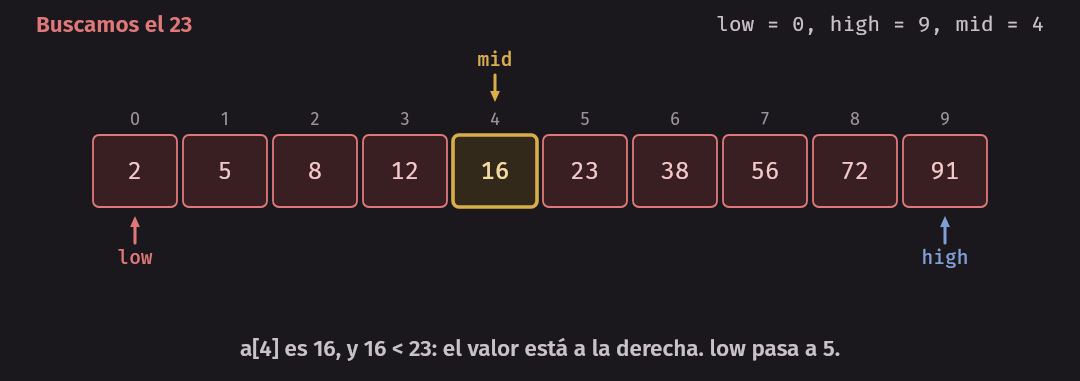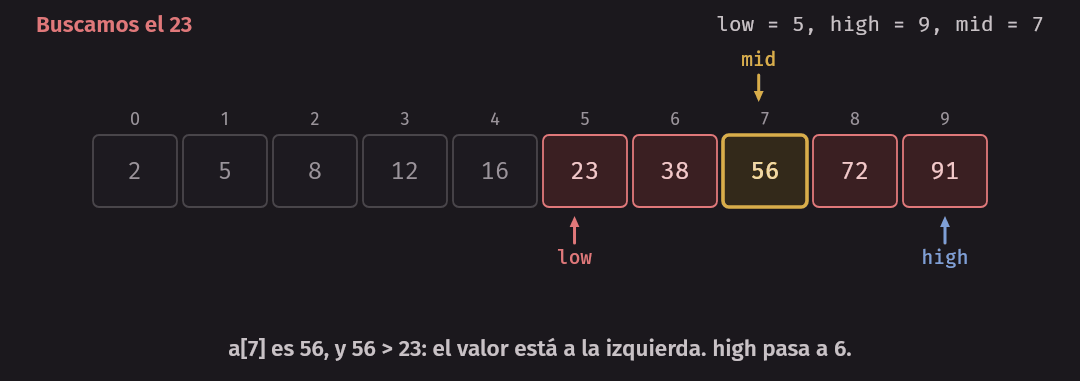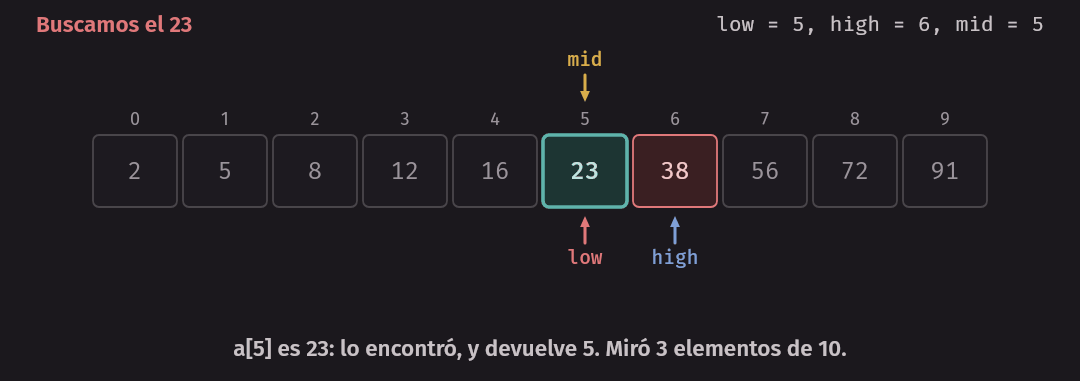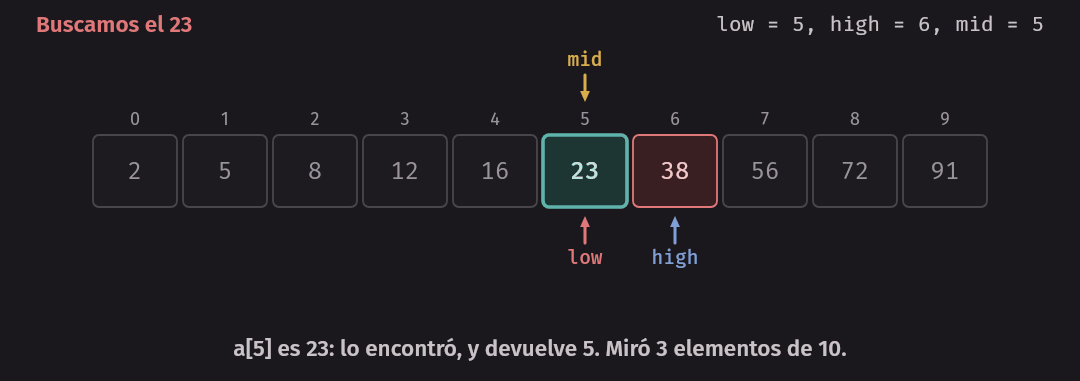
Miró 3 elementos de 10. La división entre enteros descarta los decimales, como vimos en la
semana 2: en el paso 3, (6 - 5) / 2 da 0, y mid es 5.
¿Y si el valor no está? Con el 40, los dos índices se terminan cruzando:
$ echo 40 | build/binary_trace
low = 0, high = 9, mid = 4, a[mid] = 16
low = 5, high = 9, mid = 7, a[mid] = 56
low = 5, high = 6, mid = 5, a[mid] = 23
low = 6, high = 6, mid = 6, a[mid] = 38
low = 7, high = 6: ya no queda nada
Resultado: -1
Cuando low pasa a high, la parte que queda está vacía. Por eso la condición es low <= high:
con low igual a high todavía queda un elemento por mirar.
Si hay valores repetidos, la búsqueda binaria encuentra uno de ellos, pero no promete cuál.
Tres errores clásicos
La búsqueda binaria es corta, y aun así es muy fácil escribirla mal.
Primero: usarla con datos desordenados. El programa no se rompe ni da ningún aviso. Solo
responde mal, y a veces bien, que es peor. El arreglo de errors/binary_unsorted.c tiene 5, 1, 9,
3 y 7, y buscamos cada uno de sus elementos:
$ gcc -Wall -Wextra -std=c17 errors/binary_unsorted.c -o build/binary_unsorted
$ build/binary_unsorted
El 5 está en el índice 0; binaria responde 0
El 1 está en el índice 1; binaria responde -1
El 9 está en el índice 2; binaria responde 2
El 3 está en el índice 3; binaria responde -1
El 7 está en el índice 4; binaria responde -1
Sigan el caso del 1. Mira el medio, el 9, y como 9 es mayor que 1, descarta la derecha: hasta ahí todo bien. Luego mira el 5, y como 5 es mayor que 1, descarta también lo que queda, incluido el 1. Descartó bien según la regla, pero la regla suponía un orden que no existe.
Segundo: low < high en lugar de low <= high. El ciclo termina cuando aún queda un elemento,
sin mirarlo. El programa errors/low_less_high.c busca en 10, 20 y 30:
$ gcc -Wall -Wextra -std=c17 errors/low_less_high.c -o build/low_less_high
$ build/low_less_high
El 10 está en el índice 0; responde -1
El 20 está en el índice 1; responde 1
El 30 está en el índice 2; responde -1
Tercero: olvidar el + 1 o el - 1. Si se escribe high = mid, puede que nada cambie entre una
vuelta y la siguiente: con low, high y mid iguales y un valor menor, high queda igual, y el
ciclo no termina nunca. Lo van a seguir a mano en un ejercicio.
Por qué low + (high - low) / 2
¿Por qué no calcular el medio con (low + high) / 2, como un promedio? Da lo mismo en casi todos
los casos, pero la suma puede no caber en un int, aunque el medio sí quepa. Como vimos en la
semana 3, el overflow de un int es comportamiento indefinido. La otra fórmula nunca suma dos
índices grandes: high - low es a lo sumo el tamaño de la parte que queda.
El programa errors/mid_overflow.c lee los dos índices y calcula el medio de las dos formas. Así
reporta el problema -fsanitize=undefined, de la semana 3, al correr:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/mid_overflow.c -o build/mid_overflow
$ echo 2000000000 2100000000 | build/mid_overflow
errors/mid_overflow.c:12:47: runtime error: signed integer overflow: 2000000000 + 2100000000 cannot be represented in type 'int'
Fórmula segura: 2050000000
Fórmula con la suma: -97483648
Ese número negativo salió en esta corrida: después de un comportamiento indefinido, el lenguaje no promete nada. En nuestros ejemplos no hay arreglos tan grandes, pero la fórmula segura no cuesta nada, así que siempre la usamos.
Contar pasos en lugar de medir segundos
¿Cuál búsqueda es mejor, y por cuánto? Podríamos medir segundos, pero los segundos dependen de la máquina, de las opciones de compilación y de qué más esté corriendo. Una cuenta de pasos, en cambio, sale igual en cualquier computadora.
Vamos a contar comparaciones: cuántos elementos del arreglo se miraron para compararlos con
el valor buscado. La búsqueda binaria hace hasta dos preguntas por cada elemento, == y <, pero
las contamos como una sola. Si contáramos las dos, el total sería a lo sumo el doble, y la forma de
crecer, que es lo que nos interesa, no cambiaría.
Una función tiene que devolver dos cosas: el índice y la cuenta. Con lo de la semana pasada ya se
puede: una función también puede devolver un struct, igual que un int, y quien llama recibe una copia.
Por eso el pseudocódigo devuelve dos valores. La búsqueda lineal con contador solo agrega un contador
al algoritmo:
algoritmo busqueda_lineal_contando(lista, n, valor)
    comparaciones ← 0
    para i desde 0 hasta n - 1 hacer
        comparaciones ← comparaciones + 1
        si lista[i] = valor entonces
            devolver i, comparaciones
        fin si
    fin para
    devolver -1, comparaciones
fin algoritmo
struct search_result {
int index; // dónde está, o -1
int comparisons; // cuántos elementos se miraron
};
struct search_result linear_count(const int a[], int n, int value) {
struct search_result result = {-1, 0};
for (int i = 0; i < n; i++) {
result.comparisons++;
if (a[i] == value) {
result.index = i;
return result;
}
}
return result;
}binary_count hace lo mismo con la búsqueda binaria: result.comparisons++ justo antes de mirar
a[mid]. El contador se inicia dentro de la función, así que cada llamada cuenta desde 0.
El programa count_search.c llena el arreglo con los pares 0, 2, 4, y así sucesivamente, que quedan
ordenados. Con los tres tamaños del laboratorio, busca un valor mayor que todos, y que por lo tanto
no está. La última columna es el peor caso de la binaria, hallado probando todos los valores posibles,
uno por uno:
$ build/count_search
       N   lineal  binaria     peor
    1000     1000       10       10
   10000    10000       14       14
  100000   100000       17       17
Promedio con N = 1000, si el valor está: lineal 500.50, binaria 8.99
%8s es como %8d, el ancho mínimo que ya conocen, pero para un texto: así las columnas quedan
alineadas. Estos números no dependen de la máquina. Son exactos.
Fíjense en lo que dicen. Con cien veces más datos, la lineal mira cien veces más. La binaria mira 7 elementos más. Y la binaria casi siempre está cerca de su peor caso: con N = 1000, en promedio 8.99 contra un máximo de 10. En cambio, la lineal en promedio mira la mitad cuando el valor está, y todo cuando no está.
De dónde sale el 10
Cada comparación de la búsqueda binaria descarta el elemento mirado y uno de los dos lados. Quedan, como mucho, la mitad, sin decimales. Por eso el máximo de comparaciones es cuántas veces se puede partir N a la mitad, sin decimales, hasta llegar a 0:
algoritmo mitades(n)
    cuenta ← 0
    mientras n > 0 hacer
        n ← n div 2
        cuenta ← cuenta + 1
    fin mientras
    devolver cuenta
fin algoritmo
Con N = 1000: 500, 250, 125, 62, 31, 15, 7, 3, 1 y 0. Son 10 mitades, igual que en la tabla. Y con 1 000 000: 500 000, 250 000, 125 000, 62 500, 31 250, 15 625, 7812, 3906, 1953, 976, 488, 244, 122, 61, 30, 15, 7, 3, 1 y 0. Son 20. En un millón de elementos, la búsqueda binaria mira como máximo 20.
Esa cuenta tiene un nombre en matemática: es casi el logaritmo en base 2 de N, que se escribe log₂ N. El logaritmo responde a la pregunta “¿a qué potencia hay que elevar el 2 para llegar a N?”. Como 2¹⁰ = 1024, log₂ 1024 es 10, y log₂ 1000 es un poco menos. El número de mitades y el logaritmo difieren en 1 como mucho: con 1024 elementos, la tabla daría 11. Para nosotros, log N es cuántas veces se puede partir N a la mitad, y con eso basta.
Error común. Decir que la búsqueda binaria “es más rápida” y ya. Antes de usarla, los datos tienen que estar ordenados, y ordenar también cuesta. Más adelante hacemos esa cuenta.
long long: cuando la cuenta no cabe
Las cuentas crecen rápido, y un int llega hasta 2147483647 en este entorno, como vimos en la
semana 3. Para contar más usamos long long, un entero que C garantiza que tiene al menos 64 bits.
Se escribe con %lld. Lo necesitaremos, porque 100 000 × 100 000 ya no cabe en un int.
Cómo crecen N, log N y N²
Hay tres formas de crecer que van a ver una y otra vez. El programa growth.c calcula números exactos.
La columna log es el conteo de mitades de la sección anterior, y (long long) n * n hace el cast
antes de multiplicar, para que la multiplicación se haga en 64 bits:
$ build/growth
        N   log         N            N*N
     1000    10      1000        1000000
     2000    11      2000        4000000
     4000    12      4000       16000000
     8000    13      8000       64000000

     1000    10      1000        1000000
    10000    14     10000      100000000
   100000    17    100000    10000000000
  1000000    20   1000000  1000000000000
La primera tabla muestra la regla que hay que recordar. ¿Qué pasa cuando N se duplica?
| Si el trabajo crece como | Al duplicar N, el trabajo | Ejemplo |
|---|---|---|
| log N | suma un poco, una comparación más | búsqueda binaria |
| N | se duplica | búsqueda lineal |
| N² | se multiplica por 4 | ordenamiento por selección, que viene ahora |
Con esto se hacen predicciones. Si un programa tarda 2 segundos con N = 1000 y su trabajo crece como N, con N = 2000 esperamos unos 4 segundos. Si crece como N², unos 8, porque 2 × 4 = 8. Y con N diez veces mayor, 20 segundos en el primer caso y 200 en el segundo.
Idea clave. Para comparar algoritmos con muchos datos importa cómo crece el trabajo, más que cuánto tarda una vez. Con una computadora el doble de rápida, un programa N² solo gana un 41 % más de datos en el mismo tiempo (porque 1.41² ≈ 2). Un mejor algoritmo gana mucho más.
Esto es solo la forma de crecer: dos programas que crecen como N pueden diferir en cuánto tarda cada
paso. Y con pocos datos, la forma de crecer casi no importa. Si en otro lugar leen O(N) u O(N²),
es esta misma idea, con una definición formal que verán en cursos posteriores.
Ordenamiento por selección
La búsqueda binaria necesita datos ordenados. ¿Cómo se ordenan? Hay muchos métodos, y empezamos por uno que se puede hacer a mano. El ordenamiento (sorting) por selección es como ordenar cartas sobre la mesa: se busca la menor de todas y se pone primera; luego la menor de las que quedan, y se pone segunda; y así sucesivamente.
algoritmo ordenar_por_seleccion(lista, n)
    para i desde 0 hasta n - 2 hacer
        menor ← i
        para j desde i + 1 hasta n - 1 hacer
            si lista[j] < lista[menor] entonces
                menor ← j
            fin si
        fin para
        guardado ← lista[i]
        lista[i] ← lista[menor]
        lista[menor] ← guardado
    fin para
fin algoritmo
La vuelta llega hasta n - 2 porque, cuando ya están en su lugar los n - 1 menores, el último
tiene que ser el mayor. Las tres líneas del final intercambian dos elementos: sin guardado, el
valor de lista[i] se perdería al pisarlo.
En C, el intercambio va en una función. Puede cambiar el arreglo porque recibe su dirección, como en
la semana 10. La función devuelve cuántas comparaciones hizo, en un long long. Por eso el conteo
va dentro:
void swap_at(int a[], int i, int j) {
    int saved = a[i];
    a[i] = a[j];
    a[j] = saved;
}
long long selection_sort(int a[], int n) {
long long comparisons = 0;
for (int i = 0; i < n - 1; i++) {
int smallest = i;
for (int j = i + 1; j < n; j++) {
comparisons++;
if (a[j] < a[smallest]) {
smallest = j;
}
}
swap_at(a, i, smallest);
printf("i = %d, menor en %d:", i, smallest);
print_array(a, n);
}
return comparisons;
}Las dos últimas líneas del ciclo escriben cada pasada, para poder seguirla. selection_sort.c ordena
primero un arreglo desordenado, y después uno que ya está ordenado:
$ build/selection_sort
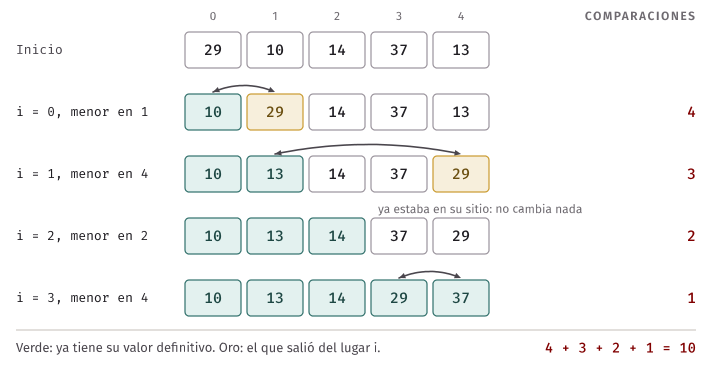
Inicio: 29 10 14 37 13
i = 0, menor en 1: 10 29 14 37 13
i = 1, menor en 4: 10 13 14 37 29
i = 2, menor en 2: 10 13 14 37 29
i = 3, menor en 4: 10 13 14 29 37
Comparaciones: 10
Inicio: 10 13 14 29 37
i = 0, menor en 0: 10 13 14 29 37
i = 1, menor en 1: 10 13 14 29 37
i = 2, menor en 2: 10 13 14 29 37
i = 3, menor en 3: 10 13 14 29 37
Comparaciones: 10
Cada línea dice en qué índice estaba el menor de lo que quedaba, y cómo quedó el arreglo después del
intercambio. Con i igual a 2, el menor ya estaba en su sitio, y el intercambio no cambia nada.
Después de la pasada i, los elementos de 0 a i ya tienen su valor definitivo.
Cuántas comparaciones hace
Miren el segundo caso: el arreglo ya estaba ordenado, y aun así hizo 10 comparaciones. El método no se da cuenta. Para saber cuál es el menor de lo que queda, siempre tiene que mirarlo todo.
Por eso la cuenta es exacta y no depende de los datos. Con N elementos, la primera pasada compara N - 1 veces, la segunda N - 2, y así hasta 1:
(N - 1) + (N - 2) + … + 2 + 1 = N (N - 1) / 2
Con N = 5, da 4 + 3 + 2 + 1 = 10, como en la salida. Con N = 100 000, da 4 999 950 000: ese número no
cabe en un int, y por eso el contador es long long. La fórmula tiene un N × N, dividido entre 2. Es decir,
crece como N²: si N se duplica, el trabajo se multiplica casi por 4.
Medir tiempo con clock
Contar es exacto, pero al final lo que se espera son segundos. clock, de time.h, devuelve cuánto
tiempo de procesador lleva usado el programa. No es la hora: si el programa está esperando, ese
reloj casi no avanza. Se llama antes y después, y se resta:
clock_t start = clock();
long long comparisons = selection_sort(work, n);
clock_t end = clock();
double selection_seconds = (double) (end - start) / CLOCKS_PER_SEC;
clock_t es el tipo que devuelve clock. CLOCKS_PER_SEC es una constante de time.h: cuántas de
esas unidades tiene un segundo. El cast a double es el de la semana 2, para que la división no sea
entera.
Cómo se mide bien
Tres cuidados, antes de confiar en un número:
- Sin sanitizers. Los sanitizers agregan revisiones en cada acceso a memoria, y hacen más lento el programa. Sirven para encontrar errores, no para medir.
- Con un nivel de optimización declarado. La opción
-O0, de la semana 7, le pide agccno optimizar.-O2le pide lo contrario: que reorganice el código para que corra más rápido, sin cambiar lo que un programa correcto hace. Medimos con-O2, como se compila un programa de verdad. - Usando el resultado. Con
-O2, si nadie usa lo calculado, el compilador puede eliminar el cálculo, y se mediría la nada. Por esosort_times.ccomprueba al final que el arreglo quedó ordenado, y lo imprime.
make compila los programas de medición aparte, en build/fast/, con -Wall -Wextra -std=c17 -O2. El
mismo programa de ordenar, compilado de las tres formas, con 40 000 elementos, usó estos tiempos
en esta máquina, en esta corrida:
$ gcc -Wall -Wextra -std=c17 -O2 sort_times.c -o build/sort_times_o2
$ echo 40000 | build/sort_times_o2
      N    comparac. selección      qsort  ordenado
  40000    799980000    0.6179s    0.0032s  sí
$ gcc -Wall -Wextra -std=c17 -O0 sort_times.c -o build/sort_times_o0
$ echo 40000 | build/sort_times_o0
      N    comparac. selección      qsort  ordenado
  40000    799980000    0.9924s    0.0049s  sí
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined sort_times.c -o build/sort_times_san
$ echo 40000 | build/sort_times_san
      N    comparac. selección      qsort  ordenado
  40000    799980000    3.3838s    0.0061s  sí
La cuenta de comparaciones es la misma en las tres, y es exacta. El tiempo de selección es muy distinto:
con sanitizers tardó más de 5 veces lo que con -O2. Por eso un tiempo sin decir cómo se compiló no significa
casi nada. La diferencia en qsort es menor, porque su código está en la biblioteca y ya viene compilado:
solo cambia la parte que está en nuestro archivo, la función de comparar.
Selección: ¿crece como N²?
sort_times.c lee los tamaños de la entrada, llena un arreglo con números de rand con una semilla
fija, y mide. Cada fila ordena una copia de los mismos datos con los dos métodos. Los tiempos son
de esta máquina y de esta corrida. En la de ustedes serán otros, y hasta cambian de una corrida a otra.
$ echo 10000 20000 40000 80000 | build/fast/sort_times
      N    comparac. selección      qsort  ordenado
  10000     49995000    0.0657s    0.0007s  sí
  20000    199990000    0.2008s    0.0015s  sí
  40000    799980000    0.6245s    0.0032s  sí
  80000   3199960000    2.1519s    0.0077s  sí
Calculemos cuántas veces creció cada columna respecto de la fila anterior:
| N pasa de | Comparaciones | Tiempo de selección | Tiempo de qsort |
|---|---|---|---|
| 10 000 a 20 000 | 4.00 | 3.06 | 2.14 |
| 20 000 a 40 000 | 4.00 | 3.11 | 2.13 |
| 40 000 a 80 000 | 4.00 | 3.45 | 2.41 |
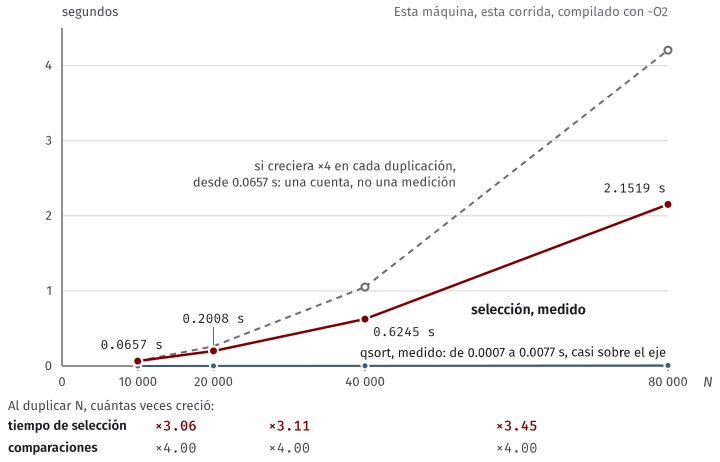
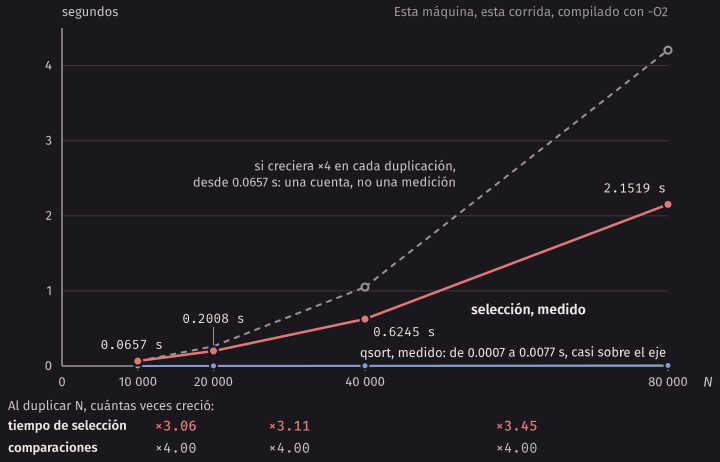
Las comparaciones se multiplican por 4, como dice la fórmula. El tiempo de selección, en cambio, no llegó a 4 en esta medición. ¿Está mal la fórmula? No: la fórmula cuenta comparaciones, y el tiempo no es solo eso. Dividan los segundos entre las comparaciones: con 10 000 elementos sale unos 1.3 nanosegundos por comparación, y con 80 000, unos 0.7. En esta máquina, una comparación no siempre costó lo mismo. Como dijimos en la semana 9, una CPU moderna hace mucho más que seguir el modelo simple, y además está la cache. No vamos a investigar la causa exacta. Lo que importa es la lección: una cuenta es exacta, y un tiempo es una medición, y hay que comparar lo que se predijo con lo que salió, sin arreglar los números.
También vean la columna de qsort y su factor. Un tiempo muy pequeño no es confiable: en unos milisegundos pesa
cualquier otra cosa que corra en la máquina, y con 4 decimales quedan pocas cifras. Para comparar, usen tamaños que tarden al menos unas décimas de segundo. Con qsort, esos tiempos
de milisegundos sirven solo como orden de magnitud.
Idea clave. Los tiempos dependen de la máquina; la tendencia, no. Lo que se puede esperar en otra máquina, con tamaños parecidos, es la forma: al duplicar N, selección crece bastante más que el doble, y por eso se aleja de
qsort. Con 80 000 elementos, aquí, ya tarda unas 280 veces más.
qsort: ordenar sin saber cómo
La columna qsort de la tabla es de una función de la biblioteca, en stdlib.h. La usamos como una
caja negra: sabemos qué hace y cómo llamarla, sin ver por dentro. Tiene cuatro argumentos:
qsort(grades, N, sizeof(grades[0]), compare_ints);- el arreglo;
- cuántos elementos tiene;
- cuánto ocupa cada uno, en bytes;
- el nombre de una función que dice cómo comparar dos elementos.
qsort no sabe qué tipo de datos tiene el arreglo: sirve igual para int que para un struct. Por eso
hay que decirle el tamaño y darle la función de comparar. Esa función la escribimos nosotros, y qsort
la llama cada vez que necesita comparar dos elementos. Devuelve un número negativo si el primero va
antes, positivo si va después y 0 si da igual. Es la misma idea de strcmp.
int compare_ints(const void *first, const void *second) {
    int x = *(const int *) first;
    int y = *(const int *) second;
    if (x < y) {
        return -1;
    } else if (x > y) {
        return 1;
    }
    return 0;
}
Su forma la pide qsort, y no se puede cambiar. En este curso se copia como receta. const void *
significa “la dirección de algo, sin decir de qué tipo”. La línea *(const int *) first significa “trata esa
dirección como la de un int, y lee el int que hay ahí”. Los punteros se estudian en cursos
posteriores. Para otro tipo numérico, se cambia int por ese tipo. Con un struct, se copian los dos elementos del
mismo modo y se compara un campo: x.grade < y.grade.
$ build/qsort_demo
 9 9 11 14 17 20
Error común. Abreviar la función con
return x - y;. Parece ingenioso, pero la resta puede no caber en unint. Es overflow, comportamiento indefinido, y puede ordenar mal, como enerrors/compare_subtract.c, que ordena 2000000000, -2000000000 y 5:$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/compare_subtract.c -o build/compare_subtract $ build/compare_subtract errors/compare_subtract.c:10:14: runtime error: signed integer overflow: 2000000000 - -2000000000 cannot be represented in type 'int' 2000000000 -2000000000 5Ese resultado, que no está ordenado, salió en esta corrida. Con otros datos o con otro compilador puede salir otra cosa.
¿Por qué qsort tarda tan poco, si también compara? Porque usa un método mejor que el de selección. En la
tabla de arriba se ve que, al duplicar N, su tiempo se multiplica por poco más de 2, y no por 4.
El estándar de C no dice qué algoritmo usa, ni promete una velocidad: eso depende de la biblioteca. Tampoco
promete en qué orden quedan dos elementos iguales. Métodos así se ven en cursos posteriores. Aquí basta
saber que existen, y que para ordenar en un programa de verdad se usa la función de la biblioteca.
Cuándo vale la pena ordenar
Ya podemos responder la pregunta que quedó pendiente. Tenemos una lista desordenada y hay que buscar
k veces. Hay dos planes:
- Plan A: hacer
kbúsquedas lineales. No se prepara nada. - Plan B: ordenar una vez, y después hacer
kbúsquedas binarias.
Con pocos datos da igual. Con N = 100 000, hagamos la cuenta en comparaciones, para valores que no están.
El plan A hace k × 100 000. El plan B hace, como mucho, k × 17, más lo que cueste ordenar. Si se
ordena por selección, ese costo es de casi 5 000 000 000 de comparaciones, y el plan B solo gana cuando
k pasa de unas 50 000 búsquedas. Si se ordena con qsort, mucho antes.
sort_then_search.c lo mide con qsort. Busca k valores que no están, de las dos formas. Las columnas
lineal y binaria son comparaciones exactas de las búsquedas, sin contar lo que hace qsort. Las dos
últimas son los tiempos totales, con t ordenar incluyendo el qsort. Son de esta máquina y de
esta corrida:
$ echo 100000 1 10 100 1000 10000 100000 | build/fast/sort_then_search
      k          lineal      binaria   t lineal  t ordenar
      1          100000           17    0.0000s    0.0086s
     10         1000000          167    0.0004s    0.0085s
    100        10000000         1668    0.0036s    0.0085s
   1000       100000000        16688    0.0361s    0.0084s
  10000      1000000000       166891    0.3807s    0.0091s
 100000     10000000000      1668930    3.6900s    0.0134s
Las comparaciones de la búsqueda son exactas. Los tiempos dicen lo que importa. Con una búsqueda gana el plan A:
aquí el plan B gasta unos 8 milisegundos casi todos en ordenar, y la búsqueda lineal tarda tan poco que clock, con 4
decimales, muestra 0.0000. Ese cero no significa que no tardó nada. Entre 100 y 1000 búsquedas, en esta corrida, el plan B
empieza a ganar. Con 100 000 búsquedas, el plan A tardó unos 3.7 segundos y el B, 0.0134: unas 275 veces menos.
Idea clave. Ordenar es una inversión: se paga una vez y se recupera en cada búsqueda. Para una búsqueda en una lista desordenada, no conviene: la búsqueda lineal ya resuelve el problema, y ordenar tendría que mirar todos los elementos de todos modos. Para 100 000 búsquedas, conviene de sobra.
Hay un costo más. Si los datos cambian todo el tiempo, mantenerlos ordenados tiene un precio: en la semana 10 vimos que insertar en medio de un arreglo obliga a mover elementos. Por eso la decisión depende de cuánto se busca y cuánto se cambia.
Recursión
Hasta ahora, para repetir hemos usado ciclos. Hay otra forma: que una función se llame a sí misma con un problema más pequeño. Eso es la recursión (recursion). Toda función recursiva tiene dos partes:
- el caso base, tan pequeño que se responde sin más llamadas;
- el caso recursivo, que reduce el problema y se llama a sí misma.
El ejemplo clásico es el factorial. 5! es 5 × 4 × 3 × 2 × 1. Pero también es 5 × 4!, y esa es la
idea: el factorial de n es n por el factorial de n - 1. Y el factorial de 0 o de 1 es 1.
algoritmo factorial(n)
    si n ≤ 1 entonces
        devolver 1
    fin si
    devolver n * factorial(n - 1)
fin algoritmo
long long factorial(int n) {
if (n <= 1) {
return 1;
}
return n * factorial(n - 1);
}El resultado es long long porque crece muy rápido: factorial(20) todavía cabe en 64 bits, pero
factorial(21) ya no, y sería overflow. factorial.c tiene una versión que escribe un rastro de cada llamada:
$ build/factorial
entra factorial(4)
entra factorial(3)
entra factorial(2)
entra factorial(1)
caso base: factorial(1) devuelve 1
factorial(2) devuelve 2
factorial(3) devuelve 6
factorial(4) devuelve 24
factorial(20) = 2432902008176640000
Fíjense en que primero baja, sin haber calculado nada, y que al llegar al caso base vuelve, y
recién ahí multiplica. La pila de llamadas de la semana 7 lo explica: cada llamada agrega un marco, con
su propio n. Son variables distintas, aunque tengan el mismo nombre. Así se apilan los marcos hasta llegar
al caso base, y así se retiran:
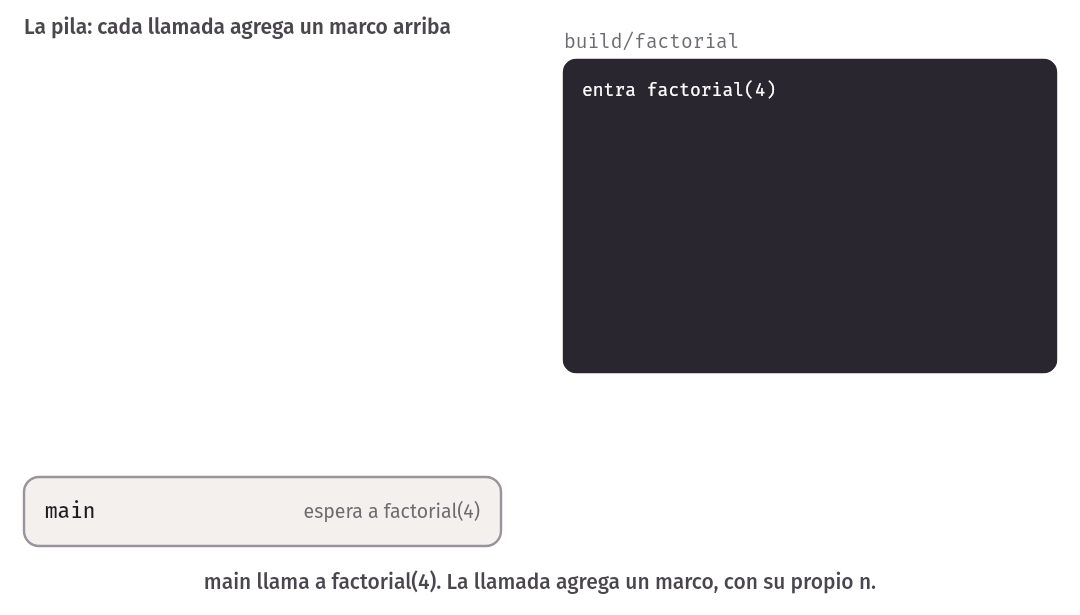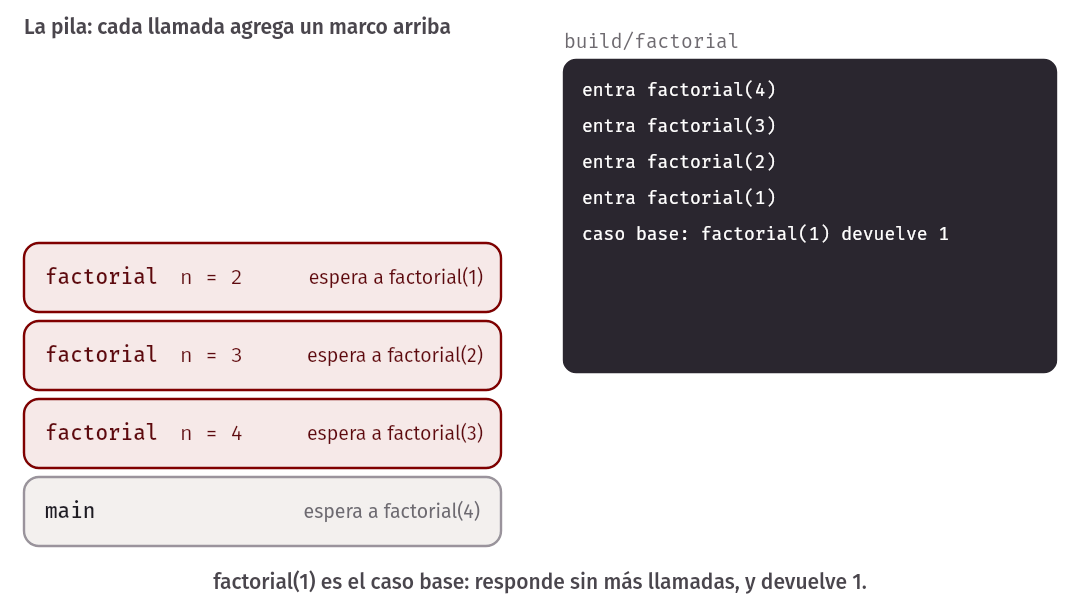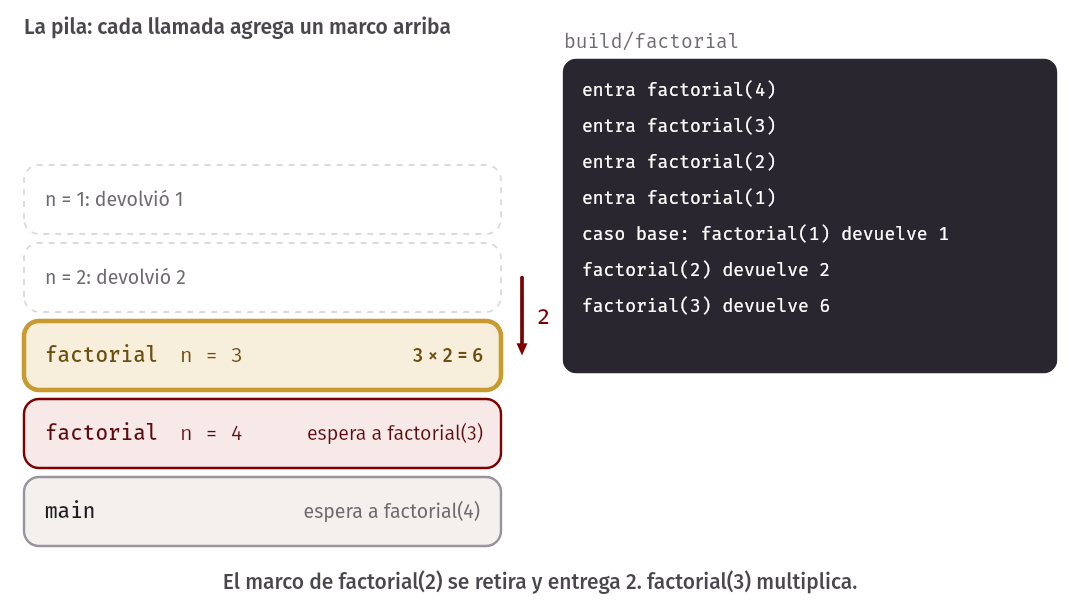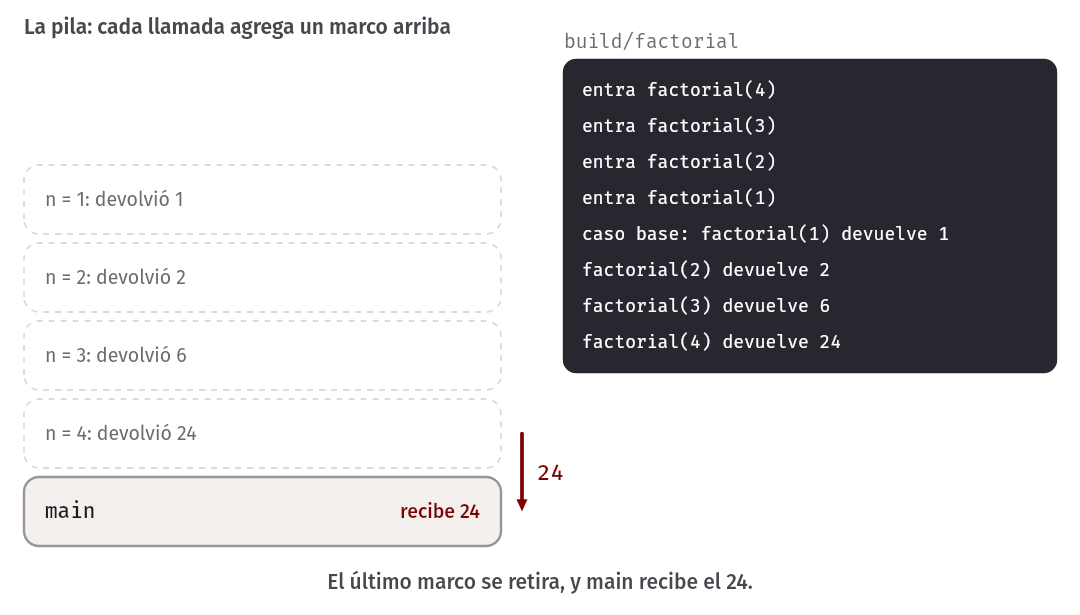
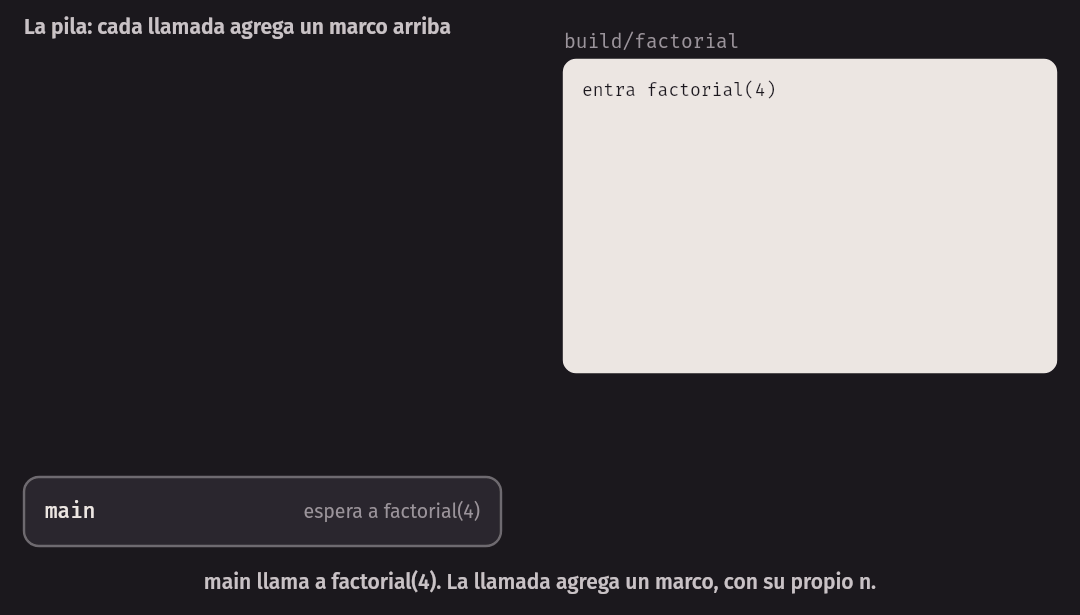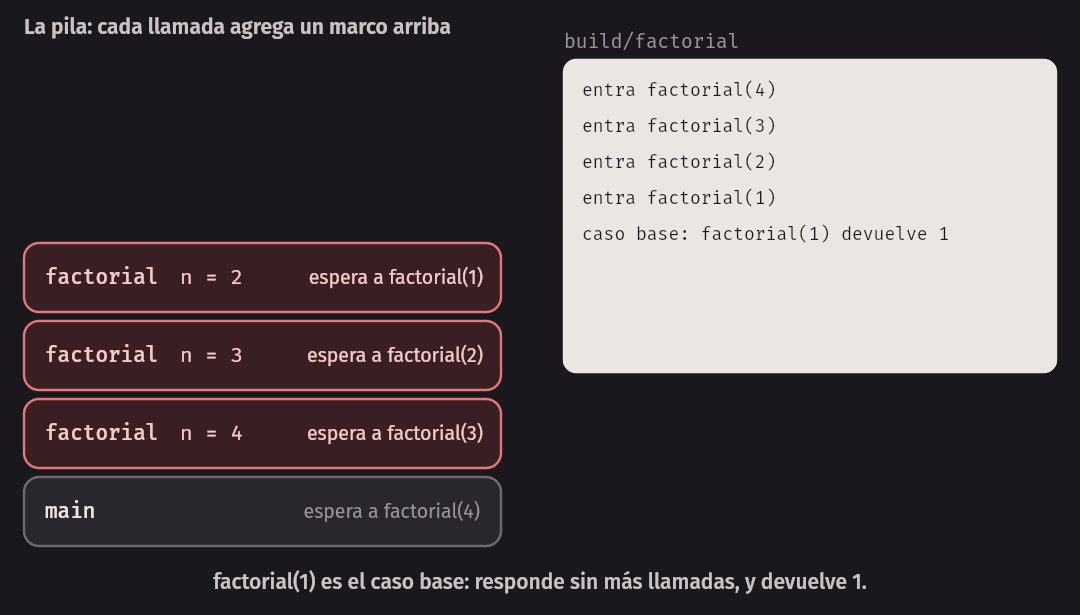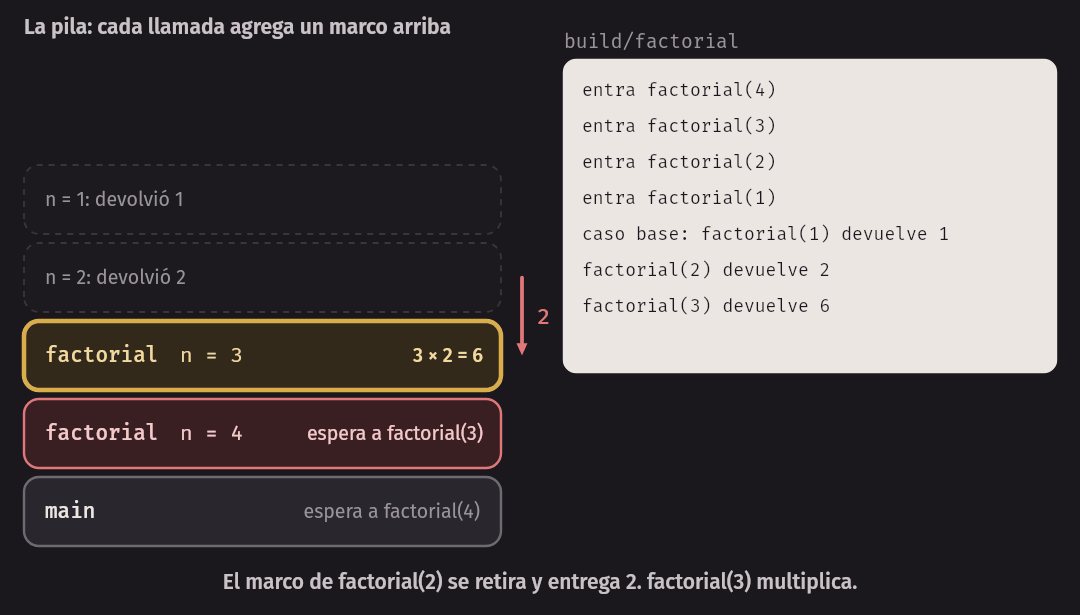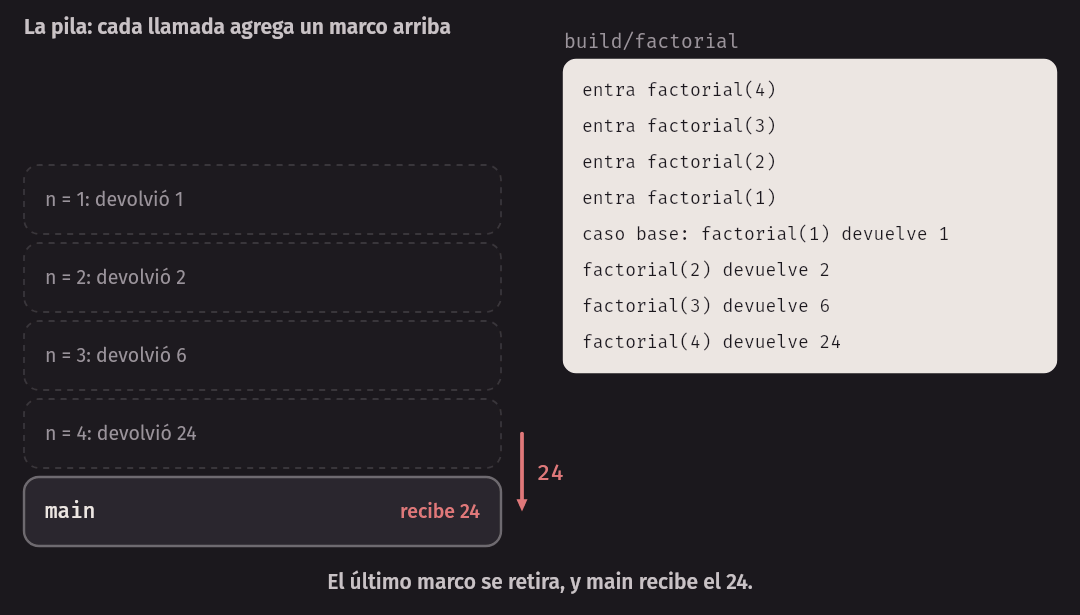
Al terminar, cada marco se retira y le entrega su resultado al de abajo: 1, 2, 6 y 24.
Sin caso base, se acaba la pila
¿Qué pasa si falta el caso base? Las llamadas no terminan, y cada una agrega un marco. La pila es una zona de
memoria con un límite. gcc a veces lo detecta, como aquí, pero solo es una advertencia:
$ gcc -Wall -Wextra -std=c17 errors/no_base_case.c -o build/no_base_case
errors/no_base_case.c: In function ‘sum_down’:
errors/no_base_case.c:4:11: warning: infinite recursion detected [-Winfinite-recursion]
    4 | long long sum_down(int n) {
      |           ^~~~~~~~
errors/no_base_case.c:5:16: note: recursive call
    5 |     return n + sum_down(n - 1);
      |                ^~~~~~~~~~~~~~~
Sin -O, gcc compila igual que con -O0. Al correrlo, la pila se agota. Eso se llama stack overflow. El sistema operativo termina el programa, en este entorno con el mismo segmentation
fault de la semana 10. Esto salió en esta corrida; el lenguaje no define qué pasa:
$ build/no_base_case; echo "estado: $?"
bash: line 1: 15389 Segmentation fault      build/no_base_case
estado: 139
Con -fsanitize=address, el informe le pone nombre. Está recortado, y sus direcciones cambian en cada corrida:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/no_base_case.c -o build/no_base_case_san 2>/dev/null
$ build/no_base_case_san
==15402==ERROR: AddressSanitizer: stack-overflow on address 0xffffd805bff0 (pc 0xaaaade350d28 bp 0xffffd805c020 sp 0xffffd805c020 T0)
    #0 0xaaaade350d28 in sum_down errors/no_base_case.c:4
    #1 0xaaaade350d64 in sum_down errors/no_base_case.c:5
    #2 0xaaaade350d64 in sum_down errors/no_base_case.c:5
Si el programa muere con Segmentation fault sin mostrar el informe, córranlo otra vez. Nos pasó en unas 3 de cada
10 corridas en un x86-64 emulado, y nunca en 30 corridas en ARM.
2>/dev/null descarta las advertencias de gcc, que ya vimos: 2> redirige los mensajes de error y
/dev/null es un archivo que bota lo que recibe.
Tener un caso base tampoco basta si la recursión es demasiado profunda. errors/deep_recursion.c sí tiene
uno, y funciona con n igual a 1000. Con 10 millones, los marcos no entran en la pila de este entorno, cuyo
tamaño, en KB, muestra ulimit -s. En su terminal verán solo Segmentation fault; aquí la salida se
capturó, y por eso bash agrega el número de proceso y nombra los dos comandos de la tubería.
$ gcc -Wall -Wextra -std=c17 errors/deep_recursion.c -o build/deep_recursion
$ echo 1000 | build/deep_recursion
500500
$ echo 10000000 | build/deep_recursion; echo "estado: $?"
bash: line 1: 15394 Done                    echo 10000000
     15395 Segmentation fault      | build/deep_recursion
estado: 139
$ ulimit -s
8192
Lo mismo vale para los arreglos locales, que también viven en la pila: int data[100000] son 400 KB en este
entorno, y caben. Un arreglo local de muchos millones de elementos no cabría. Ese es el motivo de MAX_N en estos programas.
Error común. Olvidar el caso base, o escribir uno que nunca se alcanza. Antes de escribir la llamada recursiva, pregúntense: ¿el problema se hace más pequeño, y llega siempre al caso base? Por eso
factorialusan <= 1: si la condición fueran == 1, llamar afactorial(0)seguiría bajando con 0, -1, -2, sin llegar nunca al caso base.
El factorial también se puede hacer con un ciclo, y así queda mejor, porque no gasta un marco por cada número. La recursión se luce en otros problemas, y eso lo verán en Introducción a la Programación.
El laboratorio, paso a paso
El laboratorio tiene dos archivos, en code/week-13/lab: searching.c
y sorting.c. Los comentarios dicen qué debe hacer cada función. make test-lab los comprueba, y falla
hasta que terminen.
Parte 1: búsqueda lineal y binaria
En searching.c, escriban linear_search y binary_search, a partir del pseudocódigo de este capítulo.
En main agreguen pruebas con assert, con los casos que sean bordes: el primero, el último, un valor menor
que todos, uno mayor que todos, uno que cae entre dos, y n igual a 0.
Las pruebas de make test-lab revisan más cosas de las que parece. Una es que binary_search sea
binaria de verdad: le dan el arreglo desordenado 5, 1, 9, 3, 7 y esperan que no encuentre el 1, como vimos arriba.
Otra es que no use la suma low + high.
Parte 2: contar comparaciones
Escriban linear_count y binary_count, que devuelven un struct search_result. Después completen el ciclo
de main, para que imprima una línea por tamaño, con n, la cuenta de linear_count y la de binary_count,
buscando 2 * n. Antes de correrlo, predigan los números con el algoritmo de las mitades. Deben coincidir
con la tabla de este capítulo, y la prueba lo exige.
Cuidado con dónde cuentan: una comparación por cada elemento mirado, también el último. Y result empieza
en {-1, 0} dentro de la función, así que una llamada no arrastra la cuenta de la anterior.
Parte 3: ordenar y medir
En sorting.c, escriban selection_sort, is_sorted, seconds_selection y seconds_qsort. main y
compare_ints vienen listos. make test-lab no puede comprobar un tiempo real, porque cambia en cada máquina, así
que reemplaza a clock por un reloj de prueba, con un valor conocido. Con él comprueba que llamen a clock
justo antes y justo después de ordenar, y que el cálculo de los segundos esté bien.
Cuando pasen las pruebas, midan de verdad:
make measureEso compila con -O2 y sin sanitizers, y mide con 10 000, 20 000, 40 000 y 80 000 elementos. Copien los
resultados y calculen, en cada fila, cuántas veces creció el tiempo de selección respecto de la fila anterior.
Respondan por escrito: ¿qué factor esperaban para selección? ¿Qué obtuvieron? ¿Cuál será el tiempo para 100 000
elementos? Compruébenlo con echo 100000 | build/lab/sorting_fast, y comparen con el de build/lab/sorting, que
tiene sanitizers, en un tamaño menor, como 20 000.
Resumen
- La búsqueda lineal mira uno por uno y sirve con cualquier arreglo. Para decir que un valor no está, mira los N elementos.
- La búsqueda binaria mira el medio y descarta la mitad en cada paso. Exige datos ordenados; con datos
desordenados, no avisa: responde mal. El ciclo es
low <= high, los índices avanzan conmid + 1ymid - 1, y el medio se calcula conlow + (high - low) / 2, para evitar el overflow de la suma. - Contar comparaciones da números exactos que no dependen de la máquina. Con 1 000, 10 000 y 100 000 elementos, en el peor caso, la lineal hace N y la binaria 10, 14 y 17. Con 1 000 000, la binaria hace 20.
- log N es, para nosotros, cuántas veces se puede partir N a la mitad. Al duplicar N: log N suma poco, N se duplica y N² se multiplica por 4.
- El ordenamiento por selección busca el menor de lo que queda y lo pone en su sitio. Hace siempre N (N - 1) / 2 comparaciones, aunque el arreglo ya esté ordenado. Crece como N².
long longes un entero de al menos 64 bits, y se escribe con%lld.clockmide tiempo de procesador. Para medir: sin sanitizers, con un nivel de-Odeclarado, y usando el resultado. Los tiempos dependen de la máquina; la tendencia, no.qsortes una caja negra destdlib.h. Recibe una función de comparar, que no debe restar.- Ordenar para buscar es una inversión: no conviene para una búsqueda, y conviene de sobra para muchas.
- Una función recursiva se llama a sí misma con un problema más pequeño, hasta llegar al caso base. Sin él, se agota la pila: un stack overflow.
Ejercicios
-
Con las notas 14, 9, 17, 11, 20 y 9, ¿cuántas comparaciones hace la búsqueda lineal para el 17, para el 9 y para el 13? ¿Qué devuelve en cada caso?
-
Sigan a mano, en una tabla con
low,highymid, la búsqueda binaria en los 10 códigos del capítulo: del 72, y del 1. ¿Cuántos elementos mira cada una? Comprueben conbinary_trace. -
Usando el algoritmo de las mitades, ¿cuántas comparaciones hace como máximo la búsqueda binaria en 2 000 000 de elementos? ¿Y en 1 000 000 000?
-
Un programa tarda 3 segundos con N = 5000. ¿Cuánto esperan con N = 20 000, si su trabajo crece como N? ¿Y si crece como N²?
-
Sigan a mano la búsqueda binaria del 3 en el arreglo desordenado 5, 1, 9, 3, 7. Expliquen en qué paso se descartó justo la parte que tenía el 3.
-
Alguien cambió
high = mid - 1porhigh = midenbinary_search. Sigan a mano la búsqueda del 5 en 10, 20 y 30, y digan qué pasa. ¿Por qué el error no aparece al buscar el 10? -
Sigan a mano el ordenamiento por selección de 5, 2, 9 y 1, con una fila por cada pasada. ¿Cuántas comparaciones hizo? ¿Cuántas haría con 1, 2, 5 y 9?
-
¿Qué hay que cambiar en
selection_sortpara que ordene de mayor a menor? ¿Y encompare_ints, para queqsortordene de mayor a menor? Hagan los dos cambios en una copia, y pruébenlos conselection_sort.cyqsort_demo.c. -
Tienen un arreglo de
struct student, con los camposcodeygrade, ordenado porcode. Escribanfind_student(const struct student a[], int n, int code), que devuelva el índice del estudiante o -1, con búsqueda binaria. Pruébenla conassert, con el primero, el último y un código que no esté. -
Con una lista desordenada de 50 000 elementos, si se ordena por selección, ¿aproximadamente desde qué número de búsquedas de valores ausentes conviene ordenar, contando solo comparaciones? Hagan la cuenta con la fórmula de selección y con el máximo de la binaria.
-
Escriban
power(int base, int n)recursiva, que calculebaseelevado an, paranigual a 0 o mayor, y que devuelva unlong long. Identifiquen el caso base y el recursivo. Pruébenla conassert. ¿Qué pasa connnegativo? -
Escriban
first_index(const int a[], int n, int value), con un ciclo, que use búsqueda binaria y devuelva el primer índice de un valor repetido. Con 1, 3, 3, 3 y 9, el 3 debe dar 1. Pista: al encontrarlo, guarden el índice y sigan buscando a la izquierda.