Apuntes · Capítulo 12Memoria y datos
struct y archivos
struct y archivos
La semana pasada guardamos las notas de varios estudiantes en una matriz. Si además queremos
sus nombres, hace falta otro arreglo, y el programa tiene que recordar que la fila 2 de uno y
la fila 2 del otro son la misma persona. Hoy vemos una forma mejor: struct, un tipo nuevo
que agrupa datos relacionados bajo un solo nombre.
La segunda parte del capítulo resuelve otro problema. Hasta ahora, todo lo que un programa
guarda en memoria se pierde cuando termina. Con los archivos, un programa lee datos que ya
estaban ahí y deja resultados que siguen ahí cuando termina. Al final juntamos las dos cosas:
leer un archivo de principio a fin, pasarlo a un arreglo de struct y escribir otro archivo,
sin romperse si el archivo no existe o trae una línea mal escrita.
Lectura. El código de este capítulo está en
code/week-12. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso. Los nombres y los precios de los archivos de datos son inventados.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “De los arreglos paralelos a
struct”, “Asignar unstructcopia todo” y “structy funciones”. Es lo mínimo para seguir la clase.- En clase: “Arreglos de
struct”, “Qué es un archivo”, “Abrir, leer y cerrar”, “Escribir un archivo” y “Separar campos consscanf”.- Después de clase: para el laboratorio, “El laboratorio, paso a paso”; para repasar, “Resumen” y “Ejercicios”. Opcional: “Una línea más larga que el buffer” y “Un programa de principio a fin”.
De los arreglos paralelos a struct
Queremos guardar el nombre y una nota de cada estudiante. Con lo que sabemos hasta hoy, se usan
dos arreglos: una matriz de char, donde cada fila es una cadena, y un arreglo de int. La
posición los relaciona: names[1] y grades[1] son de la misma persona. A esto se le llama
arreglos paralelos.
El problema es que nada en el lenguaje une esos dos arreglos. Lo tiene que recordar quien
programa, en cada línea. El programa errors/parallel_bug.c elimina a Bruno moviendo los
elementos, como en la semana 10. Mueve las notas y olvida los nombres. Compila sin
advertencias, y no hay ninguna escritura fuera de un arreglo:
$ gcc -Wall -Wextra -std=c17 errors/parallel_bug.c -o build/parallel_bug
$ build/parallel_bug
Ana: 14
Bruno: 11
Bruno tenía 9. El 11 era de Carla. Ahora el programa le pone a Bruno una nota ajena, y nada avisa. Mientras más datos tenga cada estudiante, más arreglos hay que mantener al paso.
Definir un struct
Un struct agrupa varios datos bajo un solo nombre, y cada dato puede tener su propio
tipo. Cada dato se llama campo (field).
#define NAME_SIZE 20
#define N_GRADES 3

struct student {
    char name[NAME_SIZE];
    int grades[N_GRADES];
};
Esto define un tipo nuevo, llamado struct student. Noten tres cosas:
- El nombre completo del tipo son las dos palabras,
struct student. - La definición termina en
;, después de la llave. A diferencia de la llave que cierra una función, esta lleva punto y coma. - Definir el tipo no crea ninguna variable y no reserva memoria para datos. Es el molde. Por eso puede ir arriba, afuera de las funciones: no es una variable global. Todas las funciones que están debajo pueden usar el tipo.
Un campo puede ser un arreglo, y aquí hay dos. name es un arreglo de char que guarda una
cadena. grades es un arreglo de int.
Crear una variable y usar sus campos
Una variable de este tipo se declara como cualquier otra, y se puede inicializar con llaves,
con los valores en el orden de los campos. Las llaves de adentro son las del arreglo grades:
struct student s = {"Ana", {14, 9, 17}};A un campo se llega con un punto: s.name es el nombre de s, y s.grades es su arreglo
de notas. Lo que sale se usa como una variable normal de ese tipo. Como s.grades es un
arreglo, s.grades[1] es su segunda nota:
printf("%s: %d %d %d\n", s.name, s.grades[0], s.grades[1], s.grades[2]);
s.grades[1] = 12;
$ build/first_struct
Ana: 14 9 17
Después del cambio: 12
Nuevo nombre: Beatriz
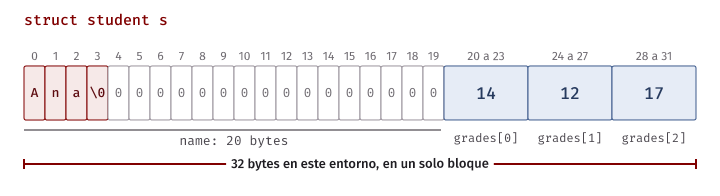
sizeof(struct student) = 32En memoria, los campos de s quedan en orden, dentro de un solo bloque. En este entorno s
ocupa 32 bytes: 20 del nombre y 12 de las tres notas, a 4 bytes cada int.
¿Y la línea Nuevo nombre? Un campo arreglo no se puede cambiar con =, como veremos ahora.
Para un texto se usa strncpy, de la semana pasada, con su '\0' puesto a mano, porque
strncpy puede no ponerlo:
strncpy(s.name, "Beatriz", NAME_SIZE - 1);
s.name[NAME_SIZE - 1] = '\0';
Tres errores de compilación
Los tres aparecen tarde o temprano. Conviene reconocerlos.
Olvidar la palabra struct. El tipo se llama struct student, no student. El mensaje de
gcc lo dice:
$ gcc -Wall -Wextra -std=c17 errors/no_struct_word.c -o build/no_struct_word
errors/no_struct_word.c: In function ‘main’:
errors/no_struct_word.c:13:5: error: unknown type name ‘student’; use ‘struct’ keyword to refer to the type
   13 |     student s;
      |     ^~~~~~~
      |     struct
Asignar a un campo arreglo. Un arreglo no se asigna con =. Es la misma regla de la semana
9, y estar dentro de un struct no la cambia:
$ gcc -Wall -Wextra -std=c17 errors/assign_name.c -o build/assign_name
errors/assign_name.c: In function ‘main’:
errors/assign_name.c:15:12: error: assignment to expression with array type
   15 |     s.name = "Ana";
      |            ^
Comparar dos struct con ==. C no sabe qué significa que dos estudiantes sean iguales.
Tampoco deberíamos querer que lo adivine. Se compara campo por campo, y las cadenas con
strcmp, de la semana pasada:
$ gcc -Wall -Wextra -std=c17 errors/compare_structs.c -o build/compare_structs
errors/compare_structs.c: In function ‘main’:
errors/compare_structs.c:16:11: error: invalid operands to binary == (have ‘struct student’ and ‘struct student’)
   16 |     if (a == b) {
      |           ^~
Asignar un struct copia todo
Aquí viene lo importante del capítulo sobre struct. A diferencia de un arreglo, un struct
completo sí se asigna con =, y eso copia todos sus campos:
struct student a = {"Ana", {14, 9, 17}};
struct student b = a;

b.name[0] = 'E';
b.grades[0] = 20;
print_student(a);
print_student(b);
$ build/struct_copy
Ana: 14 9 17
Ena: 20 9 17a no cambió. b tiene su propio nombre y sus propias notas. Los arreglos que están dentro
del struct también se copiaron, byte por byte. Aunque C no deja hacer y = x con dos
arreglos sueltos, al copiar un struct que los contiene sí los copia.
Idea clave. Una variable
structes un bloque de bytes con todo adentro, incluidos sus arreglos. Asignarla copia el bloque completo. Después deb = a,aybno comparten nada.
struct y funciones
C pasa los argumentos por valor, como vimos en la semana 7. Un struct no es la excepción.
El parámetro es una copia completa, igual que en b = a. Esta función cambia su copia:
void reset_first(struct student s) {
    s.grades[0] = 0;
    printf("En la función: %d\n", s.grades[0]);
}
Una función también puede devolver un struct. Si queremos que el cambio se note, la
función devuelve la copia cambiada, y quien la llama la guarda:
struct student with_first(struct student s, int grade) {
    s.grades[0] = grade;
    return s;
}
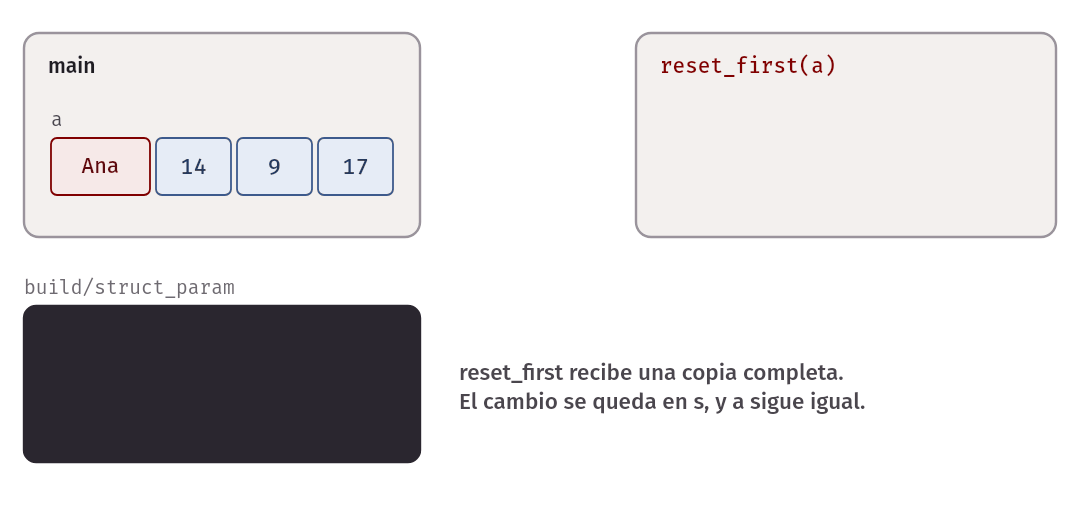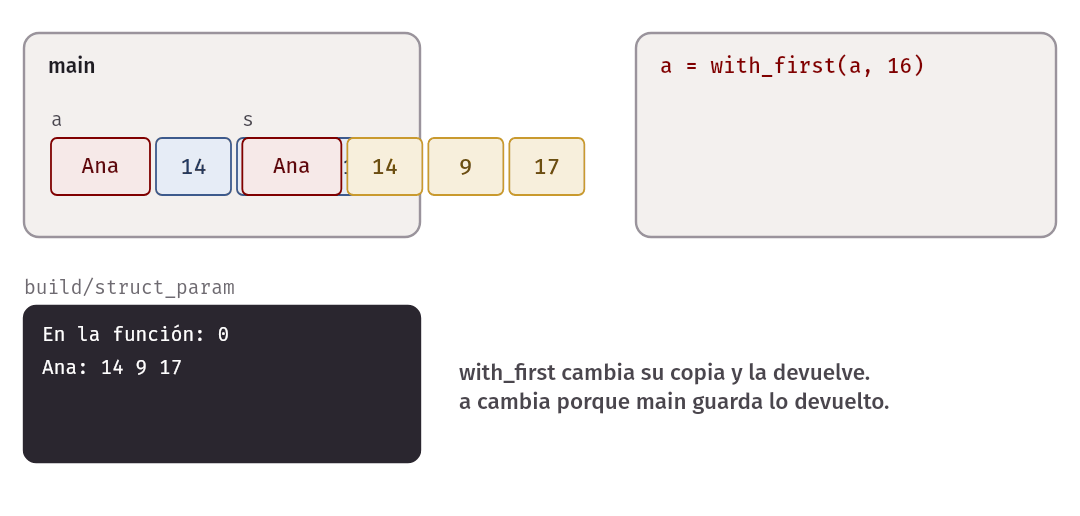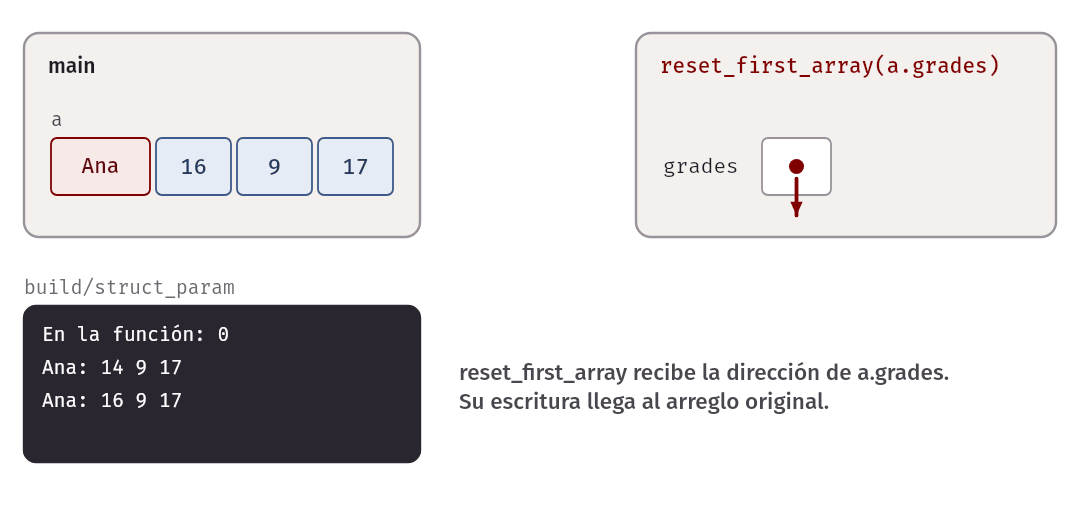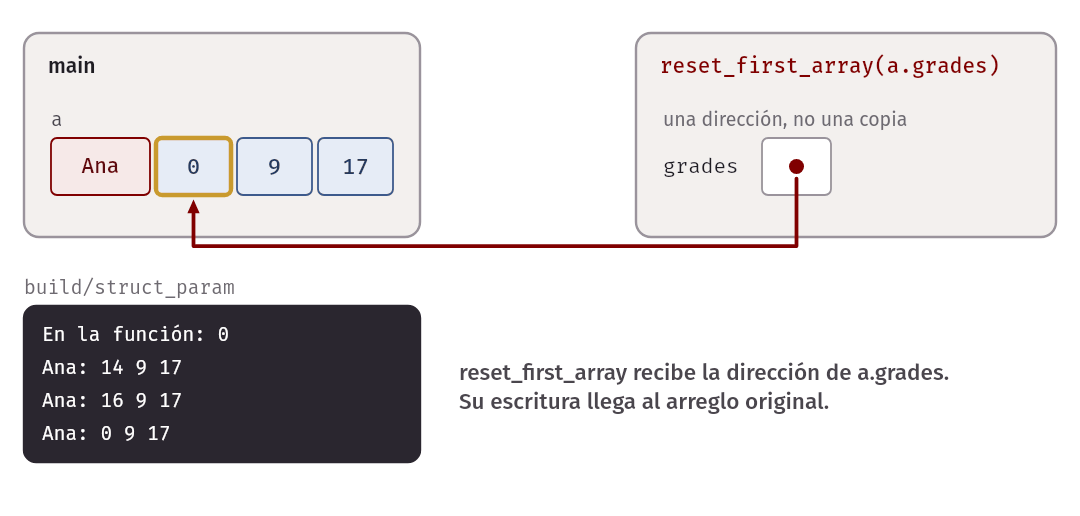
Y una tercera función recibe solamente el arreglo de notas:
void reset_first_array(int grades[]) {
    grades[0] = 0;
}
El programa struct_param.c llama a las tres, una tras otra, y muestra a después de cada
una:
reset_first(a);
print_student(a);

a = with_first(a, 16);
print_student(a);

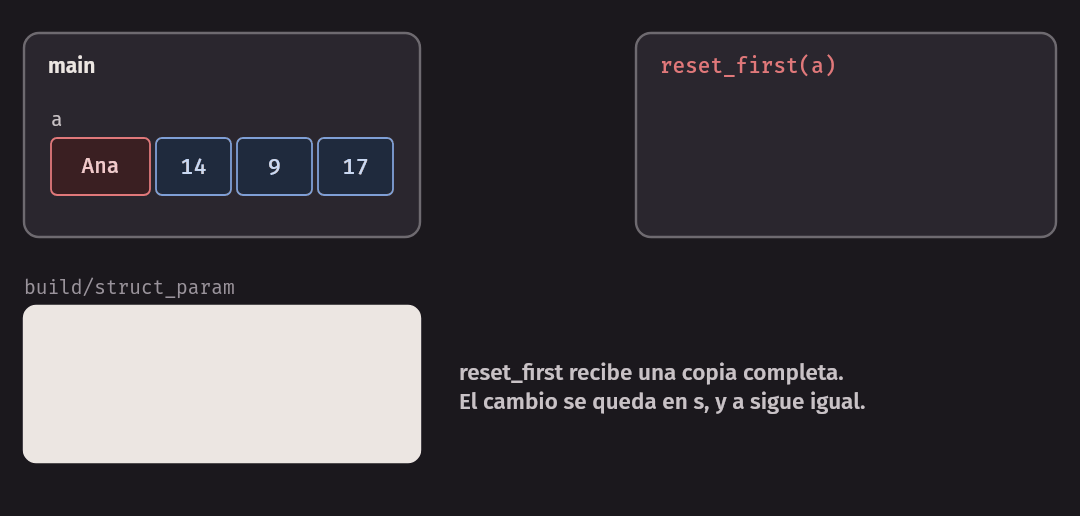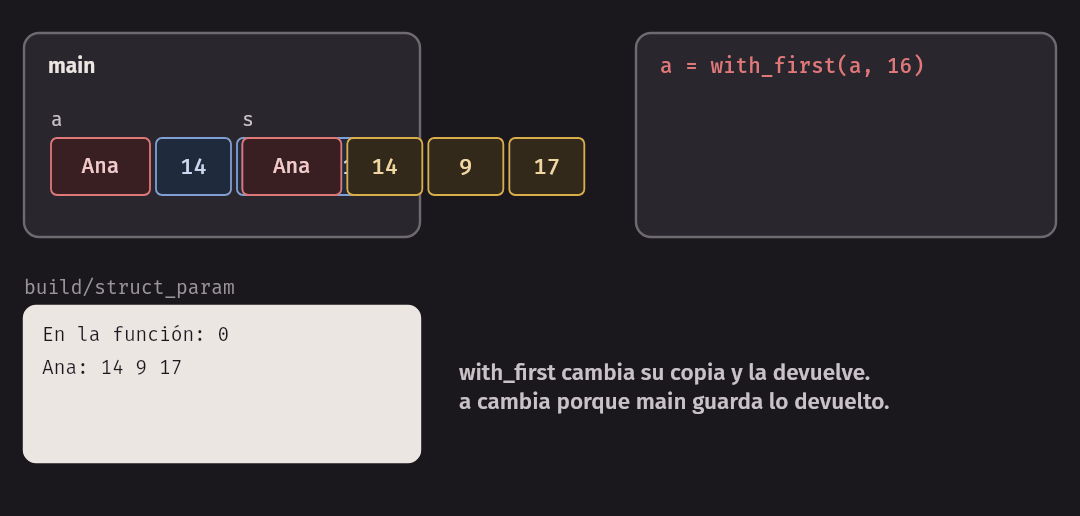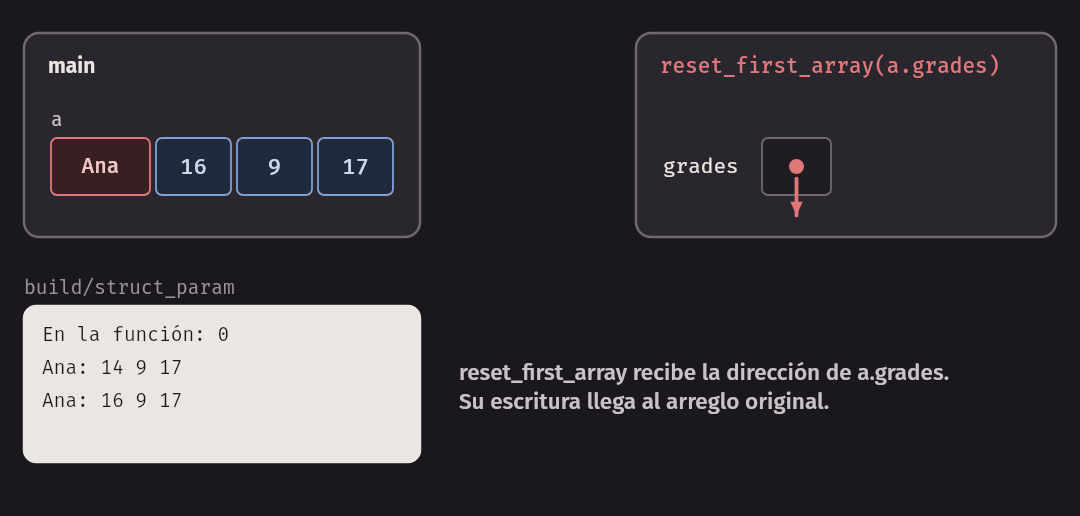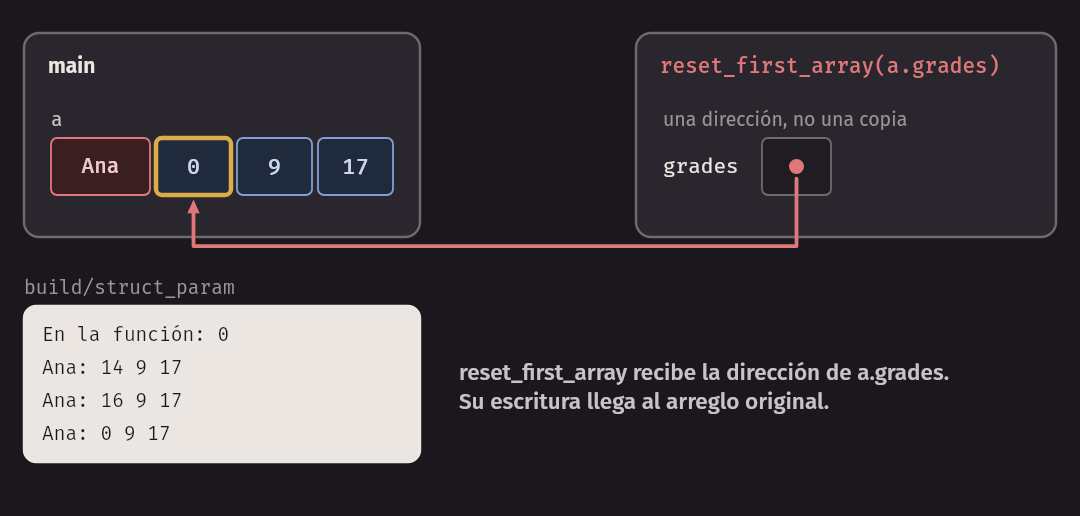
reset_first_array(a.grades);
print_student(a);
$ build/struct_param
En la función: 0
Ana: 14 9 17
Ana: 16 9 17
Ana: 0 9 17Las dos primeras dejan claro lo que pasa con un struct. La tercera sorprende: a.grades es
un arreglo, y al pasar un arreglo, viaja su dirección, como en la semana 10. Por eso esa
función sí cambia la nota original. La diferencia está en qué se pasa:
| Se llama con | Qué se copia al parámetro | ¿Cambia el original? |
|---|---|---|
reset_first(a) |
todo el struct, con sus arreglos |
no |
reset_first_array(a.grades) |
la dirección donde empieza a.grades |
sí |
Error común. Pensar que un arreglo dentro de un
structse comporta como un arreglo parámetro. Si la función recibestruct student s, tiene su propia copia des.grades, y lo que escriba ahí no llega a quien llamó. Cambiar un campo del parámetro no cambia el original.
Copiar tiene un costo: cada llamada copia los 32 bytes de este entorno. Con estos tamaños, no
importa. Con struct muy grandes, en otros cursos se pasa un puntero al struct. En este
curso no lo haremos: se pasan por valor, o dentro de un arreglo, que es lo que sigue.
Arreglos de struct
Un arreglo puede tener elementos de cualquier tipo, también struct. Esta es la forma natural
de guardar una lista de estudiantes. Cada elemento lleva adentro todo lo de una persona:
struct student list[MAX_STUDENTS] = {
    {"Ana", {14, 9, 17}},
    {"Bruno", {8, 10, 11}},
    {"Carla", {11, 11, 11}},
};
int n = 3;
Es un vector, como en la semana 10: la capacidad es MAX_STUDENTS y la longitud es n. Los elementos
que no aparecen entre las llaves quedan en 0. Para leer la expresión
list[1].grades[2], vayan de izquierda a derecha: el elemento 1 de list, su campo grades,
y la casilla 2 de ese arreglo.
Primero, una función sobre un solo estudiante, que recibe una copia y calcula su promedio. En pseudocódigo, un campo se escribe también con punto:
algoritmo promedio(s)
    total ← 0
    para i desde 0 hasta N_NOTAS - 1 hacer
        total ← total + s.notas[i]
    fin para
    devolver total / N_NOTAS
fin algoritmo
double average(struct student s) {
int total = 0;
for (int i = 0; i < N_GRADES; i++) {
total = total + s.grades[i];
}
return (double) total / N_GRADES;
}El cast evita la división entera, igual que en la semana 2. Ahora, una función sobre la lista:
el mejor promedio. Devuelve la posición, y no el struct, para poder responder también
cuando no hay nadie:
algoritmo mejor(lista, n)
    si n ≤ 0 entonces
        devolver -1
    fin si
    mejor_pos ← 0
    para i desde 1 hasta n - 1 hacer
        si promedio(lista[i]) > promedio(lista[mejor_pos]) entonces
            mejor_pos ← i
        fin si
    fin para
    devolver mejor_pos
fin algoritmo
int best_index(const struct student list[], int n) {
if (n <= 0) {
return -1;
}
int best = 0;
for (int i = 1; i < n; i++) {
if (average(list[i]) > average(list[best])) {
best = i;
}
}
return best;
}El parámetro es un arreglo, con las mismas reglas de la semana 10: viaja su dirección, la
longitud va aparte, y lleva const porque solo lee. La llamada average(list[i]), en cambio,
le pasa a average un struct, así que average recibe una copia de ese elemento.
Sigamos best_index con los promedios de Ana, Bruno y Carla, que son 13.33, 9.67 y 11.00:
i |
average(list[i]) |
average(list[best]) |
¿Es mayor? | best al final de la vuelta |
|---|---|---|---|---|
| 1 | 9.67 | 13.33 | no | 0 |
| 2 | 11.00 | 13.33 | no | 0 |
Devuelve 0: Ana. Si hay un empate, se queda con el primero, porque se pide > y no >=.
Eliminar sin olvidar nada
Volvamos al error del principio. Esta es la misma remove_at de la semana 10, ahora con
struct:
int remove_at(struct student list[], int n, int pos) {
    if (pos < 0 || pos >= n) {
        return n;
    }
    for (int i = pos; i < n - 1; i++) {
        list[i] = list[i + 1];
    }
    return n - 1;
}
La línea list[i] = list[i + 1]; copia el nombre y todas las notas juntos. Ya no se puede
olvidar un campo, y si mañana agregamos un campo más, esta función sigue correcta sin cambiar
nada. Esa es la ventaja de un arreglo de struct frente a los arreglos paralelos.
reset_first_grades pone en 0 la primera nota de cada elemento. Como recibe un arreglo, sí
cambia los elementos de quien llama, y por eso su parámetro no lleva const:
$ build/struct_array
Ana: 13.33
Bruno: 9.67
Carla: 11.00
Mejor: Ana
Sin Bruno:
Ana: 13.33
Carla: 11.00
Con la primera nota en 0:
Ana: 8.67
Carla: 7.33
Idea clave. Un
structsuelto llega a una función como copia. Un arreglo destructllega como dirección, igual que cualquier arreglo. Si una función debe cambiar datos de quien la llama, una forma de lograrlo es recibir el arreglo; la otra es devolver elstructcambiado.
El tamaño de un struct
¿Siempre es el tamaño de un struct la suma de sus campos? No. Veamos dos tipos con los mismos
campos, en distinto orden:
struct mixed {
    char first;
    int number;
    char last;
};

struct sorted {
    int number;
    char first;
    char last;
};
$ build/struct_size
sizeof(char) = 1, sizeof(int) = 4
sizeof(struct mixed) = 12
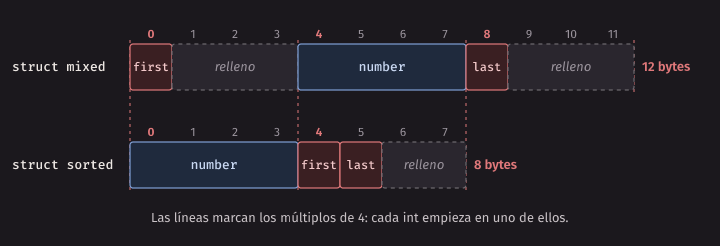
sizeof(struct sorted) = 8Los campos suman 6 bytes, pero los tamaños son 12 y 8. En este entorno, el compilador ubica cada int en una dirección
múltiplo de 4. Para lograrlo, deja bytes sin usar, llamados relleno (padding): en struct mixed, tres después
de first y tres al final, para que un arreglo de estos struct también quede alineado.
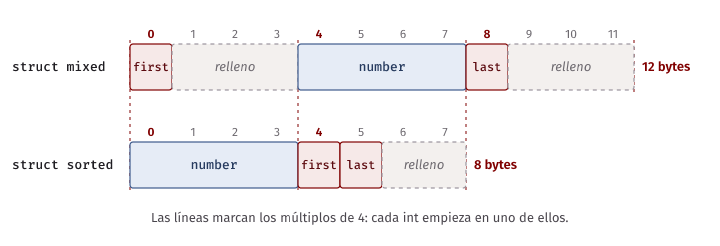
Los números de arriba valen en este entorno. El lenguaje solo promete que los campos quedan en
orden y que el primero está al inicio del struct. Por eso, para saber un tamaño, se usa
sizeof, y no se suma a mano.
Qué es un archivo
En la semana 9 vimos que la RAM se borra al apagar, y que lo que está en el almacenamiento se queda. Vimos también que la idea de archivo la pone el sistema operativo. Un archivo (file) es una secuencia de bytes con nombre, guardada por el sistema operativo. Nada más. No tiene filas, ni columnas, ni notas. Solo bytes.
El archivo de esta semana, estudiantes.txt, tiene una línea por estudiante. Lo miramos con wc -c y con xxd, de la semana 3:
$ wc -c estudiantes.txt
116 estudiantes.txt
$ xxd estudiantes.txt | head -2
00000000: 416e 6120 3134 2039 2031 370a 4272 756e  Ana 14 9 17.Brun
00000010: 6f20 3820 3130 2031 310a 4361 726c 6120  o 8 10 11.Carla
| head -2 deja pasar solo las dos primeras líneas. Miren los bytes y encuentren tres cosas:
- Una línea no es nada especial. Es lo que hay entre dos bytes
0a, el salto de línea\n.xxdlo muestra como un punto en la columna de la derecha. - El número 14 no está guardado como número. Son dos caracteres:
31y34, los códigos ASCII de1y4. Un archivo así se llama archivo de texto: todos sus bytes son texto. Para hacer cuentas, habrá que convertir esos caracteres en unint. - El archivo no tiene marca de fin. A diferencia de una cadena, no hay ningún
\0al final: el sistema operativo sabe cuánto mide. Mide 116 bytes, y cuando un programa los termina de leer, ya no hay más.
Una línea sin \n al final también es posible, como vieron en el laboratorio de la semana 5.
Abrir, leer y cerrar
Usar un archivo siempre tiene tres pasos: abrir, leer o escribir, y cerrar. Abrir le pide al sistema operativo el archivo. Si se puede, nos entrega algo para referirnos a él en adelante.
fopen y FILE *
FILE *file = fopen(path, "r");fopen, de stdio.h, recibe el nombre del archivo como cadena, y un modo como otra
cadena. Con "r", de read, el archivo se abre para leer. Devuelve un valor de tipo FILE *.
En la semana 10 aprendieron a leer int *: “dirección de un int”. Del mismo modo, FILE *
se lee “dirección de un FILE”, y un FILE es lo que la biblioteca usa para llevar la cuenta
de un archivo abierto. Dijimos entonces que no íbamos a declarar punteros. FILE * es una excepción,
y es solo para esto: guardar lo que devuelve fopen, compararlo
con NULL y pasarlo a otras funciones. Nunca se usa el * ni se hacen cuentas con él. Pueden
verlo como un número de atención: lo entrega fopen, y lo muestran en cada trámite con ese
archivo.
Un nombre como estudiantes.txt se busca desde la carpeta actual de la semana 1, y no
desde la carpeta del programa. Lo veremos en un momento.
Revisar NULL con perror
fopen puede fallar: el archivo no existe, o no hay permiso, o el nombre está mal. Cuando
falla, devuelve NULL, el valor de la semana 10 que significa “ninguna dirección”. Siempre
se revisa:
if (file == NULL) {
    perror(path);
    return 1;
}
perror también es de stdio.h. Escribe la cadena que le damos, dos puntos, y la razón que
dio el sistema:
$ echo no_hay.txt | build/show_file
no_hay.txt: No such file or directory
El texto de la razón lo pone la biblioteca del sistema, y puede cambiar con el sistema o con su idioma. Y debe llamarse justo después de la función que falló: otra llamada de por medio podría cambiar la razón guardada.
¿Qué pasa si no se revisa? El programa errors/no_check.c usa
el resultado de fopen sin mirarlo. gcc no avisa nada. Darle NULL a fgets es
comportamiento indefinido. Esto salió en esta corrida, en este entorno. El informe está
recortado:
$ gcc -Wall -Wextra -std=c17 errors/no_check.c -o build/no_check
$ build/no_check; echo "estado: $?"
bash: line 1: 92954 Segmentation fault      build/no_check
estado: 139
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/no_check.c -o build/no_check_san
$ build/no_check_san
errors/no_check.c:10:12: runtime error: null pointer passed as argument 3, which is declared to never be null
==92961==ERROR: AddressSanitizer: SEGV on unknown address 0x000000000000 (pc 0xffff86c5f950 bp 0xfffff29b4760 sp 0xfffff29b4760 T0)
    #2 0xaaaac5980f04 in main errors/no_check.c:10
El segmentation fault ya lo vimos en la semana 10. Lo que debía ser un aviso claro, “ese archivo no existe”, se volvió un programa muerto, y sin ninguna pista para quien lo usa.
stdout y stderr
¿Dónde escribe perror? No en la misma salida de printf. Todo programa empieza con tres
canales abiertos, que se usan igual que un archivo, y por eso stdin y fgets funcionaron en la semana 10 sin ningún
fopen:
| Nombre | Para qué | Normalmente va a |
|---|---|---|
stdin |
entrada estándar | el teclado |
stdout |
salida estándar, donde escribe printf |
la pantalla |
stderr |
salida de errores, donde escribe perror |
la pantalla |
En la pantalla se ven juntas. Pero la redirección > de la semana 2 solo desvía stdout, así
que el resultado va al archivo y los avisos siguen a la vista. Para desviar stderr se usa
2>. Es la forma correcta de separar el resultado de los problemas.
Leer línea por línea
fgets ya la conocen. El tercer parámetro, que era stdin, ahora es nuestro archivo. El
programa show_file.c lee el nombre del archivo con fgets y escribe sus líneas numeradas.
Quita el \n con remove_newline, la de la semana 10. El ciclo es el mismo de esa semana, en
pseudocódigo y en C:
algoritmo mostrar(ruta)
    archivo ← abrir(ruta)
    si archivo no se pudo abrir entonces
        escribir la razón
        devolver 1
    fin si
    numero ← 0
    leer linea de archivo
    mientras linea existe hacer
        numero ← numero + 1
        escribir numero, linea
        leer linea de archivo
    fin mientras
    cerrar(archivo)
    devolver 0
fin algoritmo
char line[LINE_SIZE];
int number = 0;
while (fgets(line, LINE_SIZE, file) != NULL) {
remove_newline(line);
number++;
printf("%d: %s\n", number, line);
}
fclose(file);$ echo estudiantes.txt | build/show_file
1: Ana 14 9 17
2: Bruno 8 10 11
3: Carla 11 11 11
4: Diego 12 10 10
5: Elena 20 18 19
6: Begoña 15 13 13
7: Fabio 5 7 0
8: Gisela 10 11 12
Total: 8 líneasfgets recuerda dónde iba. Cada llamada sigue justo después de lo que leyó la anterior. Cuando
no queda nada, devuelve NULL y el ciclo termina. Con un archivo vacío, la primera llamada ya
da NULL, y el programa sigue sin problemas:
$ echo estudiantes_vacio.txt | build/show_file
Total: 0 líneas
Y fclose cierra el archivo: le dice al sistema que ya terminamos. Un programa puede tener
abierta solo una cantidad limitada de archivos, así que todo fopen que funcionó lleva su
fclose.
Aquí se ve lo de la carpeta actual. cd build cambia de carpeta antes de correr el programa.
Ahí no hay ningún estudiantes.txt, aunque el ejecutable sea el mismo. .. es la carpeta de arriba, como en la semana 1, y
tail -1 deja pasar solo la última línea:
$ cd build; echo estudiantes.txt | ./show_file; cd ..
estudiantes.txt: No such file or directory
$ cd build; echo ../estudiantes.txt | ./show_file | tail -1; cd ..
Total: 8 líneas
En C.
fgetstambién devuelveNULLsi hubo un error de lectura, no solo al final del archivo. Abrir una carpeta como si fuera un archivo es un ejemplo: en este entorno,fopenfunciona, yfgetsfalla de inmediato. Este programa no distingue los dos casos. Dice cero líneas, como con un archivo vacío:$ echo build | build/show_file Total: 0 líneasPara distinguirlos existe
ferror(file), que después defgetsdice si hubo un error. Lo dejamos aquí como un límite de nuestros programas.
El ciclo con feof: un error clásico
feof(file) dice si ya se intentó leer más allá del final. Parece la condición perfecta para
un ciclo. No lo es:
while (!feof(file)) {
    fgets(line, LINE_SIZE, file);
    printf("%s", line);
}
$ gcc -Wall -Wextra -std=c17 errors/feof_loop.c -o build/feof_loop
$ build/feof_loop
arroz 4.50 2
leche 3.80 6
pan 0.50 10
azúcar 3.20 tres
atún 5.90 3
atún 5.90 3La última línea sale dos veces. Sigamos las últimas vueltas, con un archivo que termina en
\n:
| Vuelta | ¿feof? |
Qué hace fgets |
Qué tiene line |
Qué escribe |
|---|---|---|---|---|
| 5 | no | lee atún 5.90 3, y se detiene en el \n |
atún 5.90 3 |
atún 5.90 3 |
| 6 | no | intenta leer, no hay nada, devuelve NULL |
lo mismo de antes | atún 5.90 3 |
| 7 | sí | el ciclo termina |
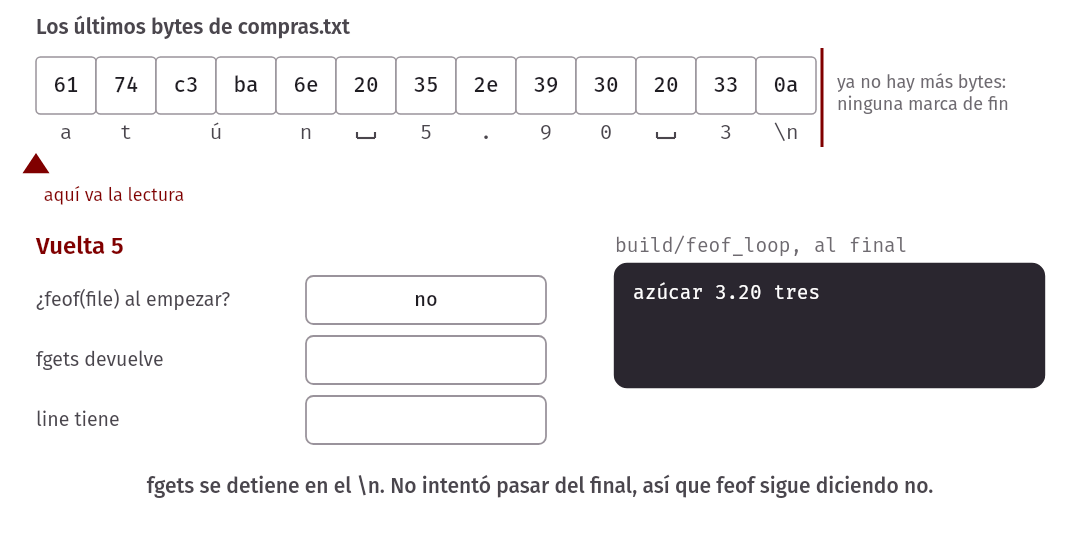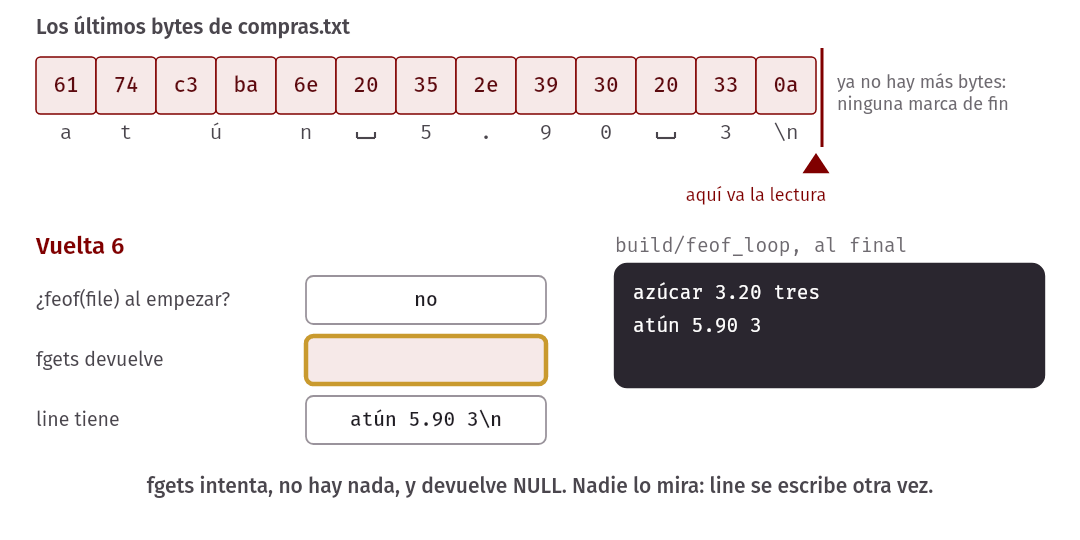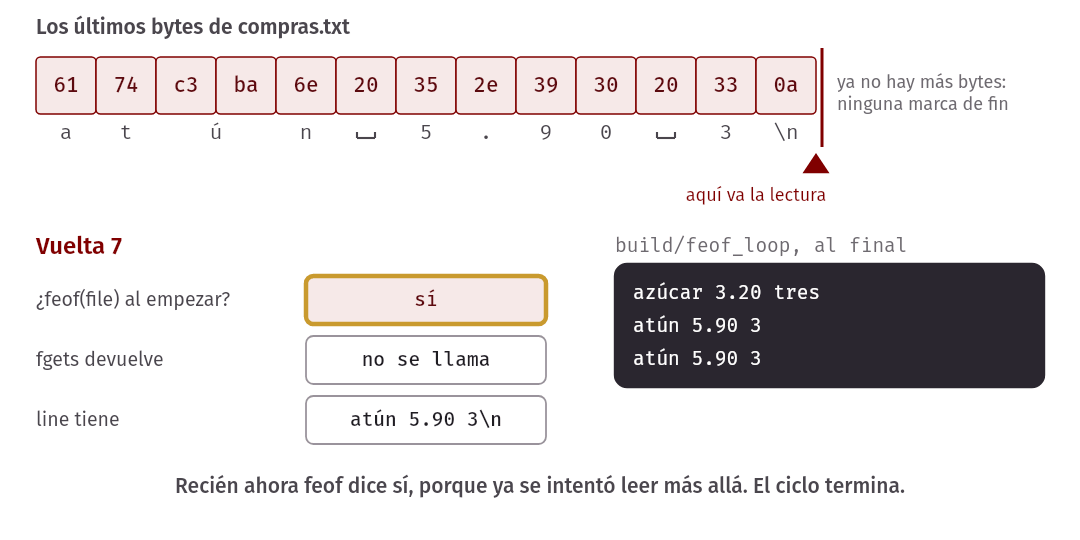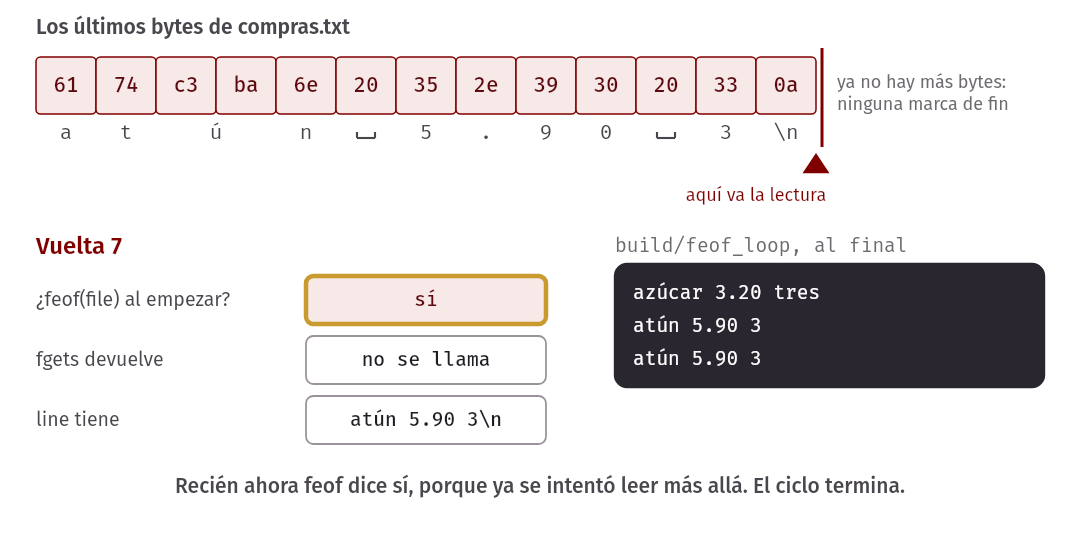
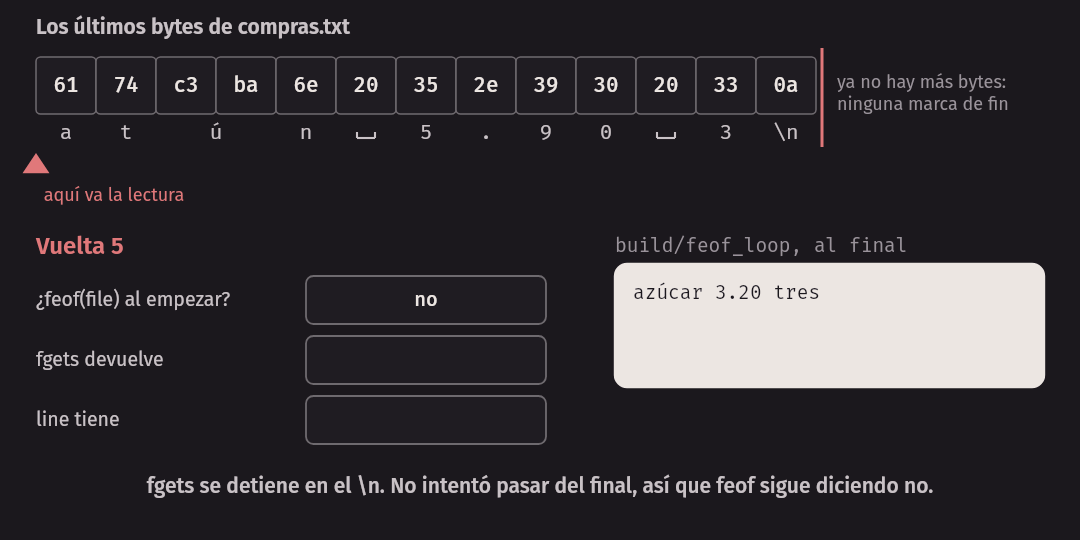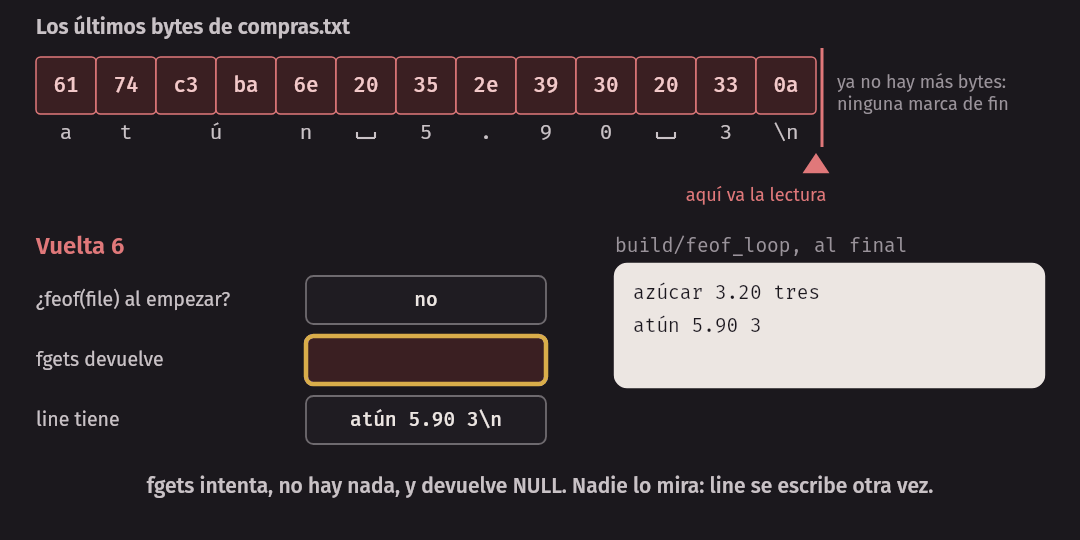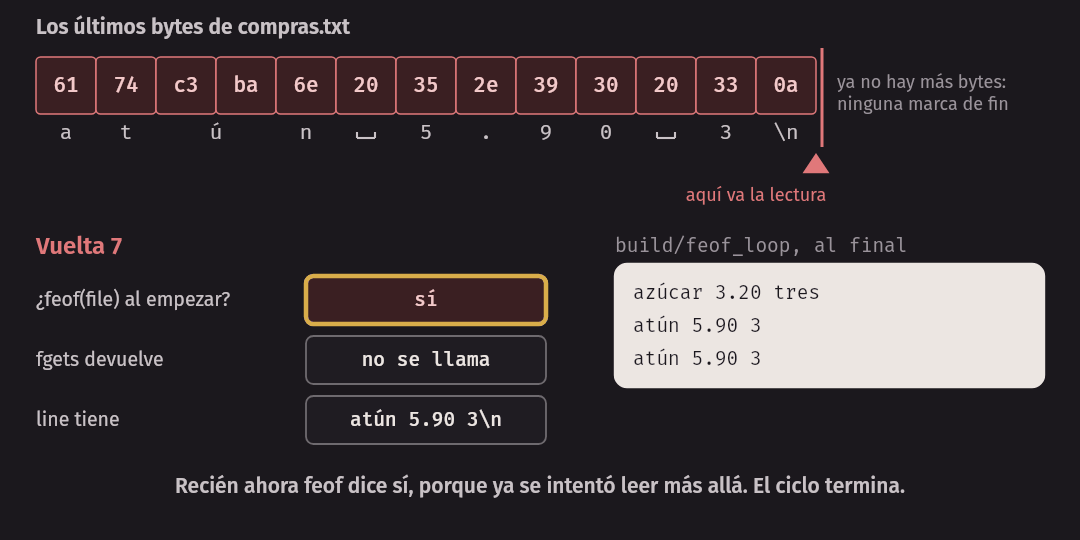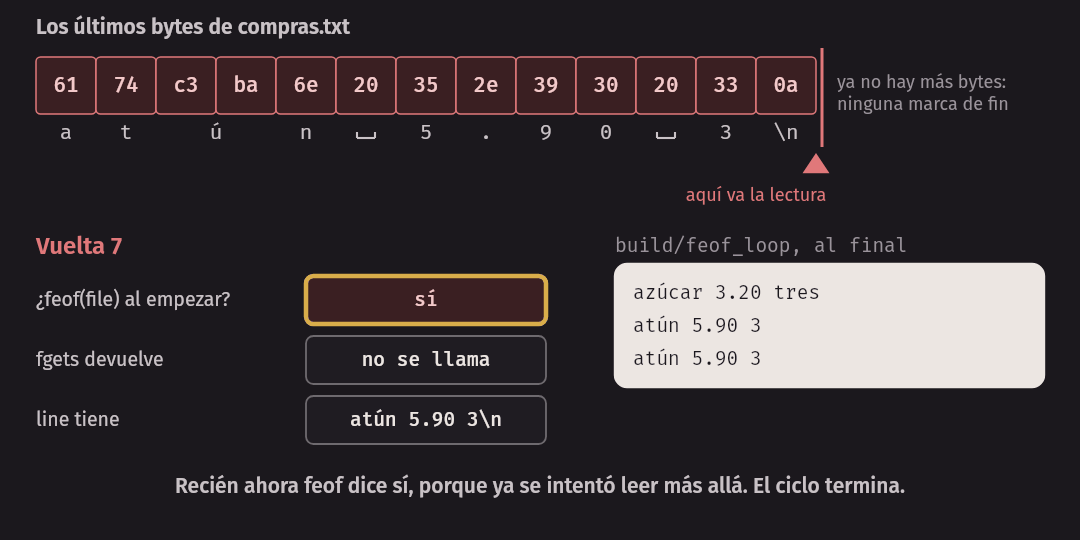
En la vuelta 5, fgets se detuvo en el \n, y no intentó pasar del final, así que feof
sigue en falso. feof no anticipa: solo informa lo que ya pasó. En la vuelta 6, nadie mira que
fgets devolvió NULL, y line sigue con el texto anterior. Con un archivo vacío es peor,
porque line nunca recibió nada: escribirla es comportamiento indefinido.
Error común.
while (!feof(file)). La forma correcta es la que ya tienen:while (fgets(line, SIZE, file) != NULL). La condición del ciclo es el resultado de la lectura.
Escribir un archivo
Para escribir, se abre en otro modo:
| Modo | Si el archivo existe | Si no existe | Para qué |
|---|---|---|---|
"r" |
lo lee desde el inicio | fopen devuelve NULL |
leer |
"w" |
lo deja vacío | lo crea | escribir de cero |
"a" |
agrega al final | lo crea | agregar |
Y se escribe con fprintf. Es printf, con un primer parámetro más: dónde escribir.
fprintf(file, "Nota final: %d\n", 15);printf(...) es lo mismo que fprintf(stdout, ...). Con fprintf(stderr, ...) escribimos
nuestros propios avisos en la salida de errores.
El modo "w" borra
El modo "w" no pregunta. Si el archivo ya existía, su contenido desaparece al abrir,
antes de escribir nada. Es lo mismo que hace la redirección > de la semana 2.
$ echo "texto viejo" > build/nota.txt
$ wc -c build/nota.txt
12 build/nota.txt
$ build/write_note
$ cat build/nota.txt
Nota final: 15
$ build/append_note
$ build/append_note
$ cat build/nota.txt
Nota final: 15
Otra línea
Otra línea
write_note usa "w": el texto viejo ya no está. append_note usa "a": cada corrida agrega
una línea.
Error común. Abrir el archivo de salida antes de saber si los datos sirven. Si el programa abre con
"w"y recién después descubre que el archivo de entrada no existe, ya borró el resultado anterior. Primero se lee, y se abre la salida al final. Y si la salida tiene el mismo nombre que la entrada, el contenido original se reemplaza.
Cerrar importa más al escribir
fprintf puede no llevar los bytes al archivo de inmediato. Igual que vimos con printf en la
semana 10, la biblioteca los guarda un rato en un buffer y los escribe de una vez, para no
molestar al sistema por cada línea. El programa errors/no_close.c escribe una línea y, sin
cerrar, abre el mismo archivo para leerlo. Esto salió en esta corrida; el momento exacto en que
se escribe depende de la biblioteca:
$ gcc -Wall -Wextra -std=c17 errors/no_close.c -o build/no_close
$ build/no_close
El archivo todavía está vacío
El archivo tiene: Nota: 15
La segunda línea sale después de fclose. Al cerrar, se escribe lo pendiente. Por eso, cuando
se escribe, se revisa también el resultado de fclose: si el disco se llenó, puede ser ahí
donde se entere el programa. Devuelve 0 si todo salió bien:
if (fclose(file) != 0) {Si el programa termina normalmente, la biblioteca cierra lo que quedó abierto. Pero si muere
antes, lo pendiente se pierde. Al leer, en cambio, no hay nada pendiente que escribir, y por
eso en este curso no revisamos el fclose de un archivo abierto con "r".
Separar campos con sscanf
Ya sabemos leer una línea. Ahora hay que convertir "Ana 14 9 17" en un nombre y tres enteros.
sscanf es scanf, pero lee de una cadena en vez de la entrada. El primer parámetro es la
cadena. Todo lo demás es lo que ya conocen. Y devuelve lo mismo: cuántos campos pudo
convertir.
int fields = sscanf(line, "%19s %d %d %d %1s", name, &a, &b, &c, extra);name no lleva &, como en la semana 10, porque ya entrega una dirección. %19s tiene el
límite para un buffer de 20 bytes. Un espacio en el formato acepta cualquier cantidad de
espacios en la línea. ¿Y el último %1s? Es una trampa para detectar algo de más. extra es
un buffer de 2 bytes, donde no debería llegar nada. Si la línea trae algo después de las tres
notas, ese campo sí se convierte.
El programa parse_fields.c prueba esta llamada con varias líneas. %2d da un ancho de 2 para
el número, como vimos en la semana 4:
$ build/parse_fields
 4  "Ana 14 9 17"
 4  "  Ana   14 9   17  "
 3  "Ana 14 9"
 1  "Ana diez 9 17"
 2  "Ana 14.5 9 17"
 5  "Ana 14 9 17 5"
 1  "Maria_de_los_Angeles_Quispe 14 9 17"
-1 ""| Resultado | Línea | Qué pasó |
|---|---|---|
| 4 | Ana 14 9 17 |
Es lo que buscamos: nombre y tres notas |
| 4 | con espacios de más | También: los espacios no importan |
| 3 | Ana 14 9 |
Falta una nota |
| 1 | Ana diez 9 17 |
%d no entiende diez, y sscanf se detiene ahí |
| 2 | Ana 14.5 9 17 |
El primer %d lee 14 y se detiene en el punto; el siguiente %d no entiende .5 |
| 5 | Ana 14 9 17 5 |
Sobra algo: lo recogió %1s |
| 1 | nombre muy largo | %19s guarda 19 bytes; lo que queda no es un número |
| -1 | vacía | No había nada que convertir: sscanf devuelve EOF, que es negativo |
Para la forma de la línea, basta una condición: fields debe ser exactamente 4. El caso 14.5 muestra por qué conviene revisar: si solo hubiéramos pedido una nota,
habríamos aceptado 14 como si estuviera bien.
Error común. No mirar lo que devuelve
sscanf. En una línea mal formada, las variables que no se convirtieron se quedan como estaban. Si no tenían valor, leerlas es comportamiento indefinido. Que un campo se haya llenado no dice nada sobre los demás.
Hay dos cosas que sscanf no revisa. Que el dato tenga sentido: Ana 25 9 17 da 4, y
un 25 no es una nota válida si la escala es de 0 a 20, así que el rango lo revisa el programa. Que el número
quepa en un int: si no cabe, el comportamiento es indefinido según C, igual que con
scanf, y sscanf no promete ningún aviso. Nuestros programas no resuelven ese caso. Para
hacerlo bien se usan otras funciones, como strtol, que no vemos.
Una línea más larga que el buffer
¿Qué hace fgets si la línea es más larga que el buffer? Ya lo
vieron: guarda size - 1 bytes, y la siguiente llamada sigue donde quedó. Sin cuidado, una
línea larga se lee como varias líneas, y el resto podría hasta parecer válido.
¿Cómo se detecta? Por el \n: si no está, la línea no cupo. Pero recuerden la Idea clave de la
semana 10: también puede faltar porque es la última línea y no tiene salto. Hay un tercer caso:
que la línea haya llenado el buffer justo, y el \n sea lo único que no entró. Para saber cuál
es, se mira el byte siguiente con fgetc. fgetc(file) es como getchar, pero lee del
archivo que le damos, y devuelve EOF al final.
Después de fgets |
Byte siguiente | Qué pasó | Qué hacer |
|---|---|---|---|
hay \n |
no hace falta mirarlo | la línea cupo | quitar el \n |
no hay \n |
EOF |
última línea, sin salto | usarla |
no hay \n |
\n |
cupo justo | usarla |
no hay \n |
otro | no cupo | descartar hasta el final de la línea y avisar |
algoritmo leer_linea(archivo, linea, tamano)
    si no se pudo leer linea de archivo, con el límite tamano, entonces
        devolver FIN
    fin si
    si linea trae salto entonces
        quitar el salto
        devolver BIEN
    fin si
    c ← siguiente byte de archivo
    si c = salto o c = fin de archivo entonces
        devolver BIEN
    fin si
    mientras c ≠ salto y c ≠ fin de archivo hacer
        c ← siguiente byte de archivo
    fin mientras
    devolver MUY_LARGA
fin algoritmo
int read_line(FILE *file, char line[], int size) {
if (fgets(line, size, file) == NULL) {
return READ_END;
}
if (remove_newline(line)) {
return READ_OK;
}
int c = fgetc(file);
if (c == '\n' || c == EOF) {
return READ_OK;
}
while (c != '\n' && c != EOF) {
c = fgetc(file);
}
return READ_TOO_LONG;
}READ_END, READ_OK y READ_TOO_LONG son constantes con #define, para no devolver números
sueltos. c es int por la misma razón que en discard_rest.
El programa long_line.c tiene un buffer de 16 bytes, y lee largas.txt. La primera línea,
una linea corta, tiene 15 bytes: es el caso que cupo justo.
$ build/long_line
Línea 1: "una linea corta"
Línea 2: no cabe en 16 bytes, se descarta
Línea 3: "otra corta"
La línea 3 sigue siendo la línea 3. Sin descartar, los pedazos de la línea 2 habrían corrido la numeración.
Un programa de principio a fin
Juntemos todo en un programa nuevo, receipt.c. Lee una lista de compras y escribe una boleta.
Cada línea de compras.txt tiene un producto de una palabra, un precio y una cantidad:
$ cat compras.txt
arroz 4.50 2
leche 3.80 6
pan 0.50 10
azúcar 3.20 tres
atún 5.90 3
La cuarta línea está mal a propósito. El programa no debe romperse: debe avisar y seguir. El plan se decide antes de escribir código:
algoritmo procesar(entrada, salida)
    n ← leer_productos(entrada, productos, CAPACIDAD)
    si n < 0 entonces
        devolver 1
    fin si
    si n = 0 entonces
        escribir "no hay productos"
        devolver 1
    fin si
    si no escribir_boleta(salida, productos, n) entonces
        devolver 1
    fin si
    escribir "Productos: ", n
    devolver 0
fin algoritmo
Noten el orden: la salida se abre solo cuando ya sabemos que hay algo que escribir.
Los datos van en un struct:
struct item {
    char name[NAME_SIZE];
    double price;
    int quantity;
};
Los nombres de los dos archivos llegan por la entrada, en dos líneas.
Una línea
parse_item trata de leer una línea. Si la línea sirve, guarda el producto en una posición del
arreglo. Aquí se ve por qué recibe el arreglo: como un struct suelto llegaría por copia, no
podría entregar el resultado a quien llama. Así, devuelve si tuvo éxito, y escribe en
items[pos]. %lf es el formato de double, de la semana 2, y &it.price es la dirección
del campo price.
int parse_item(const char line[], struct item items[], int pos) {
    struct item it;
    char extra[2];
    int fields = sscanf(line, "%19s %lf %d %1s", it.name, &it.price, &it.quantity, extra);
    if (fields != 3 || it.price < 0 || it.quantity <= 0) {
        return 0;
    }
    items[pos] = it;
    return 1;
}
%lf también acepta los textos nan e inf, y este programa no los rechaza. Es un límite
que conviene conocer: un programa real tendría que decidir qué hacer con ellos.
Primero llena una variable local, y solo si todo está bien la copia al arreglo, con una
asignación de struct.
Todo el archivo
algoritmo leer_productos(ruta, productos, capacidad)
    archivo ← abrir(ruta)
    si archivo no se pudo abrir entonces
        escribir la razón
        devolver -1
    fin si
    cuenta ← 0
    numero ← 0
    resultado ← leer_linea(archivo, linea, tamano)
    mientras resultado ≠ FIN hacer
        numero ← numero + 1
        si cuenta = capacidad entonces
            escribir "demasiados productos"
            salir del ciclo
        fin si
        si resultado = BIEN y linea es válida entonces
            cuenta ← cuenta + 1
        sino
            escribir "línea ", numero, " mal formada"
        fin si
        resultado ← leer_linea(archivo, linea, tamano)
    fin mientras
    cerrar(archivo)
    devolver cuenta
fin algoritmo
char line[LINE_SIZE];
int count = 0;
int number = 0;
int result = read_line(file, line, LINE_SIZE);
while (result != READ_END) {
number++;
if (count == capacity) {
fprintf(stderr, "Demasiados productos: solo se leen %d\n", capacity);
break;
}
if (result == READ_OK && parse_item(line, items, count)) {
count++;
} else {
fprintf(stderr, "Línea %d: mal formada, se omite\n", number);
}
result = read_line(file, line, LINE_SIZE);
}
fclose(file);
return count;Tres detalles que protegen al programa:
count == capacityse revisa antes de guardar. Con un archivo más largo que el arreglo, sin esto, se escribiría fuera del arreglo. El aviso sale solo si de verdad queda otra línea: con la capacidad justa, el ciclo termina sin pasar por ahí.break, de la semana 5, sale del ciclo.countynumberson dos cuentas distintas.countdice cuántos productos hay guardados.numberdice en qué línea del archivo vamos, para que el aviso lleve el número que una persona puede buscar en el archivo. Las líneas malas cuentan ennumber, no encount.&&se detiene en el primer falso. Si la línea no cupo,parse_itemno se llama.
Probarlo con lo bueno y con lo malo
$ printf 'compras.txt\nbuild/boleta.txt\n' | build/receipt
Línea 4: mal formada, se omite
Productos: 4
$ cat build/boleta.txt
arroz 2 x 4.50 = 9.00
leche 6 x 3.80 = 22.80
pan 10 x 0.50 = 5.00
atún 3 x 5.90 = 17.70
Total: S/ 54.50
Comprobemos a mano el total: 9.00 + 22.80 + 5.00 + 17.70 son 54.50. Ahora, con los casos
difíciles. $? es el estado de salida:
$ printf 'no_hay.txt\nbuild/boleta.txt\n' | build/receipt; echo "estado: $?"
no_hay.txt: No such file or directory
estado: 1
$ wc -l build/boleta.txt
5 build/boleta.txt
La boleta anterior sigue intacta, porque el programa nunca llegó a abrirla. Y si queremos
guardar los avisos aparte, 2> los manda a otro archivo:
$ printf 'compras.txt\nbuild/boleta.txt\n' | build/receipt 2> build/avisos.txt
Productos: 4
$ cat build/avisos.txt
Línea 4: mal formada, se omite
Idea clave. Un programa que procesa archivos se prueba sobre todo con lo que puede salir mal: el archivo que no existe, el vacío, una línea rota, una línea larga, y más datos de los que caben. Debe avisar, seguir si puede, y no dejar basura.
El laboratorio, paso a paso
El laboratorio está en
code/week-12/lab/process_students.c. Los
comentarios dicen exactamente qué debe hacer cada función. make test-lab las comprueba: falla
hasta que terminen. Aquí están las ideas, no todo el código. receipt.c les sirve de modelo,
pero los datos son otros.
Lee estudiantes.txt, y escribe un archivo con los aprobados y su promedio. En este
laboratorio, como en el de la semana 4, se aprueba con 11. Los nombres de los dos archivos
llegan por la entrada:
printf 'estudiantes.txt\nbuild/aprobados.txt\n' | build/lab/process_studentsParte 1: leer el archivo en un arreglo de struct
Escriban read_line, que ya vieron, parse_student, read_students y el main que las usa. parse_student se
parece a parse_item. Cuiden tres cosas: fields debe ser exactamente 4, cada nota debe estar
entre 0 y 20, y lo que sobra debe invalidar la línea. Piensen cómo revisar las notas con un
ciclo.
Parte 2: escribir los aprobados
Escriban average, is_passed y write_passed. Sobre is_passed, piensen en una trampa. Se
aprueba con promedio 11 o más. Podrían comparar average(s) >= 11, y aquí funcionaría, pero en
la semana 3 vimos que double no es exacto, así que es mejor evitar la duda. Como el promedio
es la suma dividida entre 3, tener promedio al menos 11 es lo mismo que tener suma al menos 33.
Esa es una comparación de enteros, sin ninguna duda:
algoritmo aprobo(s)
    devolver suma de las notas de s ≥ NOTA_MINIMA * N_NOTAS
fin algoritmo
Sigan a mano estos casos, antes de programar:
| Notas | Suma | Promedio | ¿Aprobó? |
|---|---|---|---|
| 11, 11, 11 | 33 | 11.00 | sí |
| 10, 11, 12 | 33 | 11.00 | sí |
| 12, 10, 10 | 32 | 10.67 | no |
| 14, 9, 17 | 40 | 13.33 | sí |
Parte 3: que no se rompa
La carpeta trae estudiantes_vacio.txt, que tiene 0 bytes, y estudiantes_malos.txt, con
varias líneas mal formadas. Pruébenlos, con un archivo que no existe también, y comparen con
esta tabla:
| Entrada | Qué se espera | Estado | ¿Archivo de salida? |
|---|---|---|---|
estudiantes.txt |
Leídos: 8. Aprobados: 5. |
0 | sí |
estudiantes_malos.txt |
un aviso por cada línea mala, y Leídos: 3. Aprobados: 2. |
0 | sí |
estudiantes_vacio.txt |
estudiantes_vacio.txt: no hay estudiantes |
1 | no se crea |
| un archivo que no existe | el mensaje de perror |
1 | no se toca |
Una línea vacía también es una línea mal formada. Las pruebas revisan además los bordes: una
línea sin \n al final, una línea demasiado larga, y un archivo con más de 50 estudiantes.
Revisan también que se cierren los archivos: las pruebas bajan el límite de archivos abiertos y
llaman muchas veces a read_students. Para ver cada falla, make test-lab muestra qué se
esperaba y qué salió.
Resumen
- Un
structagrupa datos relacionados bajo un nombre, cada uno con su tipo. A un campo se llega con un punto:s.name. El tipo se llamastruct student. - Asignar un
structcon=copia todos sus campos, también los arreglos que tiene adentro. Con==no se puede comparar. - Pasar un
structa una función pasa una copia: cambiar un campo del parámetro no cambia el original. Para entregar un cambio, se devuelve elstruct. Un arreglo, en cambio, viaja como dirección, también si esa.gradeso una lista destruct. - Un arreglo de
structmantiene juntos los datos de cada persona.sizeofde unstructpuede ser mayor que la suma de sus campos, por el relleno, según el entorno. - Un archivo es una secuencia de bytes con nombre, guardada por el sistema operativo. Una línea es lo que hay entre saltos.
fopendevuelve unFILE *, oNULLsi falla. Siempre se revisa, yperrordice la razón porstderr. Un nombre relativo se busca desde la carpeta actual.- El ciclo correcto mira el resultado de
fgets:while (fgets(line, SIZE, file) != NULL). Nuncawhile (!feof(file)). - El modo
"w"deja vacío el archivo al abrir,"a"agrega al final.fprintfescribe comoprintf.fclosecierra y escribe lo pendiente, y al escribir se revisa su resultado. sscanfsepara los campos de una línea, y devuelve cuántos convirtió. Se exige el número exacto, y el programa revisa si los valores tienen sentido.- Sin
\nal final de lo leído, la línea no cupo, o cupo justo, o es la última.fgetcpermite saber cuál es, y descartar el resto. - Un programa que procesa un archivo avisa, sigue si puede y abre la salida al final, cuando ya sabe que tiene algo que escribir.
Ejercicios
-
Diseñen un
structpara un libro de biblioteca, con título, autor, año y si está prestado. ¿Qué tipo tiene cada campo? Escriban su definición, e inicialicen una variable con un libro inventado. -
¿Qué escribe este programa? Primero respondan a mano, y después compruébenlo. Usen el
struct studentdel capítulo.struct student f(struct student s) { s.grades[0] = 1; return s; } void g(struct student s) { s.grades[1] = 2; } void h(int a[]) { a[2] = 3; } struct student x = {"Ana", {10, 10, 10}}; f(x); g(x); h(x.grades); printf("%d %d %d\n", x.grades[0], x.grades[1], x.grades[2]);Al compilarlo,
gccavisa quegno usa su parámetro después de cambiarlo. ¿Qué les dice eso? -
Escriban
count_passed(const struct student list[], int n), que devuelva cuántos estudiantes tienen promedio 11 o más. Pruébenla conassert, con la lista destruct_array.c: da 2. Connigual a 0, da 0. -
Escriban
same_student(struct student a, struct student b), que devuelva 1 si los nombres y las tres notas son iguales, y 0 si no. Usenstrcmppara los nombres. Prueben dos casos: que la diferencia esté solo en una nota, y que esté solo en el nombre. -
Agreguen un campo
charmás al final destruct sorted. Antes de correrlo, ¿cuánto creen que darásizeof? Comprueben. ¿Cuánto midestruct mixed list[10]en su máquina? -
Usen
show_filepara mostrarestudiantes_malos.txt. ¿Cuántas líneas dice que tiene? Comprueben conwc -l. ¿Qué número le da a la línea vacía? -
Con el programa
errors/feof_loop.c, creen un archivo cuya última línea no tenga salto, conprintf 'uno\ndos' > build/sin_salto.txt, y cambien el nombre del archivo en una copia del programa. ¿Se repite la última línea? Expliquen por qué, usando lo que hacefgetsen esa última lectura. -
Sin correrlo, ¿cuánto devuelve
sscanf(line, "%19s %d %d %d %1s", name, &a, &b, &c, extra)para cada línea?"Luis 10 11","Luis 10 x 11","10 11 12 13","Luis 10 11 12 13 14". Comprueben sus respuestas agregando las líneas a una copia deparse_fields.c. Cuidado con el tamaño deN_LINES. -
Escriban un programa
count_bytes.cque pida el nombre de un archivo y cuente sus líneas y su número total de bytes, leyendo confgetchastaEOF. Comparen conwc -lywc -cparaestudiantes.txt. Prueben también con un archivo que no existe. -
Corran el programa del laboratorio dando el mismo nombre para la entrada y la salida, sobre una copia de
estudiantes.txt. ¿Qué queda en el archivo? ¿Se perdió información? Agreguen amainuna revisión constrcmpque evite el problema, con un mensaje claro. -
Escriban
sort_by_average: ordene una lista destruct studentde mayor a menor promedio. Pueden seguir esta idea, que la próxima semana estudiaremos: busquen el mejor desde la posiciónihasta el final, e intercámbienlo con el de la posicióni. ¿Cuántas líneas se necesitan para intercambiar dosstruct? ¿Y cuántas harían falta con arreglos paralelos?