Apuntes · Capítulo 11Memoria y datos
Biblioteca de cadenas y matrices
Biblioteca de cadenas y matrices
La semana pasada recorrimos cadenas a mano: my_strlen, my_strcmp, copy_text. Hoy
vemos que C ya trae esas funciones, y más, en la biblioteca de cadenas string.h. Como
ya saben qué hacen por dentro, nos concentramos en lo que importa al usarlas: qué devuelven,
qué pasa en los bordes y dónde están sus trampas. Varias existen por razones históricas y
tienen un comportamiento que sorprende.
La segunda parte amplía los arreglos a dos dimensiones: las matrices (matrix). Una tabla de notas, con un estudiante en cada fila y un curso en cada columna, es una matriz. Veremos que en memoria es una sola fila larga de bytes, y eso explica por qué una función que recibe una matriz necesita saber cuántas columnas tiene.
Lectura. El código de este capítulo está en
code/week-11. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “La biblioteca
string.h” y “Comparar cadenas”. Es lo mínimo para seguir la clase.- En clase: “Copiar y agregar”, “Buscar:
strchrystrstr”, “Matrices” y “Sumar y transponer matrices”.- Después de clase: para el laboratorio, “El laboratorio, paso a paso” y “La Práctica 3”; para repasar, “Resumen” y “Ejercicios”.
La biblioteca string.h
Para usar estas funciones se agrega una línea al inicio del programa:
#include <string.h>Es la misma idea de stdio.h, que trae printf, o de math.h. Estas son las funciones de
hoy. El texto que leen debe ser una cadena, es decir, un arreglo de char que termina en '\0'.
| Función | Qué hace | Lo que hay que cuidar |
|---|---|---|
strlen(s) |
cuenta los bytes antes del '\0' |
devuelve un valor sin signo |
strcmp(a, b) |
compara dos cadenas | solo importa el signo |
strncpy(d, s, n) |
copia como máximo n bytes |
puede no dejar '\0' |
strcat(d, s) |
agrega s al final de d |
no recibe el tamaño de d |
strchr(s, c) |
busca un byte | puede devolver NULL |
strstr(s, t) |
busca una cadena dentro de otra | puede devolver NULL |
strlen y el tipo size_t
strlen hace lo mismo que my_strlen: avanza hasta el '\0' y dice cuántos bytes pasó. El
programa lengths.c la prueba:
char t[8] = "hola";

printf("strlen(t) = %zu\n", strlen(t));
printf("sizeof(t) = %zu\n", sizeof(t));
$ build/lengths
strlen(t) = 4
sizeof(t) = 8
strlen("") = 0
strlen("año") = 4
alohLas cuatro primeras líneas no traen sorpresas. La longitud de la cadena y el tamaño del
arreglo siguen siendo dos cosas distintas, y la longitud sigue contando bytes, no letras: la
ñ ocupa 2.
Lo nuevo es el tipo de lo que devuelve. strlen no devuelve un int, sino un size_t. Es
el mismo tipo que da sizeof, y por eso se escribe con %zu. size_t es un entero sin
signo: nunca es negativo, porque un tamaño no puede serlo. En este entorno ocupa 8 bytes,
pero cuánto ocupa depende de la plataforma.
Ese “sin signo” tiene consecuencias. En la semana 3 vimos que los enteros sin signo dan la
vuelta, y que eso está definido. ¿Qué pasa al restar 1 a un size_t que vale 0? El programa
errors/strlen_wrap.c lo prueba con una cadena vacía:
$ gcc -Wall -Wextra -std=c17 errors/strlen_wrap.c -o build/strlen_wrap
errors/strlen_wrap.c: In function ‘main’:
errors/strlen_wrap.c:9:27: warning: comparison of unsigned expression in ‘>= 0’ is always true [-Wtype-limits]
    9 |     if (strlen(empty) - 1 >= 0) {
      |                           ^~
$ build/strlen_wrap
strlen(empty) - 1 = 18446744073709551615
Esta condición siempre se cumple
No da -1. Da el número más grande que cabe en un size_t, que aquí es 2⁶⁴ - 1, porque en este
entorno tiene 64 bits. gcc avisó de la condición: un valor sin signo siempre es >= 0.
Esto no es un detalle. La forma natural de pedir el último carácter es
s[strlen(s) - 1], y funciona con todas las cadenas menos con una:
char last_char(const char s[]) {
    return s[strlen(s) - 1];
}
Con "sol" da l. Con "" lee fuera del arreglo, y eso es comportamiento indefinido. Aquí
gcc no avisa nada, y el sanitizer lo encuentra solo si la ejecución pasa por ese caso. Este informe está
recortado, y sus direcciones cambian en cada corrida:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/last_char.c -o build/last_char_san
$ build/last_char_san
==93592==ERROR: AddressSanitizer: stack-buffer-underflow on address 0xffff8bc0002f at pc 0xaaaacd63110c bp 0xffffe893a270 sp 0xffffe893a288
READ of size 1 at 0xffff8bc0002f thread T0
    #0 0xaaaacd631108 in last_char errors/last_char.c:6
    #1 0xaaaacd63128c in main errors/last_char.c:14
underflow significa que leyó antes del inicio del arreglo. Falta la l de la primera llamada porque esta
salida se capturó con un programa y no se escribió en una terminal, como explicamos la semana pasada. La corrección es preguntar
antes de restar:
algoritmo ultimo(s)
    n ← longitud(s)
    si n = 0 entonces
        devolver NULO
    fin si
    devolver s[n - 1]
fin algoritmo
Escribir esta versión en C queda para el ejercicio 2.
Error común. Escribir
strlen(s) - 1sin pensar en la cadena vacía. Tambiénstrlen(a) - strlen(b) < 0, que nunca es verdadero: la resta da la vuelta en vez de dar un negativo. Para saber cuál es más larga, se compara:strlen(a) < strlen(b).
Recorrer usando strlen
Si escriben i < strlen(s) con una i de tipo int, gcc avisa, porque compara un valor con
signo con uno sin signo:
$ gcc -Wall -Wextra -std=c17 errors/sign_compare.c -o build/sign_compare
errors/sign_compare.c: In function ‘main’:
errors/sign_compare.c:8:23: warning: comparison of integer expressions of different signedness: ‘int’ and ‘size_t’ {aka ‘long unsigned int’} [-Wsign-compare]
    8 |     for (int i = 0; i < strlen(s); i++) {
      |                       ^
Hay dos razones para no escribir ese ciclo. Una es la advertencia. La otra es que strlen
recorre toda la cadena cada vez que se llama, como vimos la semana pasada, y aquí se llamaría
en cada vuelta. La solución es llamarla una vez y guardar el resultado en un int, con un
cast:
int n = (int) strlen(t);
for (int i = n - 1; i >= 0; i--) {
Ese ciclo es lo que escribió aloh en lengths.c. Con n de tipo int, el caso de la cadena
vacía también queda bien: n - 1 vale -1, y el ciclo no corre. Con un size_t, i >= 0 sería
siempre verdadero, y el ciclo seguiría fuera del arreglo. El cast es seguro en este curso, porque
nuestras cadenas son mucho más cortas que el mayor int.
Muchas veces no hace falta strlen. Para recorrer una cadena de izquierda a derecha, el ciclo
de la semana pasada sigue siendo el mejor: for (int i = 0; s[i] != '\0'; i++).
Comparar cadenas
Por qué == no compara cadenas
En la semana 9 vimos que == con dos arreglos no compara sus contenidos, y una cadena es un
arreglo. El programa errors/equal_arrays.c tiene dos arreglos con el mismo texto:
$ gcc -Wall -Wextra -std=c17 errors/equal_arrays.c -o build/equal_arrays
errors/equal_arrays.c: In function ‘main’:
errors/equal_arrays.c:8:11: warning: comparison between two arrays [-Warray-compare]
    8 |     if (a == b) {
      |           ^~
errors/equal_arrays.c:8:11: note: use ‘&a[0] == &b[0]’ to compare the addresses
$ build/equal_arrays
distintas
La nota de gcc dice qué se compara: las direcciones. a y b son dos arreglos separados,
así que están en lugares distintos, por más que guarden lo mismo. Es como comparar las
direcciones de dos casas para saber si tienen los mismos muebles.
El caso peligroso es dentro de una función. Ahí los parámetros ya son direcciones, y gcc no
tiene nada que decir sobre dos arreglos:
int same_text(const char a[], const char b[]) {
    return a == b;
}
$ gcc -Wall -Wextra -std=c17 errors/equal_params.c -o build/equal_params
$ build/equal_params
a con b: 0
a con a: 1Compila sin ninguna advertencia, y su respuesta no tiene nada que ver con el texto. Solo dice si las dos direcciones son la misma.
Con literales de cadena es todavía menos confiable. C no dice si dos literales con el mismo texto
se guardan en un solo lugar o en dos. Por eso la comparación puede dar 1 o 0, según el
compilador y sus opciones. Lo que sigue es solo lo que salió en esta corrida, en este entorno, y no
prueba nada. El mensaje de gcc lo dice: unspecified behavior, un resultado que el
lenguaje no fija.
$ gcc -Wall -Wextra -std=c17 errors/equal_literals.c -o build/equal_literals
errors/equal_literals.c: In function ‘main’:
errors/equal_literals.c:5:27: warning: comparison with string literal results in unspecified behavior [-Waddress]
    5 |     printf("%d\n", "hola" == "hola");
      |                           ^~
$ build/equal_literals
1
Idea clave.
==entre cadenas compara direcciones. Que alguna vez dé “iguales” no significa que esté bien: puede ser que las dos cadenas estén en el mismo lugar. Para comparar textos se usastrcmp.
strcmp
strcmp(a, b) compara byte por byte, como el my_strcmp del laboratorio pasado, hasta la
primera diferencia o hasta el final. Lo que devuelve se lee por su signo:
strcmp(a, b) |
Significa |
|---|---|
| negativo | a va antes que b |
| 0 | son iguales |
| positivo | a va después de b |
Solo el signo está garantizado. El lenguaje no dice cuánto vale: no cuenten con -1 ni con 1.
Por eso if (strcmp(a, b) == -1) es un error, aunque alguna vez funcione. Se escribe < 0, == 0 o
> 0. El programa compare.c lo hace así:
void show_order(const char a[], const char b[]) {
    int result = strcmp(a, b);
    if (result < 0) {
$ build/compare
"ana" y "ana" son iguales
"ana" va antes que "ano"
"an" va antes que "ana"
"sol" va después de "luna"
"Z" va antes que "a"
"z" va antes que "ñ"Fíjense en tres cosas. "an" va antes que "ana": en el índice 2, compara '\0' con a, y el
'\0' vale 0. "Z" va antes que "a", porque las mayúsculas tienen códigos ASCII menores. Y
"z" va antes que "ñ", porque strcmp compara los bytes como unsigned char, así que el
resultado no depende de si char tiene signo en la máquina: 7a es menor que c3. Es lo mismo
que le pedimos a my_strcmp.
Entonces, el orden de strcmp es por códigos, no el de un diccionario. Si quieren que "ana" y
"Ana" queden juntos, o que "ñ" vaya entre "n" y "o", hace falta más trabajo.
Error común. Escribir
if (strcmp(a, b))para preguntar si son iguales. Cuando son iguales,strcmpdevuelve 0, y en unifel 0 es falso. Es exactamente lo contrario de lo que se lee:$ gcc -Wall -Wextra -std=c17 errors/strcmp_wrong.c -o build/strcmp_wrong $ build/strcmp_wrong distintasLos dos arreglos tienen
"hola". Escriban siempre la comparación completa:if (strcmp(a, b) == 0).
Ese signo es todo lo que hace falta para ordenar. Un algoritmo de ordenamiento solo pregunta,
de dos elementos, cuál va primero. Si strcmp(a, b) > 0, entonces a va después de b, y hay
que cambiarlos de lugar. Más abajo buscaremos el primero de una lista de nombres, y en la semana
13 veremos cómo ordenar.
Copiar y agregar
Un arreglo no se asigna con =, como vimos en la semana 9. Para copiar una cadena hay que
copiar sus bytes. string.h trae dos funciones para eso.
strcpy: sin límite
strcpy(dest, src) copia src y su '\0' en dest. Es cómoda, pero no recibe el tamaño de
dest. Es el mismo problema de %s sin límite: si el origen no cabe, escribe fuera del arreglo.
Solo se puede usar cuando es seguro que cabe. En este curso, cuando el origen puede venir de
afuera, no se usa.
strncpy: un límite con trampa
strncpy(dest, src, n) recibe un límite. Parece la versión segura de strcpy, pero no fue
diseñada para eso, y no se comporta como copy_text. Hace exactamente esto:
- Si
srctiene menos denletras, copia sus bytes y rellena con'\0'hasta completarnbytes. - Si
srctienenletras o más, sin contar su'\0', copia solonbytes y no pone ningún'\0'.
El programa strncpy_bytes.c llama a strncpy(dest, src, 5) con un destino de 5 bytes, y escribe
los bytes como números. No los escribe con %s, porque el destino puede no ser una cadena:
$ build/strncpy_bytes
 115 111 108 0 0
 108 117 110 97 0
 101 115 116 114 101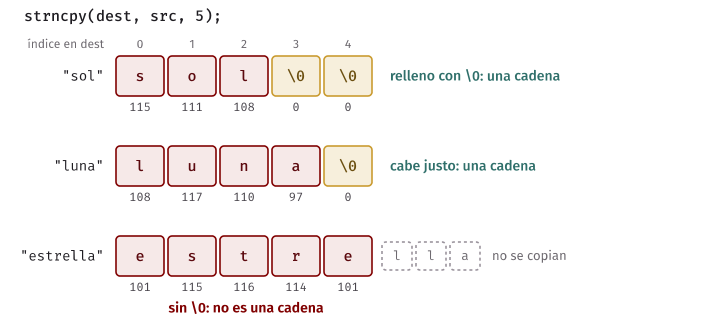
Si el texto está a la vista, gcc puede avisar:
$ gcc -Wall -Wextra -std=c17 errors/strncpy_warn.c -o build/strncpy_warn
errors/strncpy_warn.c: In function ‘main’:
errors/strncpy_warn.c:8:5: warning: ‘strncpy’ output truncated copying 5 bytes from a string of length 8 [-Wstringop-truncation]
    8 |     strncpy(word, "estrella", 5);
      |     ^~~~~~~~~~~~~~~~~~~~~~~~~~~~
Pero lo normal es que el origen llegue por un parámetro, y entonces con nuestras opciones no hay
ninguna advertencia. En errors/strncpy_no_null.c, una función hace la copia y main escribe el
resultado con %s. Recortado, y con direcciones que cambian en cada corrida:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/strncpy_no_null.c -o build/strncpy_no_null_san
$ build/strncpy_no_null_san
==93595==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff8ef00025 at pc 0xffff91d0a4dc bp 0xffffc41020b0 sp 0xffffc41020f0
READ of size 6 at 0xffff8ef00025 thread T0
    #0 0xffff91d0a4d8 in puts ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors.inc:1236
    #1 0xaaaad9ee0e28 in main errors/strncpy_no_null.c:15
Es el mismo tipo de informe que vimos con char word[4] = "hola" la semana pasada: READ, porque printf
sigue leyendo en busca de un '\0'.
La forma correcta tiene dos pasos, y el segundo no es opcional: copiar uno menos que el tamaño, y
poner el '\0' a mano.
void safe_copy(char dest[], const char src[], int size) {
    strncpy(dest, src, size - 1);
    dest[size - 1] = '\0';
}
$ build/safe_copy
sol
luna
estrEs la misma salida de copy_text de la semana pasada, así que la podemos ver como otra forma de
escribir copiar_texto. Por dentro hay una diferencia: strncpy rellena con '\0' lo que sobra. Como en esa función, el tamaño llega en un parámetro: dentro de una función, sizeof
no lo puede dar. Y como strncpy cuenta bytes, también puede cortar una ñ por la mitad.
Idea clave. Después de cualquier
strncpy, pregúntense: ¿quién puso el'\0'? Si no hay una respuesta clara, el destino puede no ser una cadena.
strcat: agregar al final
strcat(dest, src) busca el '\0' de dest, y copia src desde ahí, con su '\0'. Tampoco recibe
el tamaño de dest. errors/strcat_overflow.c tiene un full de 8 bytes con "Ana ", y le agrega
una palabra leída. Compila sin advertencias, y con una palabra corta funciona. Es el buffer overflow de la
semana pasada otra vez. Recortado, y con direcciones que cambian:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/strcat_overflow.c -o build/strcat_overflow_san
$ echo Li | build/strcat_overflow_san
Ana Li
$ echo Quispe_Huaman | build/strcat_overflow_san
==93609==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffffa1a00028 at pc 0xffffa46a37a8 bp 0xffffc1f791a0 sp 0xffffc1f79200
WRITE of size 14 at 0xffffa1a00028 thread T0
    #0 0xffffa46a37a4 in strcat ../../../../src/libsanitizer/asan/asan_interceptors.cpp:515
    #1 0xaaaae88a0f68 in main errors/strcat_overflow.c:13
La versión con límite es strncat(dest, src, n). Agrega como máximo n bytes de src, y sí
pone siempre el '\0', a diferencia de strncpy. Por eso a n se le da el espacio libre sin contar ese byte:
void safe_append(char dest[], const char src[], int size) {
    int used = (int) strlen(dest);
    strncat(dest, src, size - used - 1);
}
Fíjense: n no es el tamaño de dest, como uno esperaría. Sale de una cuenta. Con dest de 8 bytes
que ya tiene "Ana", used es 3, y 8 - 3 - 1 da 4: caben " Qui". Requiere que dest ya sea una
cadena dentro de esos size bytes.
$ build/append
Ana Quispe
Ana Qui
Regiones que se pisan
strcpy, strncpy, strcat y strncat tienen una regla más: el origen y el destino no pueden
pisarse. Si comparten bytes, el comportamiento es indefinido. Por ejemplo, strcat(s, s): mientras
escribe al final de s, está cambiando el texto que debe leer. gcc avisa aquí porque ve que los dos
argumentos son el mismo. La palabra restrict del mensaje es la forma de declarar esta regla, y el
sanitizer tiene un informe propio para ella.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/strcat_overlap.c -o build/strcat_overlap_san
errors/strcat_overlap.c: In function ‘main’:
errors/strcat_overlap.c:8:12: warning: passing argument 1 to ‘restrict’-qualified parameter aliases with argument 2 [-Wrestrict]
    8 |     strcat(s, s);
      |            ^  ~
$ build/strcat_overlap_san
==93598==ERROR: AddressSanitizer: strcat-param-overlap: memory ranges [0xffff9e400020,0xffff9e400029) and [0xffff9e400020, 0xffff9e400025) overlap
    #0 0xffffa11436ac in strcat ../../../../src/libsanitizer/asan/asan_interceptors.cpp:520
    #1 0xaaaae8ab0e48 in main errors/strcat_overlap.c:8
Sin el sanitizer, este programa escribió holahola en esta corrida. Eso no lo hace correcto: otra
biblioteca u otra máquina pueden hacer otra cosa.
Buscar: strchr y strstr
strchr(s, c) busca el byte c en la cadena s. strstr(s, t) busca la cadena t dentro de la
cadena s. Las dos responden lo mismo: la dirección donde lo encontraron, o NULL si no está.
Una dirección como resultado es algo nuevo. En este curso no declaramos variables para guardar direcciones, y no hace falta. Ya conocemos lo necesario para usar estas funciones de tres formas.
Una: preguntar si aparece. Basta comparar con NULL, el valor de “ninguna dirección” de la
semana pasada:
if (strchr(email, '#') == NULL) {Dos: usar el resultado como cadena. Una cadena se conoce por la dirección de su inicio. Si
le damos a printf una dirección dentro de un arreglo, escribe desde ahí hasta el '\0':
if (strstr(text, "Lima") != NULL) {
    printf("Desde Lima: %s\n", strstr(text, "Lima"));
}
Se llama dos veces, porque no guardamos el resultado. Primero se pregunta si está, y solo entonces se usa. Cuando vean punteros en cursos posteriores, lo guardarán en una variable.
Tres: empezar desde otro lugar. En la semana 9 usamos &values[i] para darle a scanf la
dirección del elemento i. Con una cadena, &text[3] es la dirección del byte 3, y lo que empieza ahí,
hasta el '\0', también es una cadena. Se la podemos pasar a cualquier función. Así, strstr(&text[1], "el") busca desde el byte 1.
El programa find_text.c prueba todo esto con "ana@example.com" y con
"el año pasado llovió en Lima":
$ build/find_text
Tiene @: @example.com
No tiene #
Desde Lima: Lima
lima, en minúsculas, no aparece
Desde la ñ: ño pasado llovió en Lima
Desde el byte 3: año pasado llovió en Lima
Desde el byte 0 hay un el
Desde el byte 1 no hay ninguno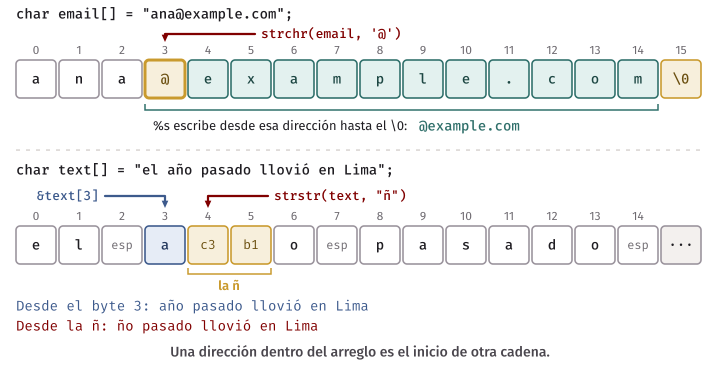
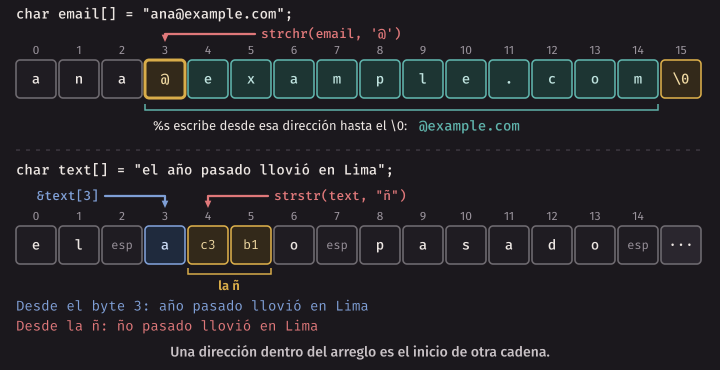
Hay dos detalles. La búsqueda distingue mayúsculas, porque compara bytes. Y la ñ se busca con
strstr(text, "ñ"), con comillas dobles: son 2 bytes, así que es una cadena. Con strchr no se
puede, porque esa función busca un solo byte, y 'ñ' no es un carácter de un byte, como vimos en la
semana 3.
Si la cadena buscada es vacía, strstr devuelve su primer argumento: una cadena vacía aparece
en todas partes. Lo veremos en el laboratorio.
Error común. Usar el resultado sin revisar si es
NULL.errors/strstr_null.cbusca"luna", que está, y"mar", que no, y le da los dos resultados aprintf:$ gcc -Wall -Wextra -std=c17 errors/strstr_null.c -o build/strstr_null $ build/strstr_null; echo "estado: $?" bash: line 1: 37413 Segmentation fault build/strstr_null estado: 139Es comportamiento indefinido, y esto es lo que salió en esta corrida. Con la salida capturada falta
lunapor la misma razón de la semana pasada: el texto todavía no se había escrito cuando el programa murió. Revisen siempre el resultado antes de usarlo.
Comparar direcciones, a propósito
Hay un caso donde == entre direcciones es justo lo que se quiere. Si dos direcciones apuntan
dentro del mismo arreglo, son iguales solo si son el mismo byte. Así se
pregunta si una palabra empieza exactamente en la posición i: strstr(&text[i], word) == &text[i].
Si la primera aparición desde i está en i, la palabra empieza ahí. Lo usaremos en el laboratorio.
Fíjense en la diferencia con el error de arriba: aquí la pregunta sí es sobre lugares, no sobre textos.
Matrices
Un arreglo guarda una lista. Muchos datos tienen forma de tabla: las notas de cada estudiante en cada curso, un tablero, los píxeles de una imagen. Para eso está la matriz (matrix), un arreglo de dos dimensiones.
int grades[STUDENTS][COURSES] = {
    {14, 9, 17, 12},
    {11, 16, 8, 13},
    {18, 10, 15, 20},
};
La declaración dice primero cuántas filas tiene y luego cuántas columnas. Aquí STUDENTS es 3 y
COURSES es 4, definidos con #define, igual que el tamaño de un arreglo en la semana 9. Cada fila va
entre llaves. Un elemento se pide con dos índices, cada uno en sus corchetes, y los dos empiezan en 0:
| Curso 0 | Curso 1 | Curso 2 | Curso 3 | |
|---|---|---|---|---|
| Estudiante 0 | 14 | 9 | 17 | 12 |
| Estudiante 1 | 11 | 16 | 8 | 13 |
| Estudiante 2 | 18 | 10 | 15 | 20 |
grades[1][2] es la fila 1, columna 2: el estudiante 1 en el curso 2, que vale 8. Como con los
arreglos, si faltan valores en la inicialización, las casillas restantes quedan en 0.
Error común. Escribir
m[1, 2], como en otros lenguajes. En C no significa fila 1, columna 2. La coma es un operador que evalúa los dos lados y se queda con el de la derecha, así que esm[2], la fila 2 entera.gccavisa con dos mensajes:$ gcc -Wall -Wextra -std=c17 errors/matrix_comma.c -o build/matrix_comma errors/matrix_comma.c: In function ‘main’: errors/matrix_comma.c:7:23: warning: left-hand operand of comma expression has no effect [-Wunused-value] 7 | printf("%d\n", m[1, 2]); | ^ errors/matrix_comma.c:7:14: warning: format ‘%d’ expects argument of type ‘int’, but argument 2 has type ‘int *’ [-Wformat=] 7 | printf("%d\n", m[1, 2]); | ~^ ~~~~~~~ | | | | int int * | %lsEl segundo mensaje lo confirma:
printfrecibeint *, una dirección, y no unint. La sugerencia%lsno viene al caso.
Cómo se guarda en memoria
La memoria es una fila de bytes numerados, como vimos en la semana 9. No hay tablas en ella. C guarda la matriz fila por fila: primero toda la fila 0, justo después toda la fila 1, y así, sin huecos. Esto lo garantiza el lenguaje. En inglés se llama row-major order.
Para int m[3][4], con valores del 1 al 12:
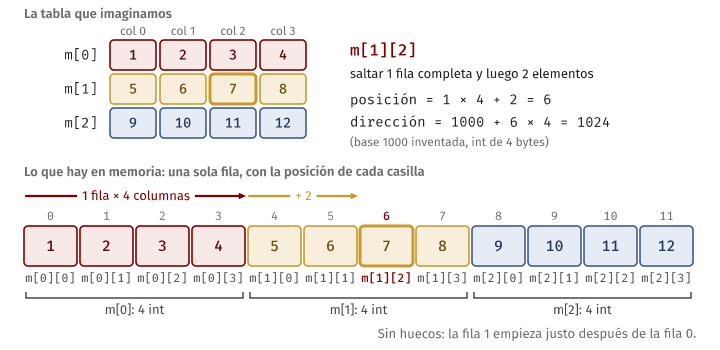
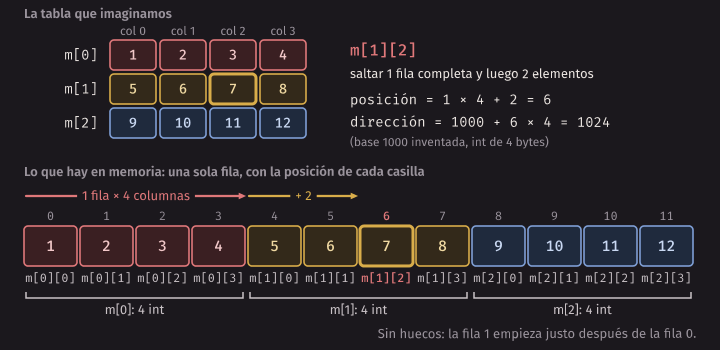
En realidad, una matriz es un arreglo de arreglos: m es un arreglo de 3 elementos, y cada elemento
m[i] es una fila, un arreglo de 4 int. Por eso lleva dos corchetes: m[1] es la fila 1, y m[1][2] es
el elemento 2 de esa fila. El programa matrix_layout.c lo muestra. Las direcciones de la salida cambian con cada
corrida y con cada máquina; aquí están solo las primeras casillas:
$ build/matrix_layout
sizeof(m) = 48
sizeof(m[0]) = 16
sizeof(m[0][0]) = 4
m[1][2] = 7
m[0][0] =  1 está en 0xffff90600030
m[0][1] =  2 está en 0xffff90600034
m[0][2] =  3 está en 0xffff90600038
m[0][3] =  4 está en 0xffff9060003c
m[1][0] =  5 está en 0xffff90600040
m[1][1] =  6 está en 0xffff90600044
En este entorno, un int ocupa 4 bytes, así que m ocupa 3 × 4 × 4 = 48, y cada fila, 16. Eso de que un
int ocupe 4 bytes es de este entorno; el lenguaje no lo fija. Las direcciones son lo que importa: suben de 4
en 4, también al pasar de m[0][3] a m[1][0]. Terminó una fila, y la siguiente está justo después. En hexadecimal,
3c más 4 da 40.
De ahí sale una fórmula. Para llegar a m[i][j], hay que saltar i filas completas, y después j elementos:
posición de m[i][j] = i × columnas + jSi m empieza en la dirección 1000 y cada int ocupa 4 bytes, ¿dónde está m[1][2]? La posición es
1 × 4 + 2 = 6, y cada posición ocupa 4 bytes: 1000 + 6 × 4 = 1024. En la figura, el 7 está justo en
la posición 6. Noten que la fórmula usa las columnas, pero no las filas. Eso va a importar pronto.
Error común. Salirse de una columna esperando caer en la fila siguiente.
m[0][3]en una matriz de 3 columnas parece serm[1][0], porque en memoria está ahí. Pero para C, es comportamiento indefinido: el índice 3 no existe en una fila de 3 elementos. No lo usen, aunque parezca funcionar. Aquí ocurre algo interesante con las herramientas. AddressSanitizer revisa si se sale del objeto completo, y este acceso sigue dentro de la matriz, así que no reporta nada. Quien lo ve es la parteundefineddel sanitizer, que revisa los índices cuando conoce el tamaño de la fila. El índice se lee de la entrada, y esto salió en esta corrida:$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/matrix_bounds.c -o build/matrix_bounds_san $ echo 2 | build/matrix_bounds_san m[0][2] = 3 $ echo 3 | build/matrix_bounds_san errors/matrix_bounds.c:12:38: runtime error: index 3 out of bounds for type 'int [3]' m[0][3] = 4Es un aviso y el programa siguió, así que el 4 no prueba nada.
Recorrer por filas y por columnas
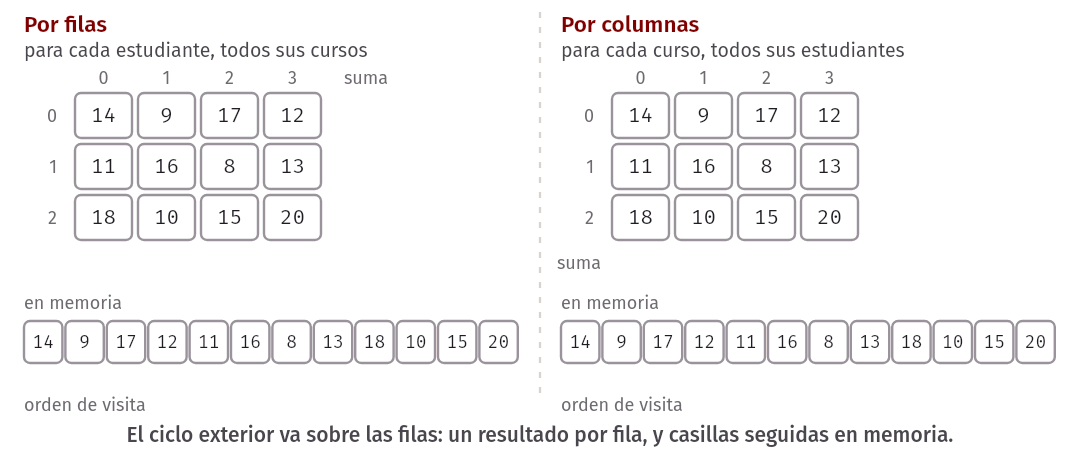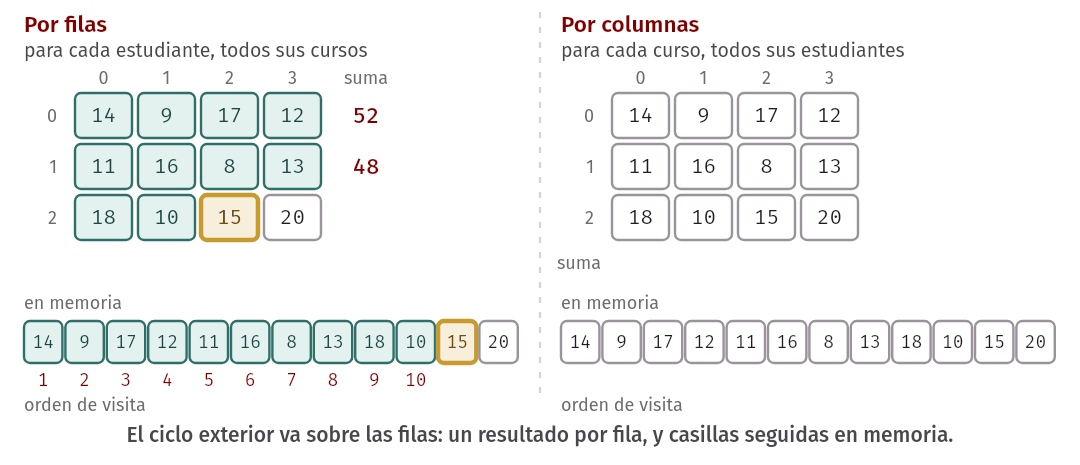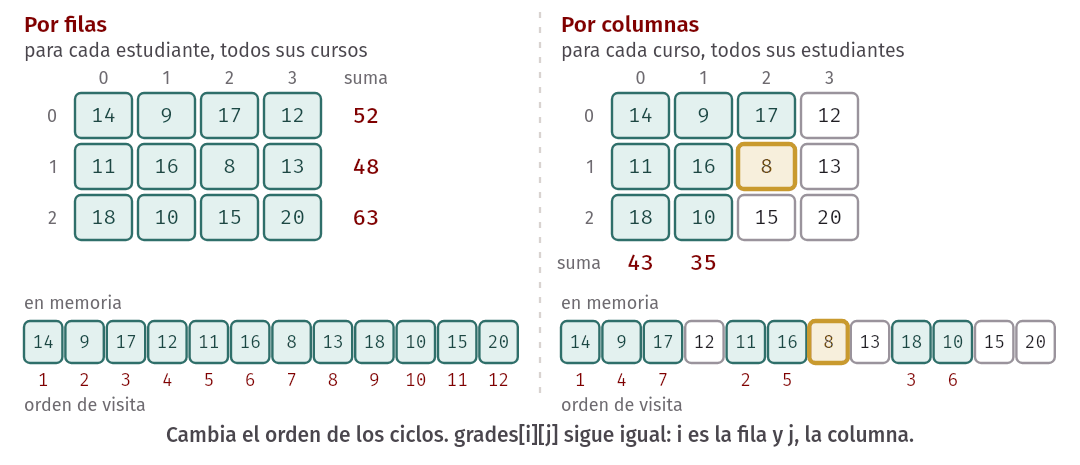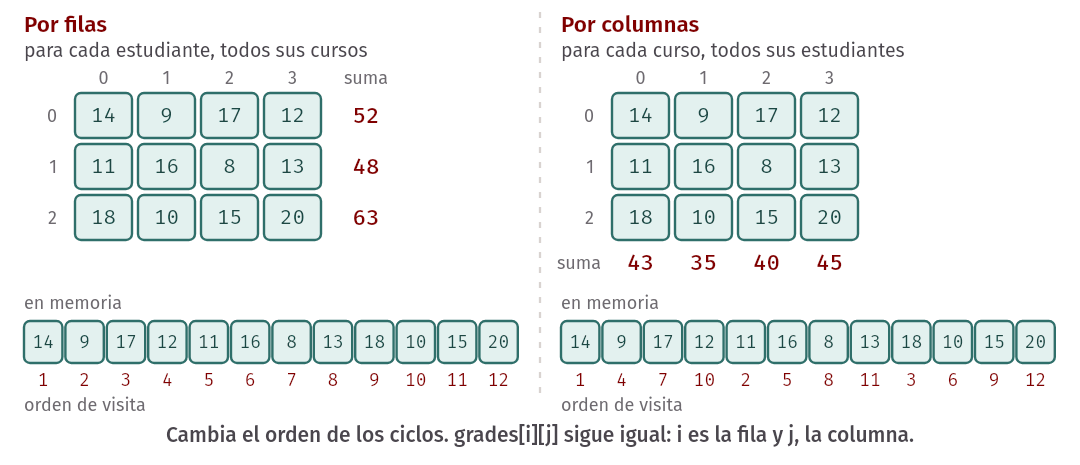
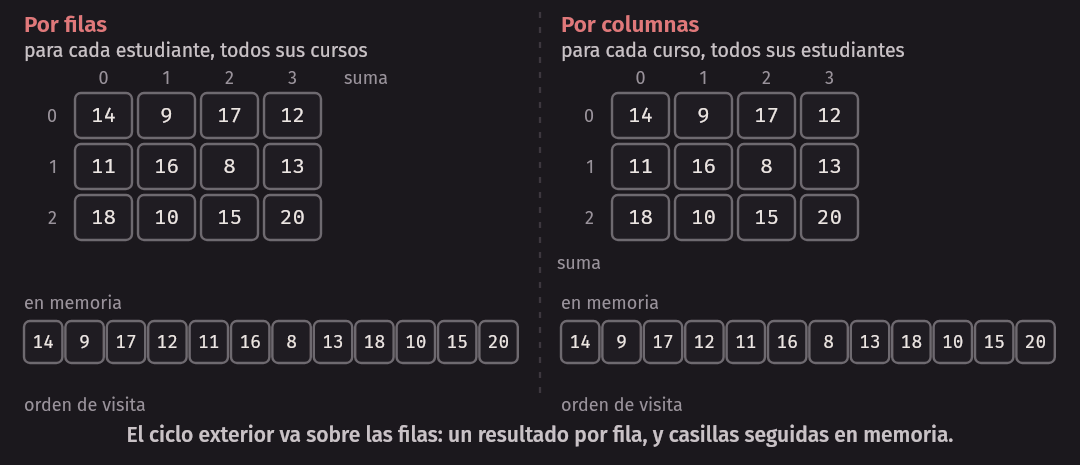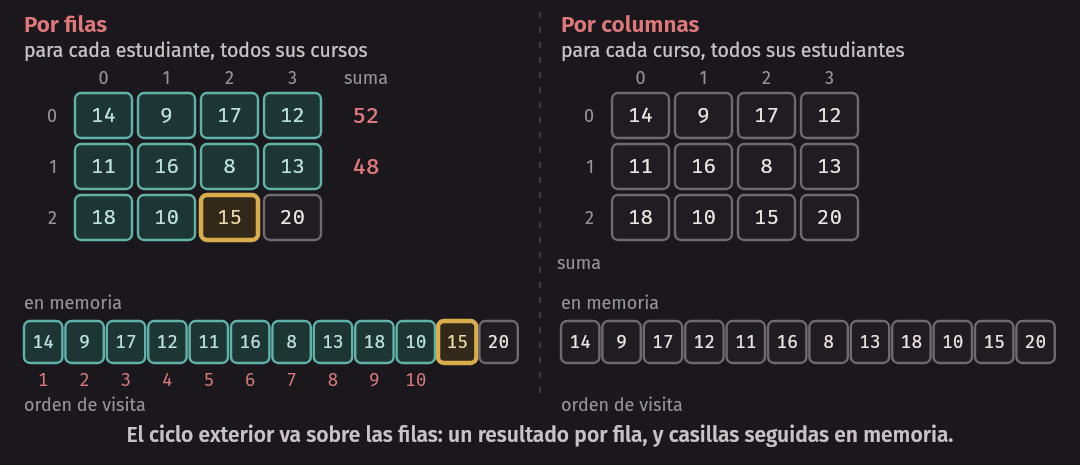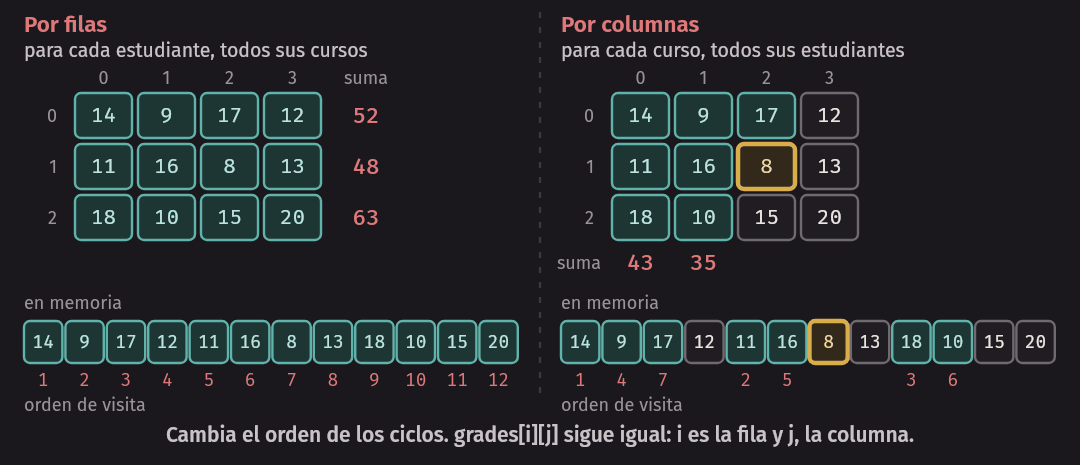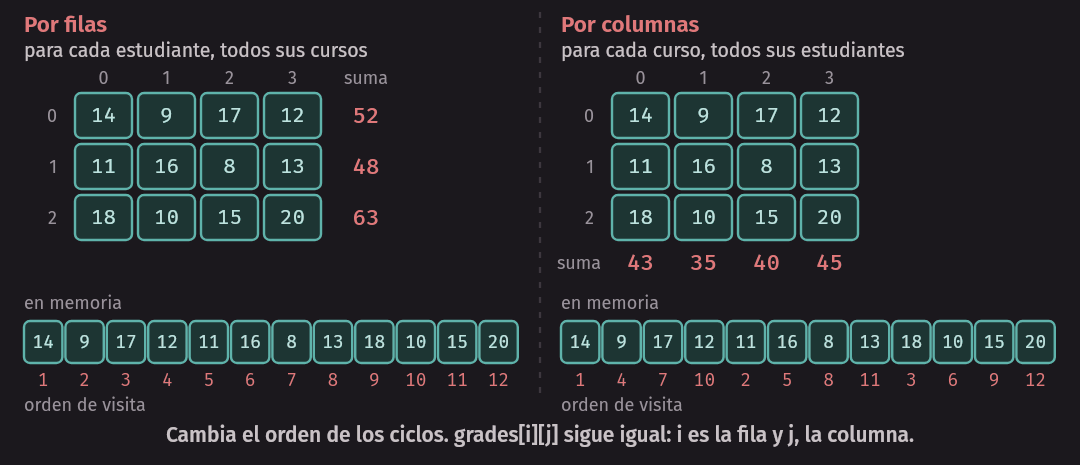
Para recorrer una matriz se usan dos ciclos anidados, los de la semana 6. El orden de los ciclos decide el recorrido. Por filas: para cada estudiante, todos sus cursos.
algoritmo promedios_por_estudiante(notas, estudiantes, cursos)
    para i desde 0 hasta estudiantes - 1 hacer
        total ← 0
        para j desde 0 hasta cursos - 1 hacer
            total ← total + notas[i][j]
        fin para
        escribir total, total / cursos
    fin para
fin algoritmo
Por columnas: para cada curso, todos sus estudiantes. Los ciclos cambian de lugar, pero notas[i][j]
sigue igual: i es siempre la fila, y j, la columna.
algoritmo promedios_por_curso(notas, estudiantes, cursos)
    para j desde 0 hasta cursos - 1 hacer
        total ← 0
        para i desde 0 hasta estudiantes - 1 hacer
            total ← total + notas[i][j]
        fin para
        escribir total, total / estudiantes
    fin para
fin algoritmo
En C, en grades_table.c, el recorrido por columnas es:
for (int j = 0; j < COURSES; j++) {
    int total = 0;
    for (int i = 0; i < STUDENTS; i++) {
        total = total + grades[i][j];
    }
    printf("Curso %d: suma %d, promedio %.2f\n", j, total, (double) total / STUDENTS);
}
Sigamos el curso 1, con j igual a 1. Recorre la segunda columna de la tabla, de arriba abajo:
i |
grades[i][1] |
total después de la vuelta |
|---|---|---|
| 0 | 9 | 9 |
| 1 | 16 | 25 |
| 2 | 10 | 35 |
Al salir, el promedio es 35 / 3. Con el cast no se pierde la parte decimal.
$ build/grades_table
Estudiante 0: suma 52, promedio 13.00
Estudiante 1: suma 48, promedio 12.00
Estudiante 2: suma 63, promedio 15.75
Curso 0: suma 43, promedio 14.33
Curso 1: suma 35, promedio 11.67
Curso 2: suma 40, promedio 13.33
Curso 3: suma 45, promedio 15.00
Error común. Poner
int total = 0;fuera del ciclo exterior. Entoncestotalno vuelve a 0, y cada fila suma también lo de las filas anteriores. Compila y corre sin ningún aviso. La primera fila sale bien; las demás, no. Cada vez que tengan un acumulador, pregúntense: ¿para qué grupo cuenta?
Idea clave. La primera línea de cada ciclo dice qué se recorre. Si el ciclo exterior va sobre las filas, el resultado es uno por fila. Si va sobre las columnas, uno por columna. Los índices dentro de
grades[i][j]no cambian de lugar: la fila va primero.
Pasar una matriz a una función
Una matriz se pasa como un arreglo: se escribe su nombre, y lo que viaja es la dirección donde empieza. Por eso, la función trabaja sobre la matriz original. La diferencia está en el parámetro:
int column_sum(int m[][COLS], int rows, int column) {El primer par de corchetes va vacío, como en un arreglo. El segundo debe llevar el número de columnas.
En este curso, ese número siempre es una constante. Las filas se pasan aparte, en rows, igual que la longitud de un arreglo.
¿Por qué esa asimetría? Volvamos a la fórmula: i × columnas + j. Para calcular dónde está m[i][j],
la función necesita las columnas. Sin ellas no sabe cuánto saltar por cada fila. Las filas no entran en la
cuenta. Si no se dan las columnas, el programa no compila. El mensaje real es más largo, y aquí está recortado:
$ gcc -Wall -Wextra -std=c17 errors/matrix_no_columns.c -o build/matrix_no_columns
errors/matrix_no_columns.c:4:15: error: array type has incomplete element type ‘int[]’
    4 | int first(int m[][]) {
      |               ^
errors/matrix_no_columns.c:4:15: note: declaration of ‘m’ as multidimensional array must have bounds for all dimensions except the first
La nota lo dice: se puede omitir solo la primera dimensión. Y el número que se escriba debe coincidir con la
matriz real. Si la función espera 3 columnas y la matriz tiene 4, las cuentas saldrían mal, así que este gcc da un
error. Otros compiladores o versiones más antiguas pueden dar solo una advertencia. No la ignoren.
$ gcc -Wall -Wextra -std=c17 errors/matrix_wrong_columns.c -o build/matrix_wrong_columns
errors/matrix_wrong_columns.c: In function ‘main’:
errors/matrix_wrong_columns.c:11:26: error: passing argument 1 of ‘first’ from incompatible pointer type [-Wincompatible-pointer-types]
   11 |     printf("%d\n", first(m));
      |                          ^
      |                          |
      |                          int (*)[4]
errors/matrix_wrong_columns.c:4:15: note: expected ‘int (*)[3]’ but argument is of type ‘int (*)[4]’
    4 | int first(int m[][3]) {
      |           ~~~~^~~~~~
int (*)[4] se lee “dirección de una fila de 4 int”. Es lo que viaja: la dirección de la primera fila,
y por eso el tipo incluye su tamaño. Como int *, solo hay que saber leerlo.
El programa matrix_param.c tiene tres funciones. column_sum suma una columna, y add_bonus
cambia la matriz original. En main, add_bonus(grades, 2, 1) suma 1 solo a las 2 primeras filas:
void add_bonus(int m[][COLS], int rows, int bonus) {
    for (int i = 0; i < rows; i++) {
        for (int j = 0; j < COLS; j++) {
            m[i][j] = m[i][j] + bonus;
        }
    }
}
$ build/matrix_param
14 9 17 12
11 16 8 13
18 10 15 20
Suma del curso 0: 43
Suma del curso 0, solo 2 filas: 25
15 10 18 13
12 17 9 14
18 10 15 20En C. La semana pasada dijimos que, si una función no cambia el arreglo, su parámetro lleva
const. Las matrices son una excepción. Escribirconst int m[][COLS]y pasar una matriz normal no está permitido en C17, aunque nuestras opciones no avisen. Lo muestra-Wpedantic, una opción que pide agccrevisar las reglas del estándar:$ gcc -Wall -Wextra -std=c17 -Wpedantic errors/const_matrix.c -o build/const_matrix errors/const_matrix.c: In function ‘main’: errors/const_matrix.c:13:26: warning: invalid use of pointers to arrays with different qualifiers in ISO C before C23 [-Wpedantic] 13 | printf("%d\n", first(m)); | ^
ISO C before C23dice que la versión C23 del lenguaje ya lo permite, pero el curso usa C17. Por eso, en este curso, los parámetros matriz van sinconst. La regla sigue igual para arreglos y cadenas.
Un arreglo de cadenas
Una matriz de char es la forma de guardar varias cadenas sin punteros. Cada fila es un arreglo de char, y
guarda una cadena:
char names[COUNT][NAME_SIZE] = {"Rosa", "Ana", "Luis", "Zoila"};Con COUNT igual a 4 y NAME_SIZE igual a 12, son 48 bytes: cada fila ocupa 12, aunque su texto sea más
corto. names[1] es una fila, un arreglo de char, así que se puede pasar a cualquier función que espere una
cadena: printf con %s, strlen, strcmp.
Aquí usamos strcmp para lo que prometimos: decidir el orden. Este algoritmo busca el nombre que va primero. Se
parece a max_value de la semana pasada, con strcmp en lugar de comparar números:
algoritmo primer_nombre(nombres, n)
    primero ← 0
    para i desde 1 hasta n - 1 hacer
        si comparar(nombres[i], nombres[primero]) < 0 entonces
            primero ← i
        fin si
    fin para
    devolver primero
fin algoritmo
int first_name(char names[][NAME_SIZE], int n) {
int first = 0;
for (int i = 1; i < n; i++) {
if (strcmp(names[i], names[first]) < 0) {
first = i;
}
}
return first;
}Para cambiar una fila no sirve =, porque es un arreglo. Se usa la copia segura, con el tamaño de la fila:
safe_copy(names[1], "Maria de los Angeles", NAME_SIZE);$ build/names
sizeof(names) = 48
names[0] = Rosa, 4 bytes de texto
names[1] = Ana, 3 bytes de texto
names[2] = Luis, 4 bytes de texto
names[3] = Zoila, 5 bytes de texto
Primero: Ana
names[1] = Maria de lo
Primero: LuisEl nombre largo se cortó a 11 bytes, y quedó lugar para el '\0'. Sin Ana, el primero pasó a ser Luis.
Sumar y transponer matrices
Estas dos operaciones aparecen mucho en matemáticas, y son buen ejercicio de índices.
Sumar dos matrices del mismo tamaño es sumar casilla por casilla. matrix_add.c guarda el resultado en
una tercera matriz:
algoritmo sumar_matrices(a, b, resultado, filas, columnas)
    para i desde 0 hasta filas - 1 hacer
        para j desde 0 hasta columnas - 1 hacer
            resultado[i][j] ← a[i][j] + b[i][j]
        fin para
    fin para
fin algoritmo
$ build/matrix_add
11 22 33
44 55 66Transponer es cambiar filas por columnas: la fila i pasa a ser la columna i. Una matriz de 2 filas y 3
columnas da una de 3 filas y 2 columnas, así que el resultado tiene otra forma, y va en otra matriz:
| Original | ||
|---|---|---|
| 1 | 2 | 3 |
| 4 | 5 | 6 |
| Transpuesta | |
|---|---|
| 1 | 4 |
| 2 | 5 |
| 3 | 6 |
algoritmo transponer(a, resultado, filas, columnas)
    para i desde 0 hasta filas - 1 hacer
        para j desde 0 hasta columnas - 1 hacer
            resultado[j][i] ← a[i][j]
        fin para
    fin para
fin algoritmo
La línea clave es resultado[j][i] ← a[i][j]: los índices se cruzan. Por ejemplo, el 6 está en a[1][2], y
pasa a resultado[2][1].
Error común. Transponer una matriz cuadrada en el mismo arreglo, recorriendo todas las casillas e intercambiando
m[i][j]conm[j][i]. Cada par se intercambia dos veces: una al pasar por(i, j)y otra al pasar por(j, i). La matriz queda igual que al inicio:$ gcc -Wall -Wextra -std=c17 errors/transpose_in_place.c -o build/transpose_in_place $ build/transpose_in_place 1 2 3 4 5 6 7 8 9Compila, corre y no dice nada. El ejercicio 10 les pide corregirlo.
El laboratorio, paso a paso
El laboratorio tiene dos archivos, que están en code/week-11/lab. Los comentarios
dicen qué debe hacer cada función. make test-lab los comprueba: falla hasta que terminen. Aquí están las ideas.
Contar una palabra con strstr
count_word(text, word) cuenta cuántas veces aparece word en text. Antes de programar hay que decidir qué
significa “aparecer”, como con los palíndromos de la semana pasada. El laboratorio fija estas reglas:
| Caso | Regla | Ejemplo |
|---|---|---|
| Mayúsculas | se compara byte por byte | sol aparece 1 vez en Sol sol |
| Dentro de otra palabra | sí cuenta | sol aparece 1 vez en girasol |
| Apariciones que se pisan | no: se sigue buscando después de cada una | ana aparece 1 vez en banana |
| Palabra vacía | devuelve 0 |
La última regla no es un capricho. strstr encuentra la cadena vacía en todas partes, así que sin esa revisión el
ciclo no avanzaría nunca, y el programa no terminaría.
La idea es avanzar un índice i por el texto. En cada paso, preguntamos si la palabra todavía aparece desde i. Si no
aparece, se acabó. Si aparece justo en i, contamos y saltamos la palabra. Si aparece más adelante, avanzamos uno:
algoritmo contar_palabra(texto, palabra)
    largo ← longitud(palabra)
    si largo = 0 entonces
        devolver 0
    fin si
    cuenta ← 0
    i ← 0
    mientras palabra aparece en texto desde i hacer
        si palabra aparece justo en la posición i entonces
            cuenta ← cuenta + 1
            i ← i + largo
        sino
            i ← i + 1
        fin si
    fin mientras
    devolver cuenta
fin algoritmo
Las dos preguntas salen de lo que vimos en este capítulo: strstr(&text[i], word) != NULL y
strstr(&text[i], word) == &text[i]. Sigámoslo con "ana" en "banana":
i |
Texto desde i |
¿Aparece? | ¿Justo en i? |
Qué hace | cuenta |
|---|---|---|---|---|---|
| 0 | banana |
sí | no | i pasa a 1 |
0 |
| 1 | anana |
sí | sí | i pasa a 4 |
1 |
| 4 | na |
no | termina | 1 |
Este método llama a strstr varias veces y repite trabajo. Para los textos de hoy no importa. En la semana 13 veremos
cómo razonar sobre eso.
Promedios y el mejor de cada curso
Las notas están en grades.c, con STUDENTS igual a 4 y COURSES igual a 3. Las funciones reciben students, cuántas filas
están en uso, y dejan sus resultados en un arreglo, porque un arreglo sí se puede cambiar desde la función.
student_averages y course_averages son los dos algoritmos de arriba, guardando el promedio en lugar de escribirlo. Cuidado
con dos errores que las pruebas detectan: que total no vuelva a 0, y dividir entre int sin cast.
best_students guarda en best[j] el índice del mejor estudiante del curso j. Es un recorrido por columnas, que busca el
máximo de cada una:
algoritmo mejores(notas, estudiantes, cursos, mejor)
    para j desde 0 hasta cursos - 1 hacer
        mejor[j] ← 0
        para i desde 1 hasta estudiantes - 1 hacer
            si notas[i][j] > notas[mejor[j]][j] entonces
                mejor[j] ← i
            fin si
        fin para
    fin para
fin algoritmo
Empezar con el primer estudiante como mejor resuelve el caso de un curso donde todos tienen 0. Usar > y no ≥ resuelve los
empates: gana el primero, el de índice menor. Las pruebas incluyen los dos casos.
Transponer y comprobarlo con assert
transpose recibe grades, de 4 filas y 3 columnas, y deja el resultado en una matriz de 3 filas y 4 columnas. Por eso, su
segundo parámetro es int result[][STUDENTS]. Es el algoritmo de arriba.
Para comprobarlo, escriban is_transpose, que revisa todas las casillas, y úsenla con assert, como en la semana 7:
algoritmo es_transpuesta(a, b, filas, columnas)
    para i desde 0 hasta filas - 1 hacer
        para j desde 0 hasta columnas - 1 hacer
            si b[j][i] ≠ a[i][j] entonces
                devolver 0
            fin si
        fin para
    fin para
    devolver 1
fin algoritmo
Una prueba que no puede fallar no sirve de nada. Por eso, el main que les damos también hace lo contrario: cambia una
casilla y exige que is_transpose responda 0. Y make test-lab le da una matriz equivocada en varias casillas.
Los promedios son double, y dos double no se comparan con ==, como vimos en la semana 3. Por eso, grades.c trae
close_to, que revisa si la diferencia es pequeña.
La Práctica 3
Esta semana, la sesión de laboratorio es para la Práctica 3. Los dos archivos del laboratorio de arriba son trabajo
autónomo y conviene hacerlos antes. La práctica cubre arreglos, cadenas y matrices. El formato y las reglas están en
practicas/README.md.
Resumen
string.htrae las funciones de cadenas. El texto que leen debe terminar en'\0'.strlencuenta bytes y devuelvesize_t, un entero sin signo.strlen(s) - 1con una cadena vacía da la vuelta a un número enorme. Para recorrer con unint, guarden(int) strlen(s)una sola vez.==entre cadenas compara direcciones. Para comparar textos se usastrcmp, y de su resultado solo importa el signo:== 0para iguales,< 0para antes,> 0para después. El orden es por códigos, no el de un diccionario.strcpyystrcatno reciben el tamaño del destino.strncpypuede dejar el destino sin'\0': copiensize - 1bytes y pongan el'\0'a mano.strncatsí pone el'\0', y su número es el espacio libre, no el tamaño total.- En estas funciones de copia y de agregar, el origen y el destino no pueden pisarse.
strchrystrstrdevuelven una dirección oNULL. Revisen elNULLantes de usar el resultado.&s[i]es la dirección del bytei, y sirve para empezar desde ahí.- Una matriz es un arreglo de arreglos. Se guarda fila por fila, sin huecos.
m[i][j]está en la posicióni × columnas + j, y el tamaño total es filas × columnas × tamaño del elemento. - El orden de los ciclos decide el recorrido. La fila va primero en los índices:
m[i][j], nuncam[i, j]. - Un parámetro matriz lleva las columnas como constante,
int m[][COLS], y las filas se pasan aparte. Las columnas hacen falta para calcular la posición. Sinconsten este curso. - Un acceso con un índice de columna que no existe es comportamiento indefinido, aunque caiga dentro de la matriz.
- Una matriz de
charguarda varias cadenas, una por fila.
Ejercicios
-
¿Cuánto valen
strlen("Lima"),sizeof("Lima"),strlen("")ystrlen("ñu")? Escriban primero la respuesta a mano y después comprueben con%zu. -
Escriban
is_empty(const char s[]), que devuelva 1 si la cadena está vacía, sin usarstrlen. ¿Por qué es mejor que preguntarstrlen(s) == 0en una cadena muy larga? Después escriban en C el algoritmoultimo, conlast_char_safe(const char s[]), que devuelva'\0'si la cadena está vacía. Prueben las dos conassert, con"","a"y"sol". -
¿Qué escribe este fragmento? Respondan a mano, y después comprueben.
char s[6] = "hola"; printf("%d\n", strcmp(s, "hola") == 0); printf("%d\n", strcmp(s, "hol") > 0); printf("%d\n", strcmp(s, "Hola") < 0); -
Con
char d[4], sigan a manostrncpy(d, "sol", 4)y luegostrncpy(d, "luna", 4). Escriban en una tabla los 4 bytes deden cada caso. ¿En cuáldes una cadena? ¿Qué línea hay que agregar para que lo sea siempre, y qué texto queda entonces en el segundo caso? -
Escriban
has_extension(const char name[], const char extension[]), que devuelva 1 sistrstrencuentraextensiondentro dename, y 0 si no. Pruébenla con"notas.txt"y".txt". ¿Qué devuelve con"a.txt.bak"y".txt"? ¿Sirve para saber si el nombre termina en esa extensión? -
Para
int m[3][4], con unintde 4 bytes, ¿cuántos bytes ocupa la matriz? Si empieza en la dirección 1000, ¿dónde estánm[0][3],m[1][0]ym[2][3]? Comprueben conmatrix_layout.cque las diferencias entre esas direcciones son las que calcularon. -
Sigan a mano
column_sum(grades, 3, 2)con la matriz dematrix_param.c, en una tabla coni,grades[i][2]ytotal. -
Agreguen a
grades_table.cuna funciónrow_max(int m[][COURSES], int row), que devuelva la nota más alta de una fila. ¿Qué devuelve para cada estudiante? -
Escriban primero en pseudocódigo y después en C
is_identity(int m[][N]), para una matriz cuadrada deNfilas y columnas: devuelve 1 si tiene unos en la diagonal,m[i][i], y ceros en todas las demás casillas. Pruébenla conassert, con una matriz que sí lo es y con dos que no. -
Corrijan
errors/transpose_in_place.cpara que transponga de verdad, en el mismo arreglo. Pista: cada par debe intercambiarse una sola vez, así quejno debe empezar en 0. La salida debe ser1 4 7,2 5 8y3 6 9. -
Escriban
count_chars(const char s[], char c), igual acount_charde la semana pasada, para uncdistinto de'\0', pero ahora usandostrchren un ciclo y&s[i], con la misma idea decount_word. Comparen las dos versiones. ¿Cuál es más clara? -
Con la matriz
namesdenames.c, escribanlast_name(char names[][NAME_SIZE], int n), que devuelva el índice del nombre que va último segúnstrcmp. Después escribansort_two(char a[], char b[], int size), que deje en orden dos cadenas guardadas en arreglos desizebytes, consizede 20 como máximo. Usen un arreglo auxiliar de 20 bytes ysafe_copy. Pruébenla con los dos órdenes.