Apuntes · Capítulo 10Memoria y datos
Arreglos en funciones y cadenas
Arreglos en funciones y cadenas
La semana pasada guardamos muchos valores en un arreglo, pero todo el trabajo se hacía
dentro de main. En la semana 7 aprendimos a separar un programa en funciones. Hoy
juntamos las dos cosas: pasar un arreglo a una función. Veremos que aquí pasa algo
distinto que con un int: la función sí puede cambiar el arreglo de quien la llamó, y
además no sabe cuántos elementos tiene.
Con eso llegamos a las cadenas (strings): el texto en C. Una cadena no es un tipo
nuevo. Es un arreglo de char con una marca al final, y casi todo lo que se hace con
ella es recorrer ese arreglo con un ciclo. Al leer texto aparece el error más famoso
de C, el buffer overflow, y veremos cómo evitarlo.
Esta semana recorremos las cadenas a mano, sin string.h. La biblioteca de cadenas llega
la próxima semana, y entonces sabrán qué hace por dentro.
Lectura. El código de este capítulo está en
code/week-10. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Pasar un arreglo a una función” y “Por qué la función puede cambiar el arreglo”. Es lo mínimo para seguir la clase.
- En clase: “Mantener un vector: insertar y eliminar”, “Qué es una cadena”, “Recorrer una cadena”, “Leer texto con límite” y “Buffer overflow”.
- Después de clase: para el laboratorio, “El laboratorio, paso a paso”; para repasar, “Resumen” y “Ejercicios”.
Pasar un arreglo a una función
Queremos sumar las notas de un arreglo. Si lo hacemos en una función, servirá para cualquier arreglo de notas. En pseudocódigo, la función recibe el arreglo y cuántos elementos tiene:
algoritmo suma(a, n)
    total ← 0
    para i desde 0 hasta n - 1 hacer
        total ← total + a[i]
    fin para
    devolver total
fin algoritmo
En C:
int sum(int a[], int n) {
    int total = 0;
    for (int i = 0; i < n; i++) {
        total = total + a[i];
    }
    return total;
}
El parámetro int a[] dice que a es un arreglo de int. Los corchetes van vacíos.
Al llamar la función, se escribe solo el nombre del arreglo, sin corchetes:
int grades[N] = {14, 9, 17, 11, 20};
int total = sum(grades, N);
Con la longitud aparte, la misma función también puede sumar solo una parte del arreglo.
El programa sum_array.c hace las dos cosas. (double) total / N es el cast de la
semana 2: sin él, la división sería entera.
$ build/sum_array
Suma de las 5 notas: 71
Promedio: 14.20
Suma de las 3 primeras: 40
Sigamos a mano la llamada sum(grades, 3):
i |
a[i] |
total después de la vuelta |
|---|---|---|
| 0 | 14 | 14 |
| 1 | 9 | 23 |
| 2 | 17 | 40 |
Cuando i llega a 3, i < n es falso y el ciclo termina. La función nunca mira a[3].
El tamaño va aparte
¿Por qué hace falta el parámetro n? ¿No podría la función preguntar el tamaño con
sizeof? Probemos. El programa errors/sizeof_param.c imprime sizeof en main y
dentro de dos funciones. Una de ellas hasta tiene un 5 en el parámetro. gcc ya avisa
al compilar:
$ gcc -Wall -Wextra -std=c17 errors/sizeof_param.c -o build/sizeof_param
errors/sizeof_param.c: In function ‘print_size’:
errors/sizeof_param.c:5:48: warning: ‘sizeof’ on array function parameter ‘a’ will return size of ‘int *’ [-Wsizeof-array-argument]
    5 |     printf("en la función: %zu bytes\n", sizeof(a));
      |                                                ^
errors/sizeof_param.c:4:21: note: declared here
    4 | void print_size(int a[]) {
      |                 ~~~~^~~
errors/sizeof_param.c: In function ‘print_size_five’:
errors/sizeof_param.c:9:58: warning: ‘sizeof’ on array function parameter ‘a’ will return size of ‘int *’ [-Wsizeof-array-argument]
    9 |     printf("con [5] en el parámetro: %zu bytes\n", sizeof(a));
      |                                                          ^
errors/sizeof_param.c:8:26: note: declared here
    8 | void print_size_five(int a[5]) {
      |                      ~~~~^~~~
$ build/sizeof_param
en main: 20 bytes
en la función: 8 bytes
con [5] en el parámetro: 8 bytes
Es una advertencia, no un error: el programa compila y corre, pero el número no es el que
queríamos. En main, grades es el arreglo completo: 5 int de 4 bytes cada uno en este
entorno, 20 bytes. Dentro de la función, a ocupa 8 bytes, tenga los elementos que
tenga.
El mensaje dice por qué: sizeof devuelve el tamaño de int *. Esa notación es nueva. El
asterisco significa puntero (pointer): una variable que guarda una dirección de
memoria. int * se lee “dirección de un int”. En este entorno, una dirección ocupa 8
bytes; el lenguaje no fija ese número. Casi no vamos a declarar punteros en este curso, pero
sí hay que saber leer este mensaje.
Idea clave. Una función que recibe un arreglo recibe la dirección donde empieza, no el arreglo completo. Una dirección no dice cuántos elementos vienen después. Por eso la longitud se pasa en otro parámetro, y el número que se ponga entre los corchetes del parámetro no cambia nada.
Error común. Escribir
sizeof(a) / sizeof(a[0])dentro de la función para sacar el número de elementos. Esa cuenta solo sirve donde el arreglo fue declarado. Dentro de la función da otro número, sin relación con la longitud real. Lean la advertencia degcc.
Por qué la función puede cambiar el arreglo
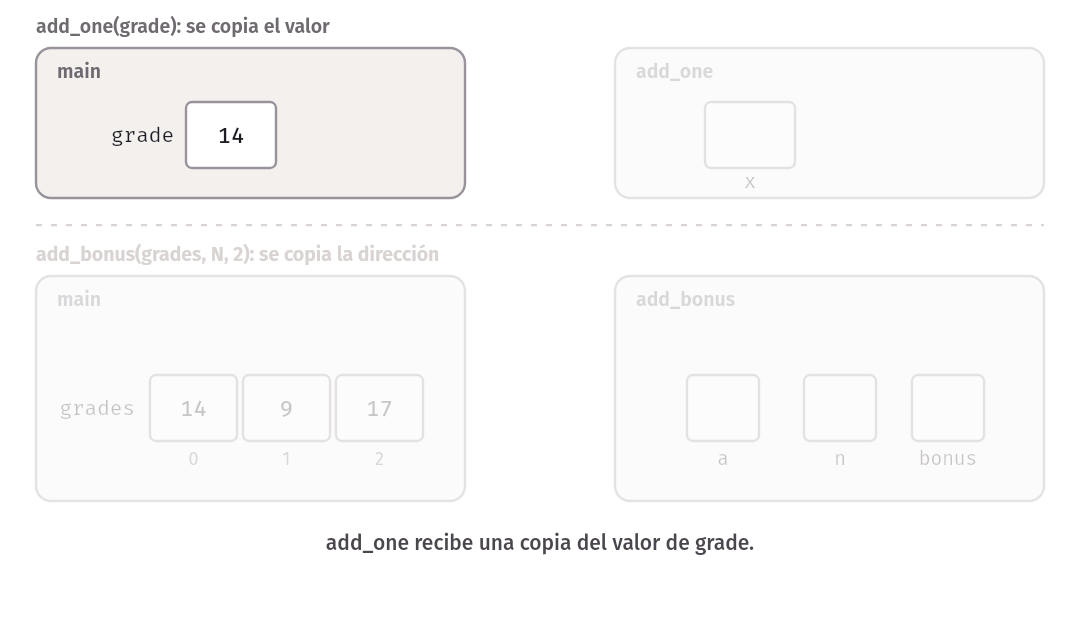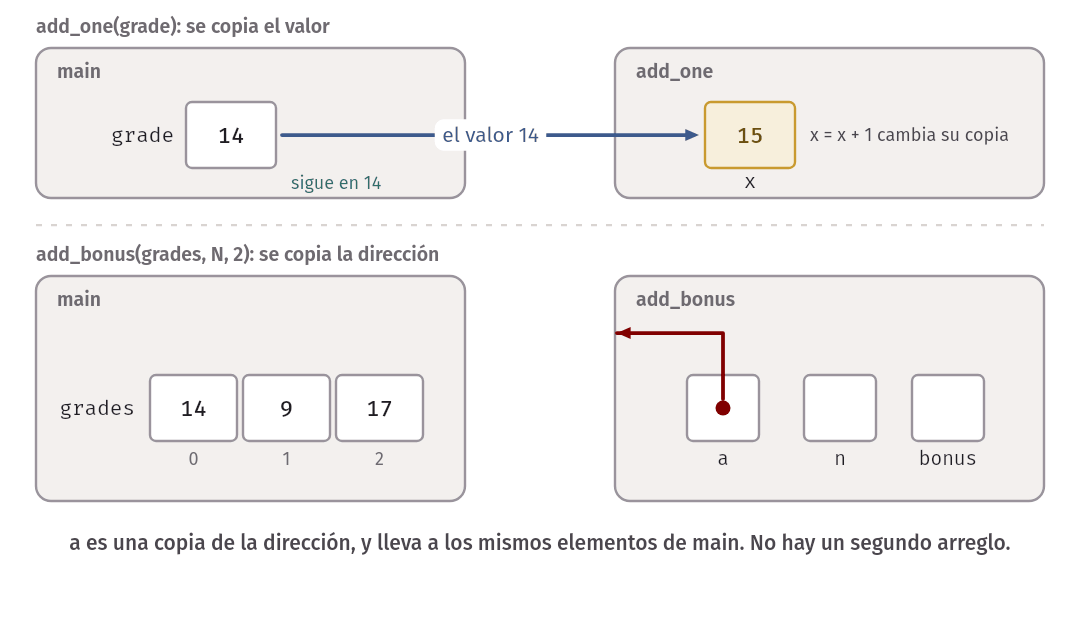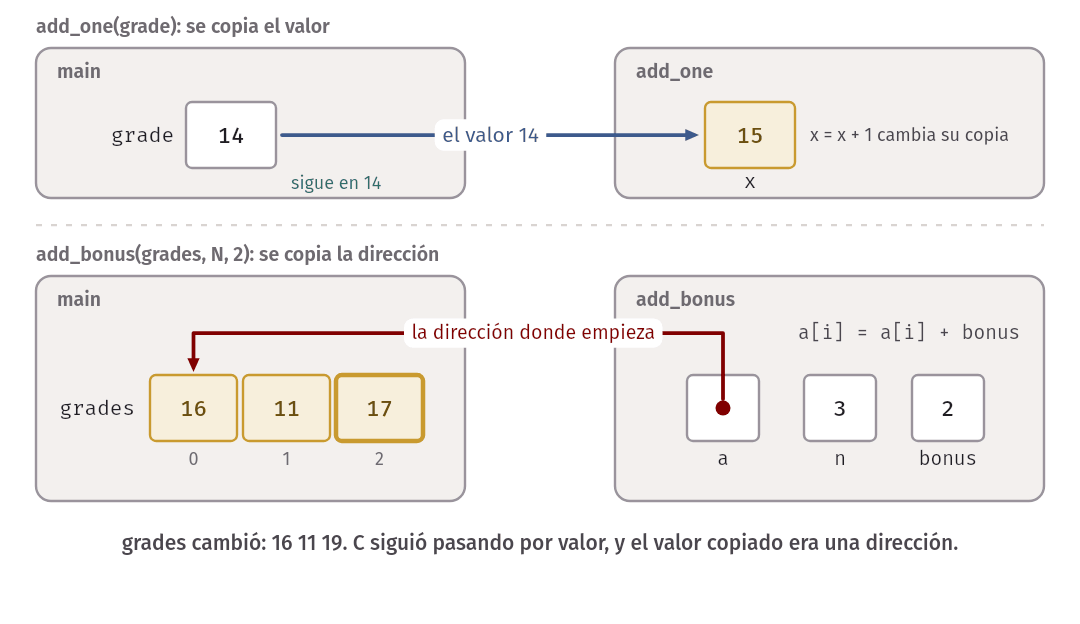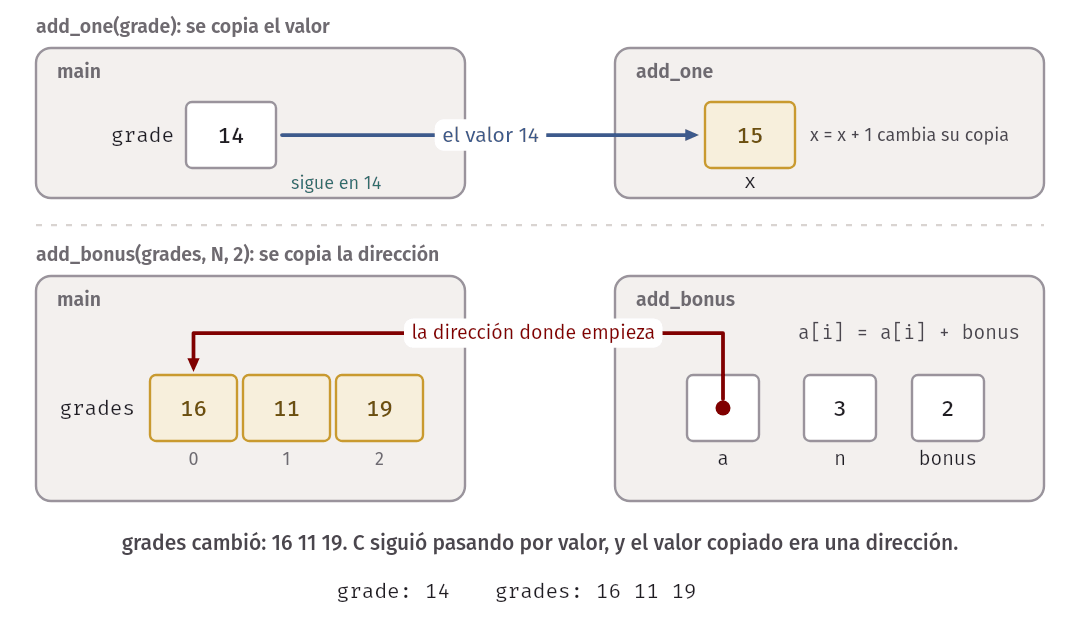
En la semana 7 vimos que C pasa los argumentos por valor: el parámetro es una copia. Por eso esta función no cambia nada afuera:
void add_one(int x) {
    x = x + 1;
}
Con un arreglo el resultado es otro. Esta función suma una bonificación a cada nota:
void add_bonus(int a[], int n, int bonus) {
    for (int i = 0; i < n; i++) {
        a[i] = a[i] + bonus;
    }
}
El programa bonus.c llama a las dos, con grade que vale 14 y con grades, que tiene
14, 9 y 17:
$ build/bonus
grade: 14
grades: 16 11 19
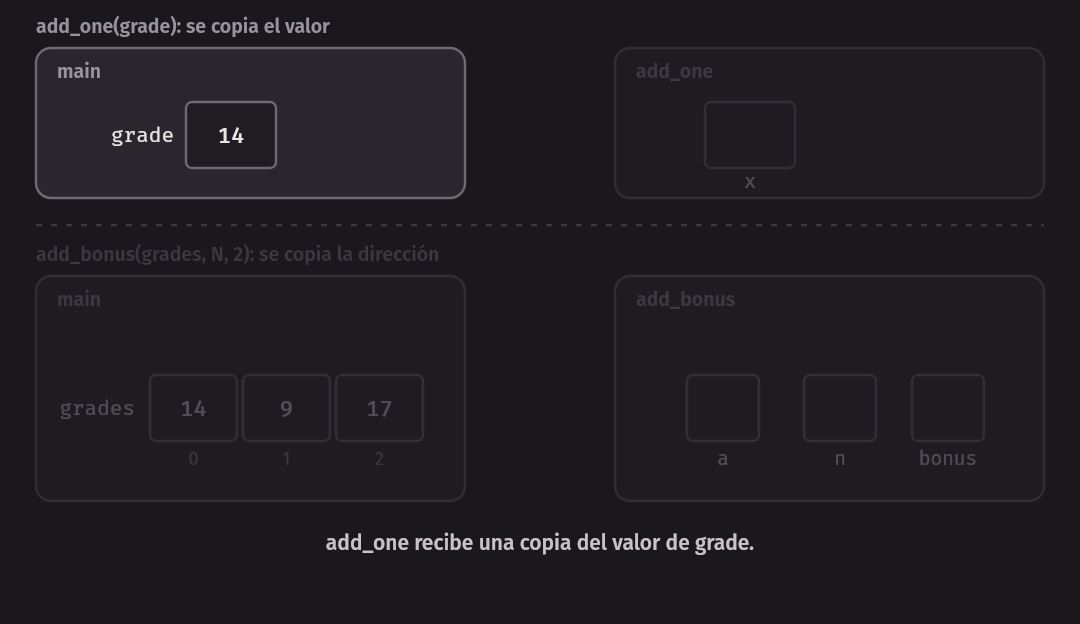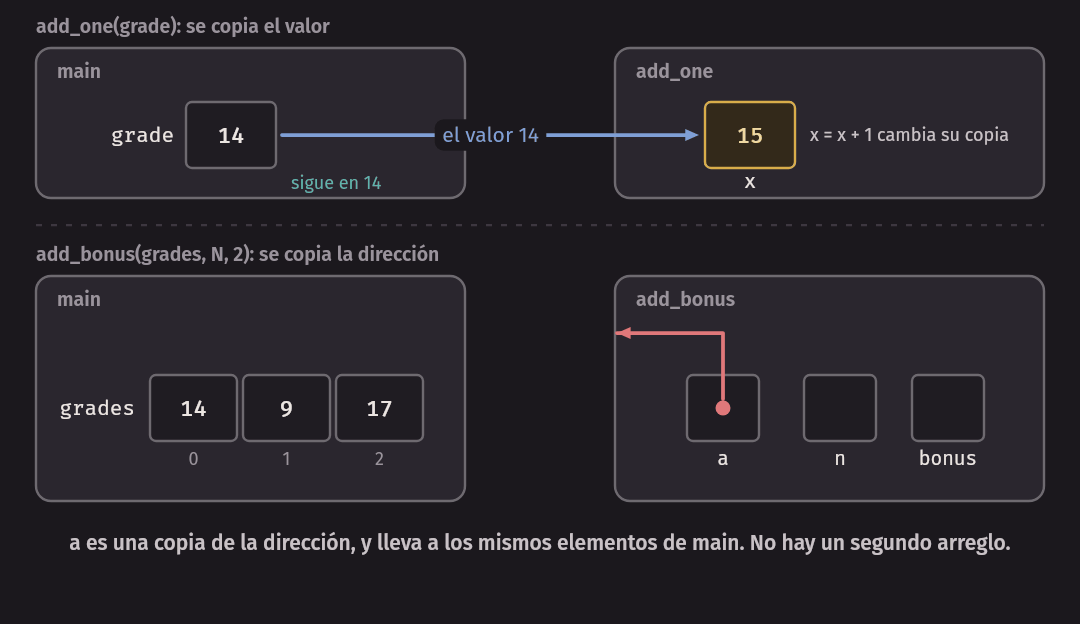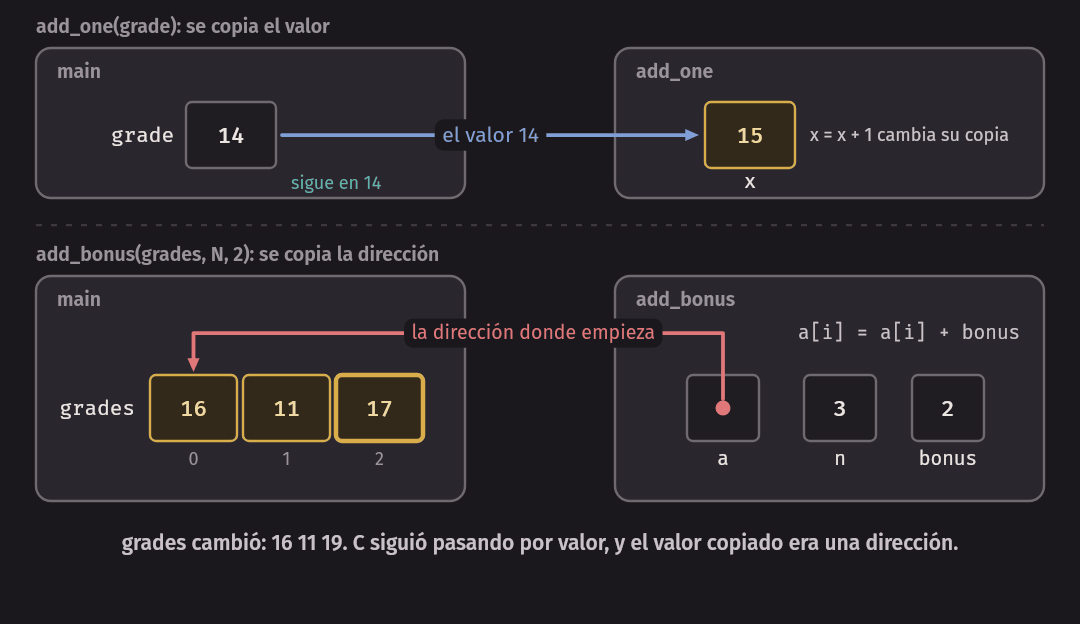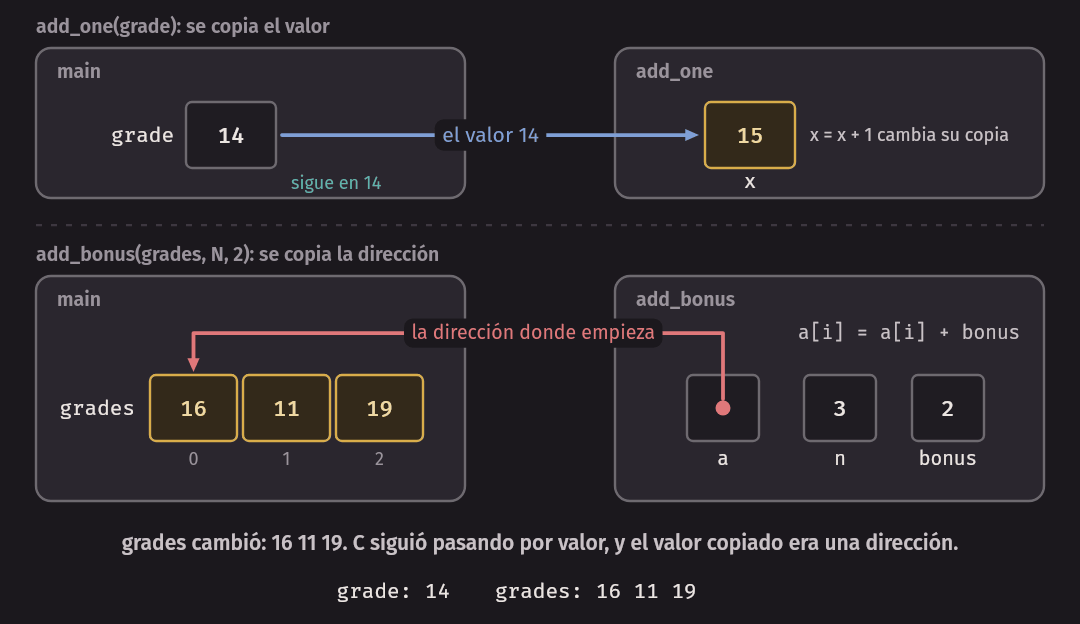
grade no cambió. Los elementos de grades sí. ¿Se rompió la regla? No: C sigue
pasando por valor, siempre. Lo que se copia cambia:
| Se llama con | Qué se copia al parámetro | Qué toca la función |
|---|---|---|
add_one(grade) |
el valor 14 | su propia copia |
add_bonus(grades, N, 2) |
la dirección donde empieza grades |
la memoria de ese arreglo |
La función tiene su propia copia de la dirección, pero esa copia apunta a los mismos
elementos de main. No existe un segundo arreglo. Es como dar a alguien la dirección de
su casa escrita en un papel: tiene una copia del papel, pero la casa es una sola.
Podemos verlo. same_address.c imprime la dirección con %p, como la semana pasada, en
los dos lugares:
$ build/same_address
en main, grades:  0xffff8c500020
en la función, a: 0xffff8c500020
Esas direcciones cambian con cada máquina y con cada corrida. Lo que importa es que las dos líneas muestran la misma.
¿Y cómo funciona a[i] si la función solo tiene la dirección de inicio? Como vimos la
semana pasada, los elementos están seguidos en memoria. Para llegar a a[i], se avanza
desde el inicio i veces el tamaño de un elemento. Para eso bastan la dirección y el
tipo int. La cuenta no necesita saber dónde termina el arreglo, y por eso nadie revisa
si i se pasó.
Idea clave. Un arreglo y una dirección no son lo mismo: en
main,sizeof(grades)da 20. Pero en casi toda expresión, el nombre del arreglo da la dirección de su inicio;sizeofes la excepción. Por eso, al pasarlo a una función, lo que viaja es su dirección. La función trabaja sobre el arreglo original, no sobre una copia.
const: prometer que no se cambia
Que la función pueda cambiar el arreglo no significa que deba. sum no tiene por qué
cambiarlo. Quien la llama querría saberlo con solo mirar su primera línea. Para eso existe
const en el parámetro:
int max_value(const int a[], int n) {const int a[] significa: esta función solo lee los elementos de a. El compilador lo
hace cumplir. Si la función intenta escribir, el programa no compila:
$ gcc -Wall -Wextra -std=c17 errors/const_write.c -o build/const_write
errors/const_write.c: In function ‘reset’:
errors/const_write.c:6:14: error: assignment of read-only location ‘*(a + (sizetype)((long unsigned int)i * 4))’
    6 |         a[i] = 0;
      |              ^
La parte importante es read-only location, lugar de solo lectura. Lo que sigue es la
forma como gcc escribe a[i] por dentro: desde a, avanza i por 4 bytes. Es la misma
cuenta del párrafo anterior.
Una función con const se puede llamar con un arreglo normal. La regla del curso desde
hoy: si la función no cambia el arreglo, su parámetro lleva const.
Mantener un vector: insertar y eliminar
Un arreglo de C tiene un tamaño fijo. Pero muchas veces la cantidad de datos cambia: se matricula un estudiante, otro se retira. La solución es separar dos números:
- la capacidad: cuántos elementos caben, fija desde la declaración;
- la longitud
n: cuántos elementos se están usando ahora.
Llamaremos vector a esa combinación. Los elementos en uso son de v[0] a v[n - 1]. Lo
que hay después no se usa.
Insertar
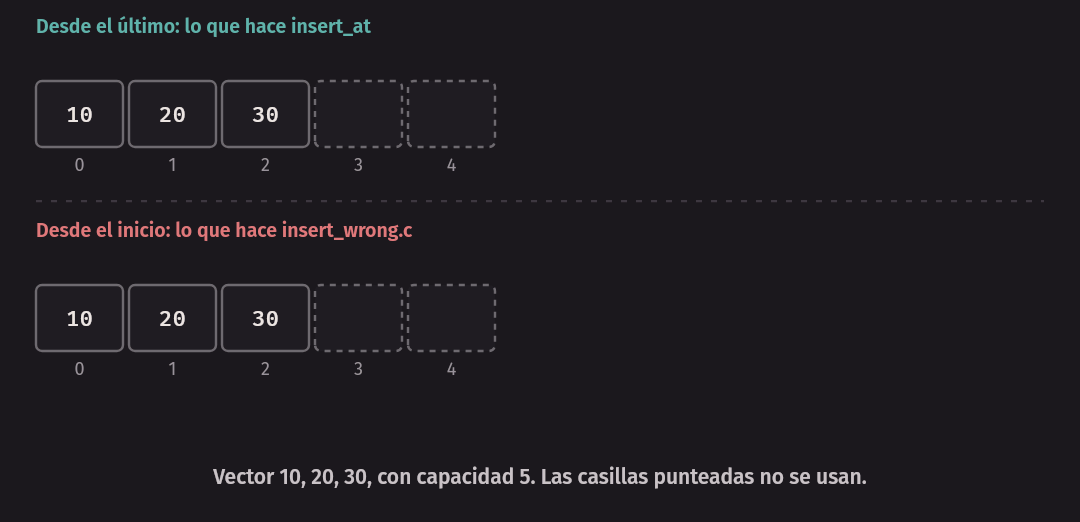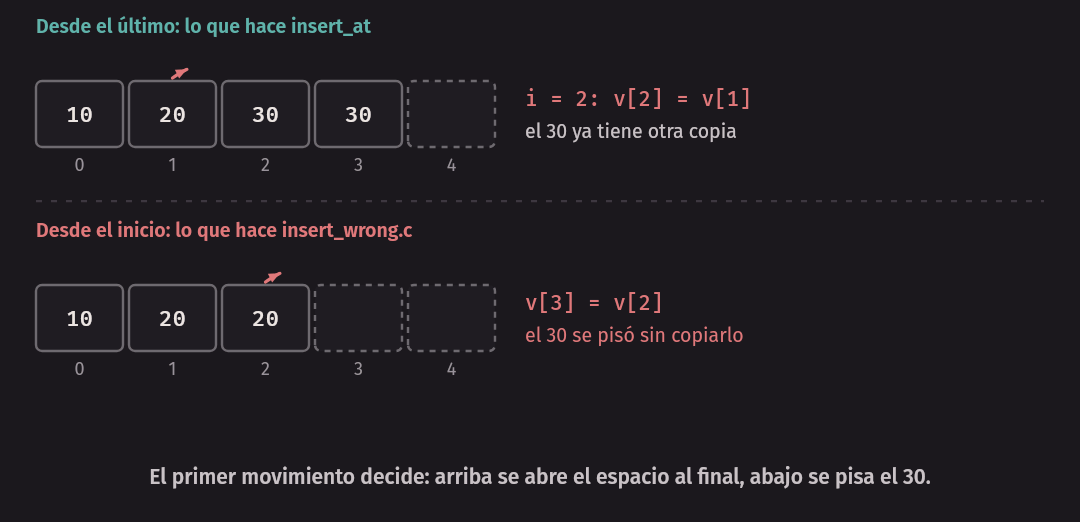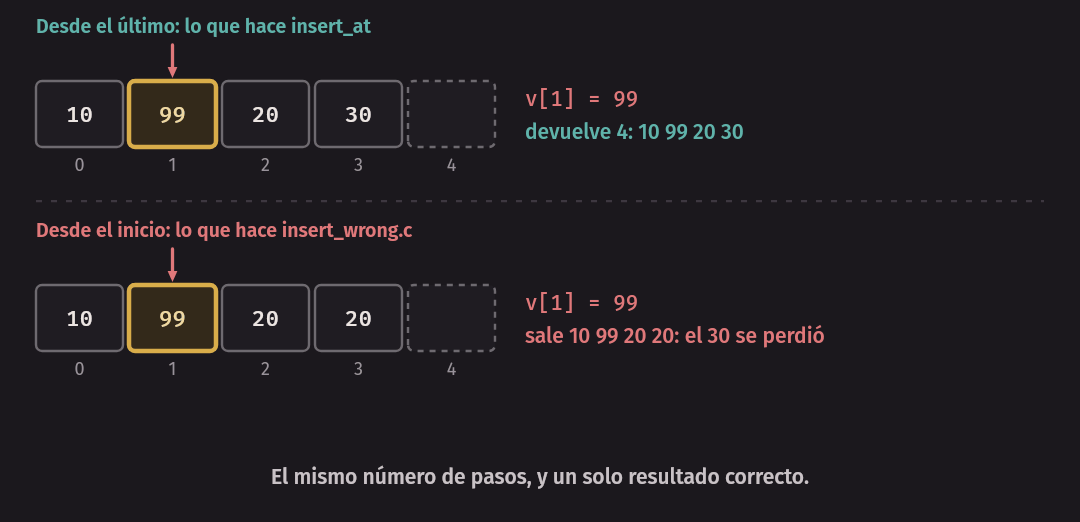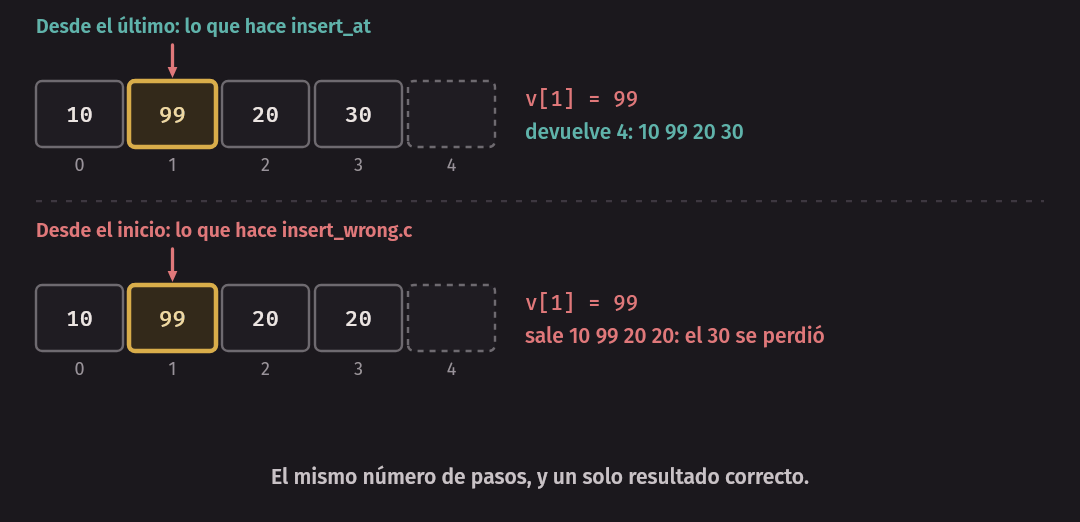
Para insertar en la posición pos hay que abrir un espacio: cada elemento desde pos en
adelante se mueve un lugar a la derecha. El orden importa. Se empieza por el último.
algoritmo insertar(v, n, capacidad, pos, valor)
    si n ≥ capacidad o pos < 0 o pos > n entonces
        devolver n
    fin si
    i ← n
    mientras i > pos hacer
        v[i] ← v[i - 1]
        i ← i - 1
    fin mientras
    v[pos] ← valor
    devolver n + 1
fin algoritmo
La función devuelve la longitud nueva. El arreglo sí lo cambia en el sitio, pero n es un
int y llega por valor: la función no puede cambiar la n de main. Por eso main
guarda lo que devuelve. Si no se puede insertar, porque está lleno o porque pos no
existe, no cambia nada y devuelve la misma longitud. pos puede ser igual a n: eso
agrega al final.
int insert_at(int v[], int n, int capacity, int pos, int value) {
    if (n >= capacity || pos < 0 || pos > n) {
        return n;
    }
    for (int i = n; i > pos; i--) {
        v[i] = v[i - 1];
    }
    v[pos] = value;
    return n + 1;
}
i-- resta 1 a i, como i++ suma. Sigamos insert_at con el vector 10, 20, 30 y una
capacidad de 5, insertando 99 en la posición 1. Un guion indica una casilla que no se usa:
| Paso | v[0] |
v[1] |
v[2] |
v[3] |
v[4] |
|---|---|---|---|---|---|
Inicio, n = 3 |
10 | 20 | 30 | - | - |
i = 3: v[3] = v[2] |
10 | 20 | 30 | 30 | - |
i = 2: v[2] = v[1] |
10 | 20 | 20 | 30 | - |
i = 1: i > pos es falso, se sale del ciclo |
10 | 20 | 20 | 30 | - |
v[1] = 99, se devuelve 4 |
10 | 99 | 20 | 30 | - |
Por un momento hay valores repetidos. Es normal: cada valor se copió antes de que su casilla se pisara.
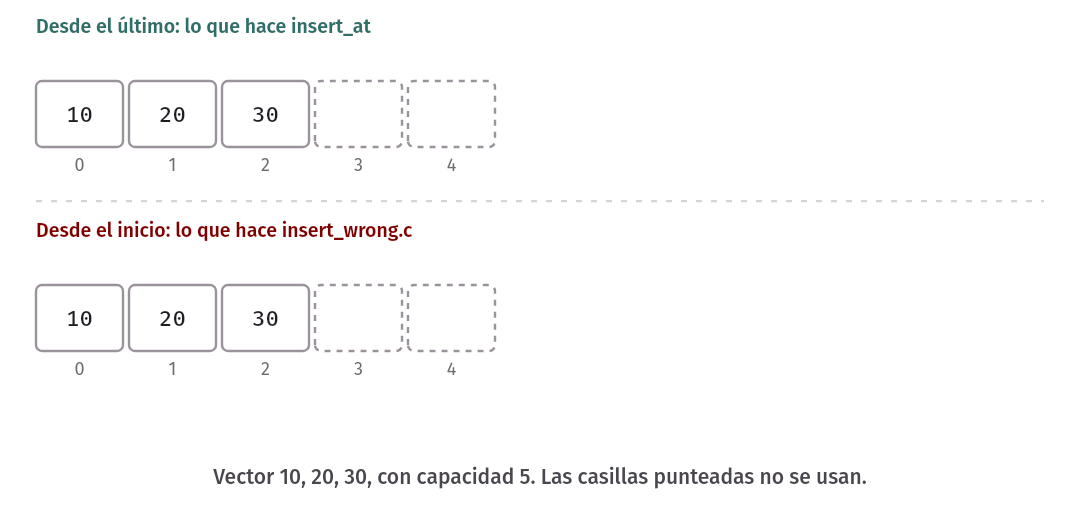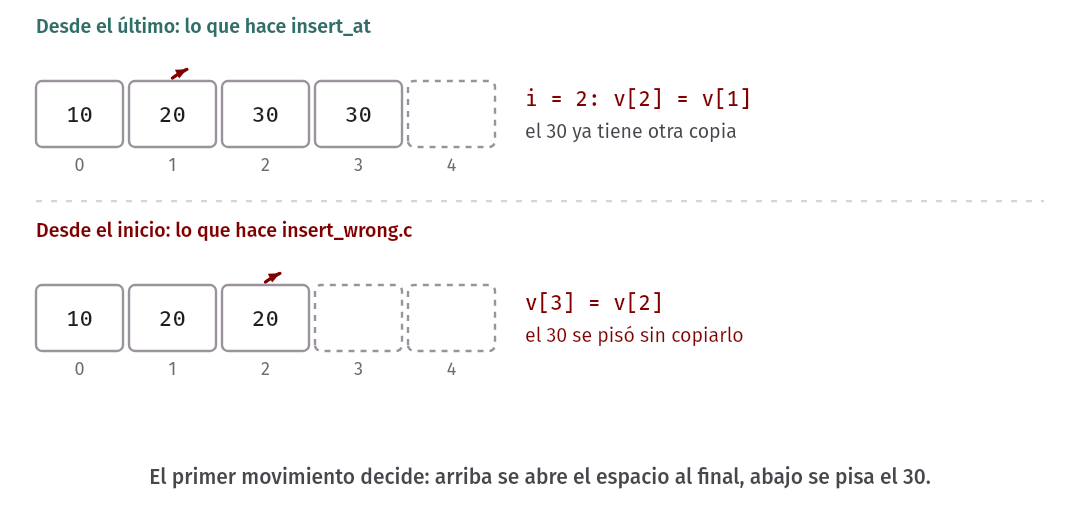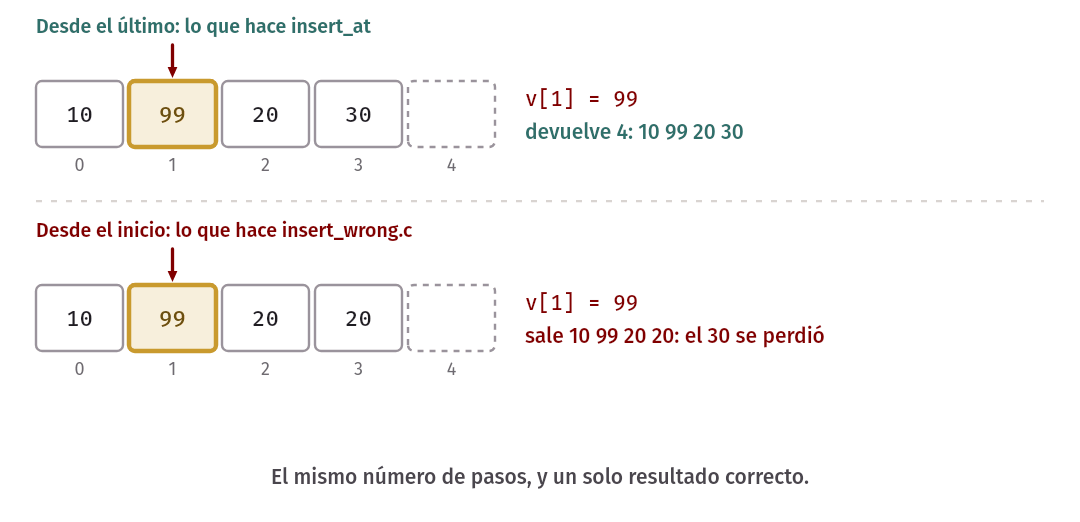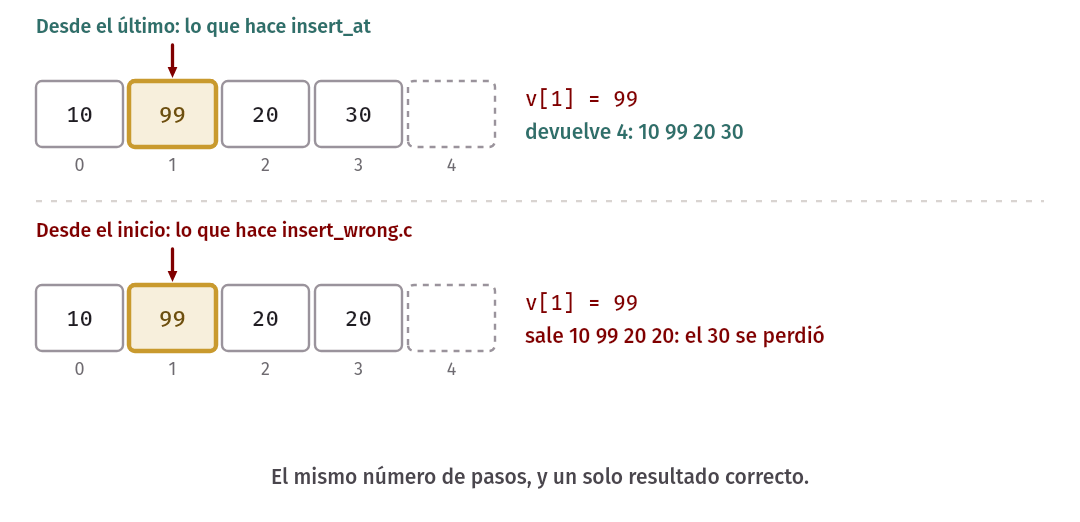
Error común. Abrir el espacio moviendo desde el inicio. El programa
errors/insert_wrong.chacev[2] = v[1]y despuésv[3] = v[2], perov[2]ya no tiene el 30: se perdió.$ gcc -Wall -Wextra -std=c17 errors/insert_wrong.c -o build/insert_wrong $ build/insert_wrong 10 99 20 20
Eliminar
Para eliminar se hace lo contrario: los elementos después de pos se mueven un lugar a la
izquierda. Aquí se empieza por el primero, el de más a la izquierda, porque ahora es el
que se puede pisar sin perder nada.
algoritmo eliminar(v, n, pos)
    si pos < 0 o pos ≥ n entonces
        devolver n
    fin si
    para i desde pos hasta n - 2 hacer
        v[i] ← v[i + 1]
    fin para
    devolver n - 1
fin algoritmo
int remove_at(int v[], int n, int pos) {
if (pos < 0 || pos >= n) {
return n;
}
for (int i = pos; i < n - 1; i++) {
v[i] = v[i + 1];
}
return n - 1;
}El último elemento sigue en su casilla, pero ya no cuenta, porque n bajó. El límite
i < n - 1 evita leer v[n]. El programa vector.c usa una capacidad de 5 y prueba
también los dos casos que no se pueden hacer: insertar con el vector lleno y eliminar
una posición que no existe.
$ build/vector
n = 3: 10 20 30
n = 4: 10 99 20 30
n = 5: 10 99 20 30 40
n = 5: 10 99 20 30 40
n = 4: 99 20 30 40
n = 3: 99 20 30
n = 3: 99 20 30
Idea clave. La función recibe la capacidad porque no tiene otra forma de saberla. Toda función que puede escribir más allá de lo que el arreglo ya tiene necesita conocer cuánto espacio hay. Cambiar bytes de una cadena, sin alargarla, no lo necesita. Esta idea va a volver con las cadenas.
Qué es una cadena
Una cadena (string) en C es un arreglo de char que termina en el carácter nulo,
'\0'. No hay más: no es un tipo aparte. El '\0' es un byte con el valor 0, y marca dónde
termina el texto.
char s[] = "hola";Un texto entre comillas dobles, como "hola", se llama literal de cadena. Aquí no se
indicó el tamaño, así que C lo calcula: 4 letras y el '\0', 5 bytes. El '\0' lo
agrega C solo. Por eso 'A' y "A" no son lo mismo, como adelantamos en la semana 3:
'A' es un carácter, un número; "A" es una cadena de 2 bytes, 'A' y '\0'.
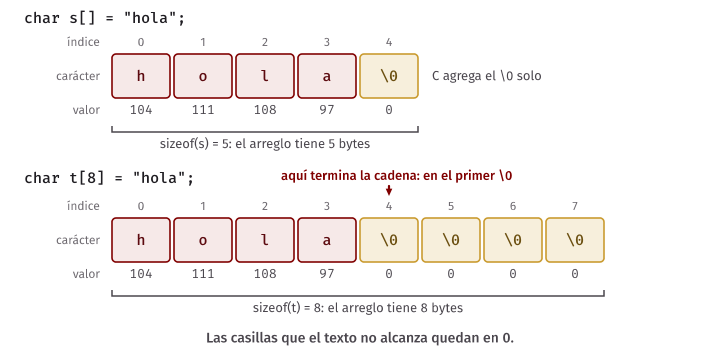
El arreglo puede ser más grande que el texto. Con char t[8] = "hola"; se reservan 8 bytes.
Cuando se inicializa un arreglo, las casillas que el texto no alcanza quedan en 0, así que
el sobrante se llena con '\0'. La cadena termina en el primer '\0'.
Así quedan los dos en memoria. Los códigos son los de ASCII, de la semana 3:
El programa string_bytes.c lo muestra con números. (int) sizeof(s) es un cast para
comparar con i sin mezclar tipos. Dentro de un texto de printf, \\ escribe una barra:
$ build/string_bytes
sizeof(s) = 5
s[0] = 104
s[1] = 111
s[2] = 108
s[3] = 97
s[4] = 0
sizeof(t) = 8
 104 111 108 97 0 0 0 0
'\0' vale 0 y '0' vale 48
Fíjense en la última línea: '\0' es el byte con valor 0, y '0' es el dígito cero, con
código 48. Son cosas distintas.
Escribir una cadena
printf escribe una cadena con %s. Le damos la dirección de inicio, y escribe byte por
byte hasta encontrar un '\0'. Como una cadena guardada en un arreglo es un arreglo, se
puede cambiar por índice. cut_string.c cambia una letra y luego pone un '\0' en medio:
s[0] = 'H';
printf("%s\n", s);
s[2] = '\0';
printf("%s\n", s);
$ build/cut_string
hola
Hola
Ho
sizeof(s) sigue siendo 5Después de s[2] = '\0', el texto es Ho, pero el arreglo sigue teniendo 5 bytes. Los
bytes a y \0 del final siguen ahí; nadie los mira. La longitud de la cadena y el
tamaño del arreglo son dos cosas distintas.
Olvidar el espacio para \0
El error más común de este capítulo es no contar el byte del '\0'. Si el texto no cabe
ni sin el '\0', gcc avisa:
$ gcc -Wall -Wextra -std=c17 errors/too_long.c -o build/too_long
errors/too_long.c: In function ‘main’:
errors/too_long.c:5:20: warning: initializer-string for array of ‘char’ is too long
    5 |     char word[3] = "hola";
      |                    ^~~~~~
Pero si faltaba solo el byte del '\0', en este gcc no hay ninguna advertencia:
$ gcc -Wall -Wextra -std=c17 errors/no_terminator.c -o build/no_terminatorchar word[4] = "hola"; es válido en C: guarda los 4 bytes y ningún '\0'. Eso es un
arreglo de char, no una cadena. Y printf("%s\n", word) no sabe que debe parar: sigue
leyendo después del final del arreglo hasta que por casualidad encuentre un 0. Eso es
comportamiento indefinido. El resultado no se puede predecir.
Aquí sirve lo que aprendieron la semana pasada. La opción -g agrega al ejecutable la
información que relaciona el programa con su código fuente, como los números de línea. La
opción -fsanitize=address agrega revisiones de memoria que corren mientras el programa
se ejecuta. Es otra cosa que un mensaje de compilación: gcc compila sin quejarse, y es
el programa el que se detiene al correr. Este informe está recortado, y sus direcciones
cambian en cada corrida:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/no_terminator.c -o build/no_terminator_san
$ build/no_terminator_san
==27466==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff89b00024 at pc 0xffff8c8aa4dc bp 0xffffe1ada3d0 sp 0xffffe1ada410
READ of size 5 at 0xffff89b00024 thread T0
    #0 0xffff8c8aa4d8 in puts ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors.inc:1236
    #1 0xaaaaafd60c94 in main errors/no_terminator.c:7
Quiso leer 5 bytes desde un arreglo que tiene 4: buscaba el '\0' que no está, y leyó hasta el
primer 0 que encontró, que en esta corrida estaba justo después. puts es
una función de stdio.h que escribe una cadena. No la llamamos nosotros: el compilador
cambió nuestro printf por ella.
Error común. Para guardar un texto de
kbytes se necesitank + 1bytes. Nunca llamen cadena a un arreglo decharsin'\0', y nunca lo pasen a algo que espere una cadena.
No cambiar un literal
Hay una diferencia importante entre el arreglo y el literal. char s[] = "hola"; crea un
arreglo propio con una copia del texto, y ese arreglo se puede cambiar. En cambio, el
literal "hola" por sí solo no se debe cambiar: intentarlo es comportamiento indefinido,
y el compilador no siempre avisa. Esta función recibe un parámetro sin const, y
errors/literal_write.c la llama primero con un arreglo, que está bien, y luego con un literal:
set_first(copy, 'H');
printf("%s\n", copy);
set_first("hola", 'H');
Compila sin advertencias. Esto salió en esta corrida, en este entorno. Que muera o no, depende del sistema; el lenguaje no promete nada:
$ gcc -Wall -Wextra -std=c17 errors/literal_write.c -o build/literal_write
$ build/literal_write; echo "estado: $?"
bash: line 1: 32410 Segmentation fault      build/literal_write
estado: 139
El segmentation fault es un error del sistema: el programa tocó memoria de una forma no
permitida, y el sistema operativo lo terminó. echo "estado: $?" muestra el estado de
salida del comando anterior; el ; separa dos comandos, que corren uno tras otro. Falta el
Hola del primer printf, porque esta salida se capturó con un programa y no se escribió en una
terminal. En ese caso, printf guarda el texto un rato antes de escribirlo, y al morir el
programa se perdió. En su terminal es probable que sí lo vean. Por eso, si una función no cambia
una cadena, su parámetro lleva const: recibir un literal es seguro.
Recorrer una cadena
Una función que recibe una cadena no recibe su longitud, y no la necesita: la marca
'\0' dice dónde termina. Por eso, a diferencia de los arreglos de números, para leer
una cadena basta su dirección. El ciclo clásico avanza hasta encontrar el '\0'.
La longitud, a mano
En pseudocódigo escribiremos NULO para el carácter que termina la cadena.
algoritmo longitud(s)
    i ← 0
    mientras s[i] ≠ NULO hacer
        i ← i + 1
    fin mientras
    devolver i
fin algoritmo
En C se llama my_strlen. El parámetro lleva const porque solo lee:
int my_strlen(const char s[]) {
    int i = 0;
    while (s[i] != '\0') {
        i++;
    }
    return i;
}
Sigámosla con "sol":
i |
s[i] |
¿s[i] != '\0'? |
|---|---|---|
| 0 | s |
sí, i pasa a 1 |
| 1 | o |
sí, i pasa a 2 |
| 2 | l |
sí, i pasa a 3 |
| 3 | \0 |
no, se devuelve 3 |
El resultado es el índice donde está el '\0', que coincide con cuántos bytes hay antes. El
'\0' no se cuenta. Y con la cadena vacía, "", el ciclo no corre ninguna vez y da 0.
La biblioteca de C trae una función que hace esta misma cuenta, strlen. La usaremos desde
la próxima semana. Hoy la escribimos para saber que no tiene nada de magia, y que tarda más
cuanto más larga es la cadena, porque tiene que recorrerla.
Las pruebas con assert son las de la semana 7, y cubren los bordes:
assert(my_strlen("") == 0);
assert(my_strlen("a") == 1);
assert(my_strlen("hola") == 4);
El programa my_strlen.c también compara longitud y tamaño. Dentro de un texto de printf,
\" escribe una comilla doble:
$ build/my_strlen
my_strlen(t) = 4
sizeof(t) = 8
my_strlen("ano") = 3
my_strlen("año") = 4
La última línea sorprende: año tiene 3 letras, pero my_strlen da 4.
UTF-8: se cuentan bytes, no letras
Ya lo sabemos desde la semana 3: en UTF-8, la ñ ocupa 2 bytes, c3 y b1. Y un char
guarda un byte, no una letra. La cadena "año" en memoria es:
| Índice | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| Contenido | a |
primer byte de ñ |
segundo byte de ñ |
o |
\0 |
| En hexadecimal | 61 |
c3 |
b1 |
6f |
00 |
my_strlen hace exactamente lo que dice su definición: cuenta bytes hasta el '\0'. Da 4.
strlen hace lo mismo, así que strlen("año") también vale 4. No es un error de la
función. Lo que hay que tener claro es qué mide: la longitud de una cadena en C es su
número de bytes, y coincide con el número de letras solo si todo el texto es ASCII. Esto
importa también al reservar: "año" necesita un arreglo de 5 bytes, no de 4.
Probar letras: solo ASCII
Dentro de un if, un char se compara como el número que es. Las letras de la a a la z
tienen códigos seguidos en ASCII, así que esta condición detecta una minúscula:
int count_lowercase(const char s[]) {
    int count = 0;
    for (int i = 0; s[i] != '\0'; i++) {
        if (s[i] >= 'a' && s[i] <= 'z') {
            count++;
        }
    }
    return count;
}
$ build/count_lowercase
Hola Mundo: 7
LIMA 2026: 0
ano: 3
año: 2En año cuenta 2: la a y la o. Los dos bytes de la ñ no están entre 'a' y 'z'. Eso
se cumple tanto en una máquina donde char tiene signo, donde esos bytes son negativos,
como en una donde no lo tiene, donde valen 195 y 177. Como vimos en la semana 3, cada
plataforma decide eso. El resultado es el mismo, pero queda claro el límite: esta
comparación solo entiende letras ASCII. No reconoce ñ ni á. En este curso eso basta.
Tratar bien todo Unicode requiere mucho más.
Para pasar de minúscula a mayúscula sirve lo de la semana 3: 'a' - 'A' vale 32, y es la
misma distancia para todas las letras ASCII.
En C.
ctype.htrae funciones comoislowerytoupper. Reciben unint, y con uncharnegativo tienen comportamiento indefinido. Por eso, si las usan, se llaman con un cast:islower((unsigned char) s[i]). En este capítulo no las necesitamos.
Leer texto con límite
Leer texto es peligroso de una forma que leer números no lo es: quien escribe decide cuántos bytes vienen, y el arreglo tiene un tamaño fijo. Todo lo que sigue responde a una pregunta: ¿qué pasa si el texto no cabe?
Primero, un nombre. Una zona de memoria reservada para guardar datos que van llegando se
llama buffer. Nuestros arreglos de char son buffers.
scanf con ancho: una palabra
scanf lee una cadena con %s. Sin un límite nunca se debe usar. El límite es un número
entre % y s: %19s lee como máximo 19 bytes y agrega el '\0'. Para un buffer de 20
bytes, se escribe un 19: siempre uno menos que el tamaño.
char word[20];
if (scanf("%19s", word) != 1) {
Noten que word no lleva &. El & de scanf sirve para darle la dirección de una
variable, como vimos en la semana 2. Pero word ya entrega la dirección del arreglo.
%s lee una palabra: salta los espacios del inicio y se detiene en el primer espacio o
salto de línea. El resto queda sin leer, esperando la siguiente lectura. El programa
read_word.c hace dos lecturas seguidas para mostrarlo:
$ echo "Ana María" | build/read_word
Primera lectura: Ana
Segunda lectura: María
$ echo "uno" | build/read_word
Primera lectura: uno
No hay más palabras
$ echo abcdefghijklmnopqrstuvwxyz | build/read_word
Primera lectura: abcdefghijklmnopqrs
Segunda lectura: tuvwxyz
El último caso es la protección: leyó 19 bytes y no se pasó del arreglo. Lo que no cupo
quedó para la siguiente lectura. Y el límite cuenta bytes, no letras, así que %19s podría
cortar una ñ por la mitad.
fgets: una línea
Para leer una línea completa, con espacios, se usa fgets, de stdio.h:
if (fgets(name, SIZE, stdin) == NULL) {Recibe tres cosas: dónde guardar, el tamaño del buffer, y de dónde leer. stdin es la
entrada estándar, la misma de scanf. fgets lee hasta el salto de línea, o hasta llenar
SIZE - 1 bytes, lo que ocurra primero. Si lee algo, siempre agrega el '\0'. Como el tamaño es un
parámetro, se escribe directamente SIZE, sin restar nada: fgets ya reserva el lugar.
Devuelve NULL si no pudo leer nada porque se acabó la entrada. NULL es un valor especial
que significa “ninguna dirección”, y está definido en stdio.h. Es la forma como fgets avisa.
El programa read_line.c tiene un buffer de solo 8 bytes, y muestra qué dejó fgets en cada
lectura. El ciclo while (fgets(line, SIZE, stdin) != NULL) lee hasta que se acabe la
entrada. El programa escribe el salto de línea como \n visible. Le damos el texto con
printf de la terminal, que no agrega nada: escribe un salto solo donde ponemos \n.
Primer caso: la línea cabe. fgets conserva el salto de línea:
$ printf 'Ana\n' | build/read_line
leído: "Ana\n"
fgets devolvió NULL
Segundo caso: la última línea no tiene salto. No hay \n que guardar:
$ printf 'Ana' | build/read_line
leído: "Ana"
fgets devolvió NULL
Tercer caso: la línea no cabe. Toma 7 bytes, y la siguiente llamada sigue donde quedó:
$ printf 'Alejandra\n' | build/read_line
leído: "Alejand"
leído: "ra\n"
fgets devolvió NULL
Cuarto caso: no hay nada. La primera llamada ya devuelve NULL:
$ printf '' | build/read_line
fgets devolvió NULL
Con un teclado, el fin de la entrada se indica con Ctrl+D.
Idea clave. Después de
fgets, lo que indica si la línea cupo completa es el\n. Si está, se leyó la línea entera. Si no está, o no cupo, o era la última línea sin salto.
Quitar el salto y descartar el resto
Casi siempre el \n estorba, y lo que no cupo también. Se resuelve con dos funciones
pequeñas. La primera recorre la cadena buscando el \n, y pone un '\0' en su lugar:
int remove_newline(char s[]) {
    for (int i = 0; s[i] != '\0'; i++) {
        if (s[i] == '\n') {
            s[i] = '\0';
            return 1;
        }
    }
    return 0;
}
La segunda lee con getchar, de la semana 5, hasta terminar la línea actual. c es int y
no char, porque getchar puede devolver EOF, un valor distinto de todos los bytes:
void discard_rest(void) {
    int c = getchar();
    while (c != '\n' && c != EOF) {
        c = getchar();
    }
}
Con las dos se arma una función que lee una línea y deja la entrada lista para la siguiente:
int read_text(char s[], int size) {
    if (fgets(s, size, stdin) == NULL) {
        return 0;
    }
    if (!remove_newline(s)) {
        discard_rest();
    }
    return 1;
}
El programa read_name.c lee un nombre y una ciudad, en buffers de 20 bytes. En el segundo
caso, el nombre no cabe: se guardan 19 bytes y el resto se descarta. Sin discard_rest,
la ciudad recibiría el resto del nombre. En el tercero falta la ciudad:
$ printf 'Ana María\nLima\n' | build/read_name
Nombre: Ana María
Ciudad: Lima
$ printf 'Maria de los Angeles Quispe\nLima\n' | build/read_name
Nombre: Maria de los Angele
Ciudad: Lima
$ printf 'Ana\n' | build/read_name
Entrada inválida
Error común. Mezclar
scanfyfgets.scanf("%d", &age)lee el número, pero deja en la entrada el salto de línea que viene después. El siguientefgetsencuentra ese salto y termina de inmediato, con una línea vacía:$ gcc -Wall -Wextra -std=c17 errors/scanf_then_fgets.c -o build/scanf_then_fgets $ printf '18\nAna\n' | build/scanf_then_fgets Edad: 18 Nombre:La corrección, en
age_name.c, es llamar adiscard_restdespués delscanf:$ printf '18\nAna\n' | build/age_name Edad: 18 Nombre: Ana
Un resumen para elegir
| Quieren leer | Usen | El límite | Cuidado con |
|---|---|---|---|
| una palabra | scanf("%19s", word) |
19 para 20 bytes | se detiene en el primer espacio |
| una línea | fgets(line, 20, stdin) |
20 para 20 bytes | conserva el \n si cabe |
En los dos casos se revisa el resultado: scanf debe devolver 1, y fgets no debe devolver
NULL. Existe una función antigua, gets, que lee una línea sin ningún límite. Era tan
insegura que se eliminó del lenguaje en C11. Nunca se usa.
Buffer overflow
Un buffer overflow ocurre cuando un programa escribe más allá del espacio reservado. Ya vieron la semana pasada qué pasa al salirse de un arreglo. La diferencia es que aquí no se equivocó un índice: el dato llegó de afuera, y lo eligió otra persona.
Este programa, errors/overflow_scanf.c, tiene el error clásico. Usa %s sin límite:
char name[8];
if (scanf("%s", name) != 1) {
Compila sin ninguna advertencia con nuestras opciones. Con un nombre corto, funciona bien. Por eso este error sobrevive tanto tiempo: las pruebas normales pasan.
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/overflow_scanf.c -o build/overflow_san
$ echo Ana | build/overflow_san
Hola, Ana
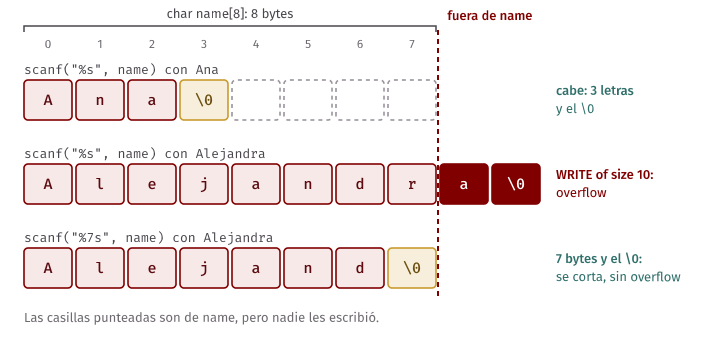
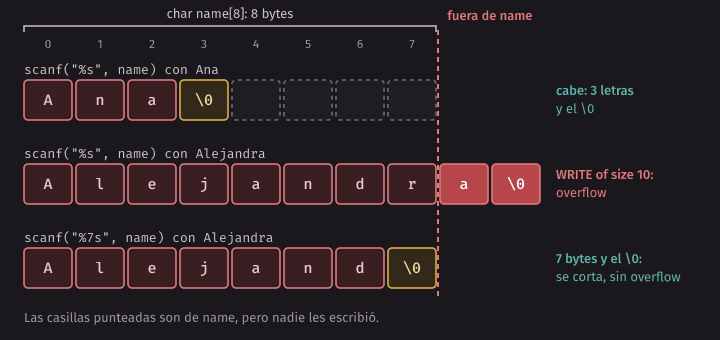
Con Alejandra, 9 letras y un '\0', se necesitan 10 bytes, y name tiene 8.
Leer el informe
El informe real es mucho más largo, y aquí está recortado. Las direcciones, el número de proceso de la primera línea y las líneas de biblioteca cambian de una corrida o una máquina a otra:
$ echo Alejandra | build/overflow_san
==27460==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffff91b00028 at pc 0xffff94955f3c bp 0xfffff88736e0 sp 0xfffff8873790
WRITE of size 10 at 0xffff91b00028 thread T0
    #0 0xffff94955f38 in scanf_common ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors_format.inc:342
    #1 0xffff949811d0 in __isoc99_vscanf ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors.inc:1489
    #2 0xffff94981b6c in __isoc99_scanf ../../../../src/libsanitizer/sanitizer_common/sanitizer_common_interceptors.inc:1520
    #3 0xaaaaab740e44 in main errors/overflow_scanf.c:7

Address 0xffff91b00028 is located in stack of thread T0 at offset 40 in frame
    #0 0xaaaaab740db4 in main errors/overflow_scanf.c:4

  This frame has 1 object(s):
    [32, 40) 'name' (line 5) <== Memory access at offset 40 overflows this variable
Se lee buscando cuatro cosas:
- Qué pasó:
stack-buffer-overflow, un buffer overflow en la pila. - Qué operación:
WRITE of size 10. Quiso escribir 10 bytes. Es nuestra cuenta. - Dónde en nuestro código: la pila de llamadas se lee de arriba abajo. Las primeras
líneas están dentro de la biblioteca. La primera con un archivo nuestro,
main errors/overflow_scanf.c:7, es la línea delscanf. Ese número existe gracias a-g. - Qué variable:
'name' (line 5), con la flecha que dice que el acceso se sale de esa variable. El marco (frame) es la parte de la pila que le toca amain.[32, 40)son los 8 bytes denamedentro del marco: desde el byte 32 hasta el 39. El 40 ya no es dename.
Sin el sanitizer, nadie avisa
Sin -fsanitize, ninguna revisión corre, y escribir fuera del arreglo es comportamiento
indefinido: puede pasar cualquier cosa, y puede no notarse. Lo que sigue es lo que salió en
esta corrida, en este entorno. No se puede esperar lo mismo en otra máquina ni con otro
compilador:
$ gcc -Wall -Wextra -std=c17 errors/overflow_scanf.c -o build/overflow_plain
$ echo Alejandra | build/overflow_plain
Hola, Alejandra
Parece funcionar, y eso es lo peor que puede pasar. Los bytes de más cayeron en memoria que
no era de name, y el programa no se enteró.
Por qué es un problema de seguridad
¿Qué había en esa memoria? Depende. Pero si lo pisado es algo importante, quien escribe la
entrada controla qué se guarda ahí. Este programa, errors/overflow_neighbor.c, tiene una
variable que decide los permisos, y nunca le asigna otra cosa que 0:
int is_admin = 0;
char name[8];
Otra vez, esto es una corrida en este entorno. El lenguaje no dice dónde se guarda cada variable, y en otra máquina el resultado puede ser otro. Lo que sí es cierto en todas es que el programa está mal:
$ gcc -Wall -Wextra -std=c17 errors/overflow_neighbor.c -o build/overflow_neighbor
$ echo Ana | build/overflow_neighbor
Hola, Ana
Acceso normal
$ echo Alejandra_Quispe | build/overflow_neighbor
Hola, Alejandra_Quispe
Acceso de administrador (is_admin = 1701868393)
Nadie escribió el acceso de administrador en el programa. Lo consiguió un nombre largo.
Y puede ser peor. En la semana 7 dibujamos la pila de llamadas. En muchos sistemas reales, la pila también guarda la dirección a la que debe volver la función cuando termina. Un atacante que logra pisar ese dato con un valor elegido puede desviar el programa a donde quiera. Así un error de programación se convierte en una forma de tomar control de un programa, o de la computadora donde corre.
No es un ejemplo de curso. El gusano Morris de 1988, un programa que se copiaba solo de una
computadora a otra y uno de los primeros que se extendió por internet, usaba justamente un buffer overflow en un programa de red que leía con gets. Hoy los
sistemas agregan defensas que dificultan estos ataques, pero no reparan el programa, y estos
errores siguen apareciendo.
Idea clave. Un buffer overflow no es solo un programa que falla. Es un programa en el que la entrada puede cambiar datos que nadie le dio permiso de cambiar. Toda escritura en un buffer debe tener un límite, y ese límite debe venir del tamaño real del buffer.
Corregirlo
La corrección es elegir una lectura con límite. Ahora el mismo nombre no hace overflow, y lo que no cabe se queda afuera:
$ printf 'Maria de los Angeles Quispe\nLima\n' | build/read_name
Nombre: Maria de los Angele
Ciudad: Lima
Noten que cambiar scanf("%s") por fgets también cambia el significado: antes se leía una
palabra, y ahora una línea completa. A veces es lo que se quería. Si lo que se quiere es una
palabra, la corrección es scanf("%7s", name) para un name de 8 bytes.
Escribir nuestra propia función segura
Lo mismo vale para nuestras funciones. Una función que puede alargar una cadena no puede usar
sizeof para saber cuánto espacio tiene, como ya vimos. Por eso recibe el tamaño. Esta
función copia una cadena sin pasarse:
algoritmo copiar_texto(destino, origen, tamano)
    i ← 0
    mientras origen[i] ≠ NULO y i < tamano - 1 hacer
        destino[i] ← origen[i]
        i ← i + 1
    fin mientras
    destino[i] ← NULO
fin algoritmo
void copy_text(char dest[], const char src[], int size) {
int i = 0;
while (src[i] != '\0' && i < size - 1) {
dest[i] = src[i];
i++;
}
dest[i] = '\0';
}El const muestra quién se lee y quién se escribe. El límite es size - 1, para que siempre
quede lugar para el '\0' final. Sigamos la copia de "estrella" en un arreglo de 5 bytes:
i |
src[i] |
¿i < 4? |
Qué hace | dest hasta ahora |
|---|---|---|---|---|
| 0 | e |
sí | copia | e |
| 1 | s |
sí | copia | es |
| 2 | t |
sí | copia | est |
| 3 | r |
sí | copia | estr |
| 4 | e |
no | sale, y dest[4] = '\0' |
estr con \0 |
$ build/copy_text
sol
luna
estr
"luna" cabe justo: 4 letras y el '\0', 5 bytes. Es el borde que hay que probar. La próxima
semana verán funciones parecidas en string.h.
El laboratorio, paso a paso
El laboratorio tiene dos archivos, que están en
code/week-10/lab. En cada uno, los comentarios
dicen exactamente qué debe hacer cada función o programa. make test-lab los comprueba: falla
hasta que terminen. Aquí están las ideas, no todo el código.
my_strlen, my_strcmp y to_upper
Se escriben en my_strings.c, sin incluir string.h. my_strlen ya la conocen.
my_strcmp compara dos cadenas y dice cuál va antes. Solo importa el signo de lo que devuelve:
negativo si a va antes, 0 si son iguales, positivo si a va después. La idea en
pseudocódigo:
algoritmo comparar(a, b)
    i ← 0
    mientras a[i] ≠ NULO y a[i] = b[i] hacer
        i ← i + 1
    fin mientras
    devolver a[i] - b[i]
fin algoritmo
El ciclo avanza mientras los bytes coincidan. Termina en la primera diferencia o cuando a
se acaba. ¿Hace falta preguntar también si b se acabó? Piénsenlo: si b[i] es '\0' y a[i]
no lo es, ya son distintos. Sigan a mano estos casos:
a |
b |
Primera diferencia | Signo |
|---|---|---|---|
"ana" |
"ana" |
ninguna, los dos llegan a \0 |
0 |
"ana" |
"ano" |
índice 2: a y o |
negativo |
"an" |
"ana" |
índice 2: \0 y a |
negativo |
Falta un detalle al pasar a C. Un byte de la ñ puede verse negativo en una máquina y positivo
en otra, porque char a secas puede tener signo o no. Para que el resultado no dependa de la
máquina, resten los bytes como unsigned char, con un cast, igual que en la semana 3:
(unsigned char) a[i]. Las pruebas lo comprueban: "z" debe ir antes que "ñ", porque el
byte 7a es menor que c3.
Este orden es por códigos, no el de un diccionario: "Z" va antes que "a", porque las
mayúsculas tienen códigos menores.
to_upper cambia la cadena en el mismo arreglo, y por eso su parámetro no lleva const.
Recorran hasta el '\0'. Si el byte está entre 'a' y 'z', réstenle 'a' - 'A'. Los demás
bytes se quedan igual, así que "año" queda como AñO. La ñ no cambia. Es lo que dijimos
sobre ASCII.
is_palindrome: decidir qué significa “igual”
Un palíndromo se lee igual en los dos sentidos. Usen dos índices, uno en cada extremo, que avanzan hacia el centro:
algoritmo es_palindromo(s)
    izquierda ← 0
    derecha ← longitud(s) - 1
    mientras izquierda < derecha hacer
        si s[izquierda] ≠ s[derecha] entonces
            devolver 0
        fin si
        izquierda ← izquierda + 1
        derecha ← derecha - 1
    fin mientras
    devolver 1
fin algoritmo
Antes de programar hay que tomar una decisión: ¿Ana es un palíndromo? ¿Y Anita lava la tina?
La respuesta depende de qué consideremos igual, y esa decisión la toma quien programa.
Las dos definiciones sirven, para usos distintos. Por eso el laboratorio pide dos funciones:
| Función | Regla | Ana |
Anita lava la tina |
|---|---|---|---|
is_palindrome |
byte por byte, sin excepciones | no | no |
is_palindrome_text |
ignora espacios y mayúsculas de la a a la z |
sí | sí |
Para la segunda, cuando un índice esté en un espacio, muevan solo ese índice y vuelvan a
preguntar. Comparen las letras después de pasar las dos a minúscula. El parámetro lleva const,
así que no pueden cambiar s. Prueben los bordes: la cadena vacía y una cadena de solo espacios
son palíndromos.
Hay una consecuencia que conviene mirar. "aña" parece un palíndromo, pero is_palindrome
responde que no. En bytes es 61 c3 b1 61: al ir hacia el centro compara c3 con b1, y son
distintos. Es otra forma de ver que un char es un byte, no una letra. Las pruebas exigen ese
resultado, y en un comentario pueden escribir qué harían para resolverlo.
Provocar un buffer overflow y corregirlo
greet.c viene con un buffer de 8 bytes y un scanf("%s", name). Igual que los programas de
errors/, tiene %s sin límite a propósito:
- Compílenlo con
make build/lab/greet, córranlo conbuild/lab/greety escriban un nombre de más de 7 letras.makeusa-g -fsanitize=address,undefined. - Lean el informe con los cuatro pasos de arriba: qué pasó, qué operación, en qué línea suya, qué variable.
- Compílenlo a mano sin
-fsanitize, congcc -Wall -Wextra -std=c17 lab/greet.c -o build/greet, y prueben el mismo nombre. Comparen. - Corríjanlo con
fgets, como pide el comentario del archivo. Quiten el\n, recorriendo la cadena a mano. Un nombre con espacio,Ana Li, debe salir completo. Un nombre largo debe salir cortado y sin ningún informe.
Resumen
- Al pasar un arreglo a una función, lo que se copia es la dirección donde empieza. C sigue
pasando por valor, pero esa dirección lleva a los elementos originales. Por eso la función puede
cambiarlos, y no puede cambiar un
intrecibido. - Una dirección no dice cuántos elementos hay.
sizeofde un parámetro arreglo da el tamaño de una dirección, ygccavisa. La longitud se pasa en otro parámetro. consten un parámetro promete que la función solo lee el arreglo, y el compilador lo exige.- Un vector es un arreglo con capacidad fija y una longitud
n. Insertar mueve a la derecha desde el último; eliminar mueve a la izquierda desde el primero. La función devuelve la nuevan. - Una cadena es un arreglo de
charterminado en'\0'.char s[] = "hola"ocupa 5 bytes. Sin'\0'no es una cadena. Un literal de cadena no se debe cambiar. - Una cadena se recorre hasta el
'\0':for (int i = 0; s[i] != '\0'; i++). - La longitud de una cadena cuenta bytes, sin el
'\0':"año"da 4. Conchar, comparar con'a'y'z'solo sirve para letras ASCII. - Con
scanf,%19spara 20 bytes, y se detiene en el primer espacio. Confgets, se pasa el tamaño; conserva el\nsi cabe, y devuelveNULLal final de la entrada. - Un buffer overflow escribe fuera del espacio reservado. Es comportamiento indefinido, puede
no notarse, y la entrada puede cambiar datos que no debía.
-fsanitize=addresssuele detectarlo al correr, si la ejecución pasa por ahí;-gda los números de línea. Toda escritura en un buffer lleva un límite.
Ejercicios
-
Dibujen en memoria
char s[8] = "hola";, con índices y contenido. ¿Cuánto valemy_strlen(s)? ¿Ysizeof(s)? Comprueben constring_bytes.cymy_strlen.c. -
¿Qué escribe este programa? Primero respondan a mano, y después compruébenlo.
void f(int x, int a[]) { x = 0; a[0] = x; } int b = 5; int v[2] = {1, 2}; f(b, v); printf("%d %d %d\n", b, v[0], v[1]); -
¿Cuáles de estas funciones deberían llevar
consten su parámetro arreglo, y cuáles no pueden llevarlo?sum,add_bonus,insert_at,my_strlen,to_upper. Expliquen cada una. -
Escriban
count_passing(const int grades[], int n), que devuelva cuántas notas son 11 o más. Pruébenla conassert: con 14, 9, 17, 11 y 20 da 4, y connigual a 0 da 0. -
Con
vigual a 3, 7 y 9,nigual a 3 y una capacidad de 5, sigan a mano en una tablainsert_at(v, n, 5, 0, 1). ¿Cuál es el vector al final? ¿Qué devuelve y qué le pasa avsi en lugar de eso se llama conposigual a 4? -
¿Qué mostrará
read_line.ccon la entradaprintf 'Hola mundo\n'? Escríbanlo a mano y después córranlo. ¿Cuántas veces devuelvefgetsalgo que no esNULL? -
Quieren leer con
fgetsuna línea cuyo texto llega a tener 30 bytes, sin perder el\n. ¿De qué tamaño debe ser el buffer? Y parachar w[50], ¿qué formato descanflee una palabra sin hacer overflow? -
Sigan a mano
copy_textcon"luna"en un arreglo de 3 bytes. ¿Qué queda endest? ¿Por qué el límite del ciclo essize - 1y nosize? -
Escriban
count_char(const char s[], char c), que cuente cuántas veces aparece el bytecens. Pruébenla conassert: en"banana"hay 3'a', y en""hay 0. -
Este programa tiene dos errores. Encuéntrenlos, expliquen qué puede pasar y corríjanlo.
char city[4] = "Lima"; char other[4]; printf("%s\n", city); if (scanf("%s", other) != 1) { return 1; } -
Escriban
reverse(char s[]), que invierta una cadena en el mismo arreglo, con dos índices. Pruébenla con"hola", con""y con"ab". Después llamen areversecon un arreglo que tenga"año"e impriman los bytes con%xy un cast aunsigned char. ¿Qué bytes quedaron, y por qué ese texto ya no es UTF-8 válido? -
Escriban
count_letters(const char s[]), que cuente los caracteres de un texto en UTF-8 y no sus bytes. Pista: en la semana 3 vieron que los bytes que siguen al primero empiezan con los bits10, o sea, los que comounsigned charestán entre 128 y 191. Deben contar todos los demás. Pruébenla:"año"da 3,"ñandú"da 5 y""da 0.