Apuntes · Capítulo 9Memoria y datos
Dentro de la computadora: direcciones y arreglos
Dentro de la computadora: direcciones y arreglos
En la primera parte del curso aprendieron a escribir programas: variables, decisiones, ciclos y funciones. Durante todo ese tiempo hablamos de “la memoria” y de “la CPU” sin abrir la caja. Hoy la abrimos. ¿Qué piezas ejecutan un programa? ¿Qué pasa, paso a paso, cuando la CPU hace una suma? ¿Por qué hay tantas memorias distintas? ¿Y qué hace el sistema operativo mientras tanto?
Esa mirada nos lleva a la herramienta de programación de esta semana. Si la memoria es una fila de bytes numerados, se pueden guardar muchos datos del mismo tipo uno al lado del otro y llegar a cualquiera de ellos con una cuenta. Eso es un arreglo (array). Con arreglos, un programa puede guardar cien notas y volver a mirarlas, algo que no se podía hacer con las variables sueltas que hemos usado hasta ahora.
En C, los arreglos tienen un peligro: nadie revisa que el índice esté dentro del arreglo.
Veremos qué significa eso y cómo detectarlo. Pasar arreglos a funciones queda para la
próxima semana. Hoy usamos los arreglos solo dentro de main.
Lectura. El código de este capítulo está en
code/week-09. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. Los programas deerrors/tienen errores a propósito y se compilan a mano, como se muestra en cada caso.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Las piezas de una computadora” y “El ciclo de instrucción”. Es lo mínimo para seguir la clase.
- En clase: “La jerarquía de memoria”, “Qué hace el sistema operativo”, “La memoria es una fila de bytes numerados”, “Arreglos”, “Cómo se guarda un arreglo en memoria”, “Patrones para recorrer un arreglo” y “Salirse del arreglo”.
- Después de clase: para el laboratorio, “El laboratorio, paso a paso”; para repasar, “Resumen” y “Ejercicios”.
Las piezas de una computadora
Tres piezas bastan para entender casi todo lo que sigue.
| Pieza | Qué hace | ¿Conserva los datos al apagar? |
|---|---|---|
| CPU | Ejecuta instrucciones, una tras otra | No |
| RAM | Guarda los programas que están corriendo y sus datos | No |
| Almacenamiento (SSD o disco duro) | Guarda archivos a largo plazo | Sí |
Piensen en una persona que estudia en una biblioteca. Ella es la CPU: es quien hace el trabajo. Su mesa es la RAM: tiene a la mano lo que está usando, y no le cabe todo. Los estantes son el almacenamiento: guardan muchísimo, pero ir hasta ellos toma tiempo.
Esta comparación explica lo que pasa cuando abren un programa. El ejecutable está en el almacenamiento, como un archivo. Para correrlo, se copia a la RAM, y ahí la CPU va leyendo sus instrucciones. Por eso, si se apaga la computadora sin guardar, se pierde lo que estaba en la RAM, y lo que estaba en un archivo sigue ahí.
Dentro de la CPU
La CPU no solo calcula: también tiene una memoria mínima propia. Sus partes principales son:
- Registros (registers): unas pocas casillas de memoria dentro de la CPU, las más rápidas que existen. La CPU casi siempre calcula con valores que están en registros.
- Unidad aritmética y lógica: el circuito que suma, resta y compara. Está hecha de compuertas, como el sumador de la semana 4.
- Contador de programa (program counter): un registro especial que guarda la dirección de la siguiente instrucción.
El ciclo de instrucción
Recuerden de la semana 1: la CPU solo ejecuta código máquina, instrucciones muy simples guardadas como números en la memoria. Para ejecutarlas, repite tres pasos:
- Buscar (fetch). Lee de la memoria la instrucción que indica el contador de programa, y el contador avanza a la siguiente.
- Decodificar (decode). Mira los bits de la instrucción para saber qué pide: qué operación y con qué datos.
- Ejecutar (execute). Hace la operación. El resultado queda en un registro o en la memoria.
Y vuelve a empezar. En una computadora actual, esto ocurre miles de millones de veces por segundo.
Idea clave. La CPU no entiende el programa completo. Solo sabe hacer una cosa muy simple, y la repite: buscar la siguiente instrucción, ver qué pide y hacerlo.
Una suma, paso a paso
Miremos una suma real. El programa add_two.c tiene estas líneas:
int a = 2;
int b = 3;
int c = a + b;
En la semana 1 vieron que gcc -S se detiene en el ensamblador. La opción -O0 le pide
no optimizar. Sin ella podría calcular el 5 al compilar y hacer desaparecer la suma, y
queremos verla.
$ gcc -S -O0 add_two.c -o build/add_two.sEstas son las líneas de build/add_two.s que corresponden a int c = a + b;, tal como
salieron en la máquina donde preparamos estos apuntes. Son de un procesador ARM. En una
máquina x86-64, como la de GitHub Codespaces, las instrucciones se ven distintas, pero la
idea es la misma.
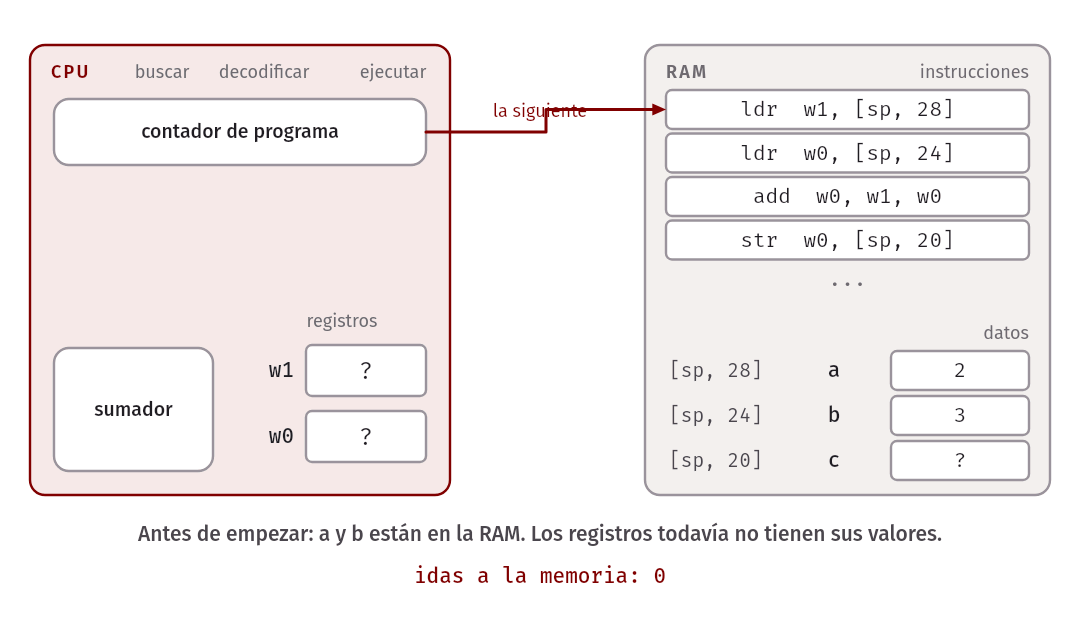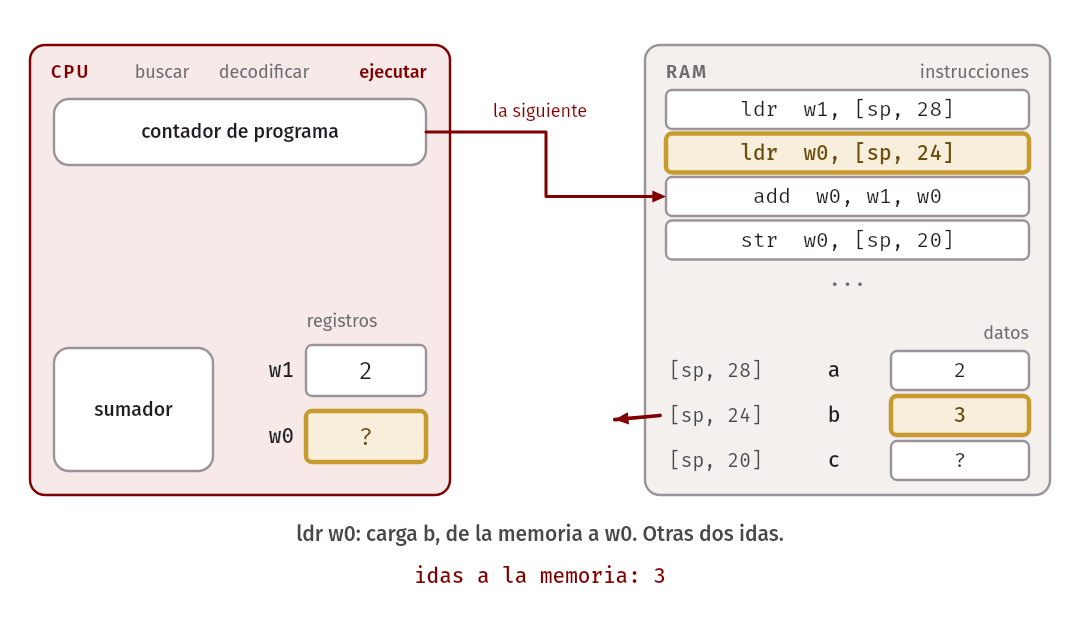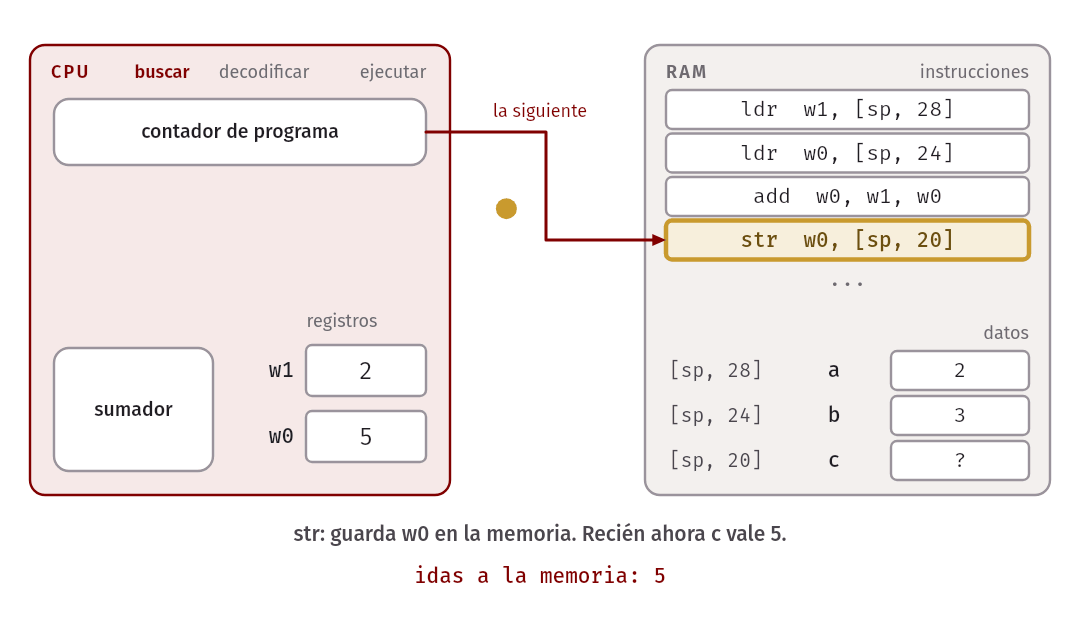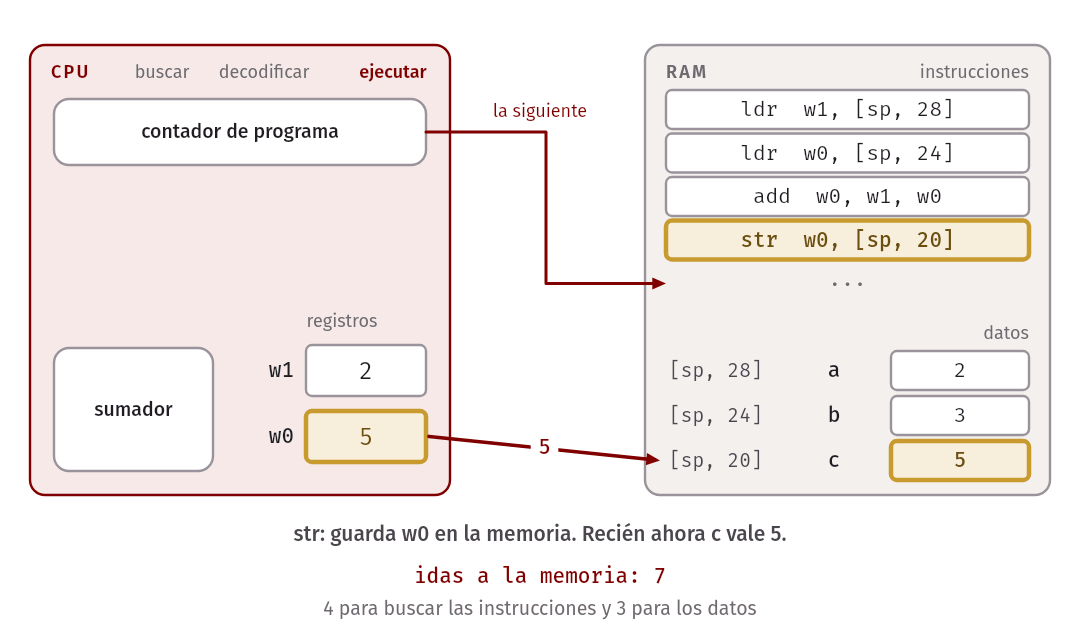
ldr	w1, [sp, 28]
ldr	w0, [sp, 24]
add	w0, w1, w0
str	w0, [sp, 20]
Una línea de C se volvió cuatro instrucciones. w0 y w1 son registros. [sp, 28] es un
lugar de la memoria: el valor del registro sp más 28 bytes. Ahí el compilador decidió
guardar a, y en [sp, 24] y [sp, 20] guardó b y c. Fíjense en esa forma de llegar a
un dato: una dirección base más una distancia. Volverá a aparecer con los arreglos.
| Instrucción | Qué pide | w1 |
w0 |
c en memoria |
|---|---|---|---|---|
ldr w1, [sp, 28] |
Cargar a de la memoria a w1 |
2 | ? | ? |
ldr w0, [sp, 24] |
Cargar b de la memoria a w0 |
2 | 3 | ? |
add w0, w1, w0 |
Sumar w1 y w0, y dejar el resultado en w0 |
2 | 5 | ? |
str w0, [sp, 20] |
Guardar w0 en la memoria, en c |
2 | 5 | 5 |
Cada fila es una vuelta completa del ciclo. Veamos la tercera por dentro:
| Paso | Qué ocurre | Qué cambia |
|---|---|---|
| Buscar | La CPU lee de la RAM la instrucción add |
El contador de programa pasa a str |
| Decodificar | Los bits dicen: suma, con w1 y w0, resultado en w0 |
Nada que se vea desde el programa |
| Ejecutar | El sumador calcula 2 + 3 | w0 pasa de 3 a 5 |
Noten que la suma, por sí sola, no cambia c. La RAM se actualiza recién con la cuarta
instrucción. Y para esa sola línea de C se fue a la memoria 7 veces: 4 para buscar las
instrucciones y 3 para los datos. Esa es la razón de lo que viene en la siguiente sección.
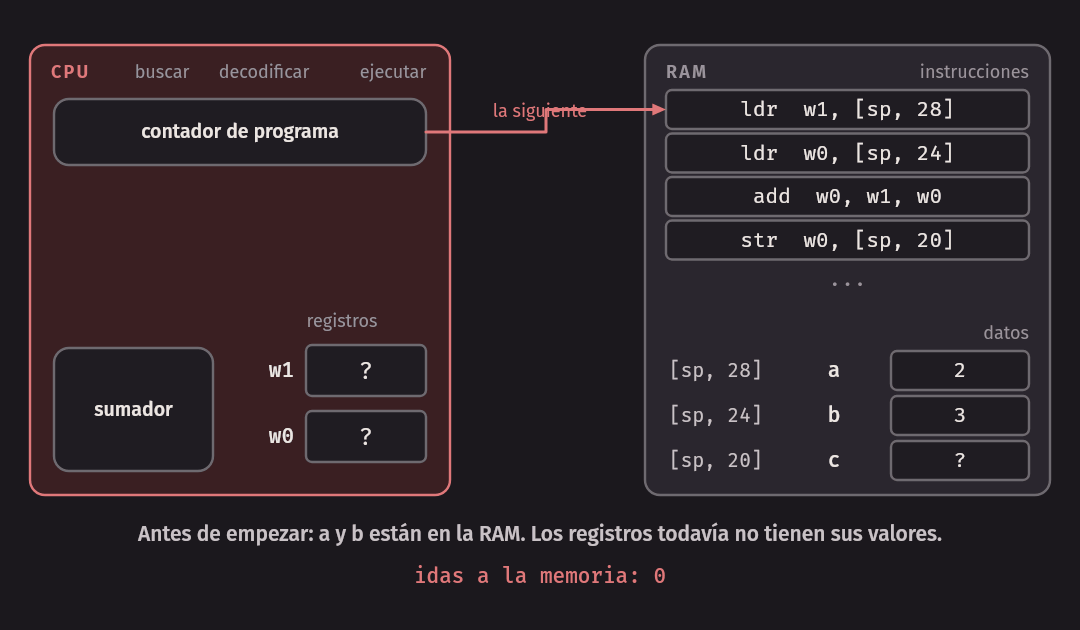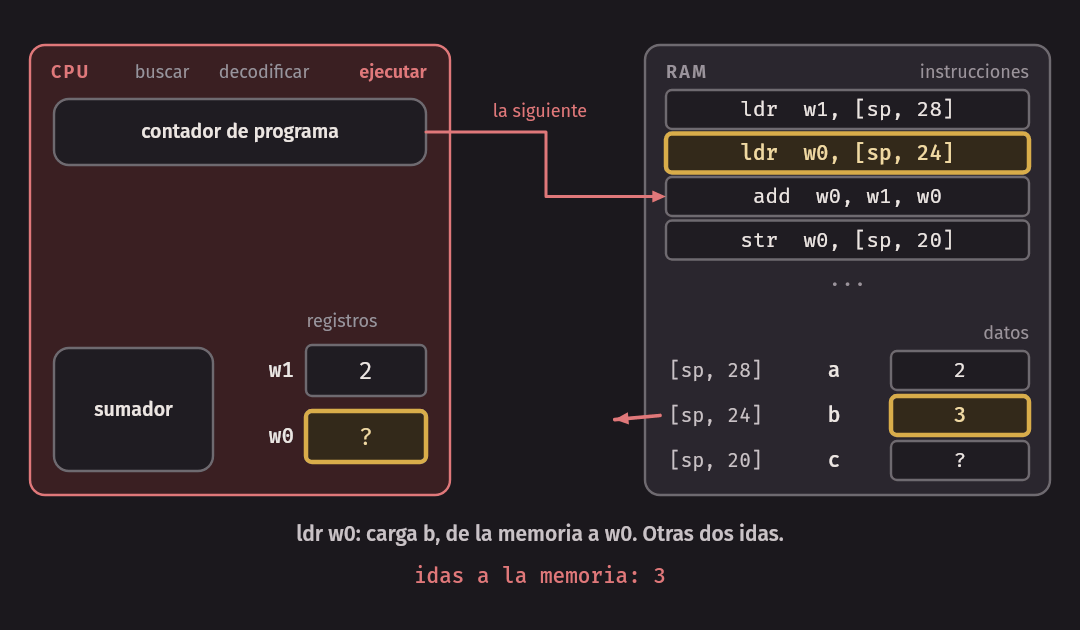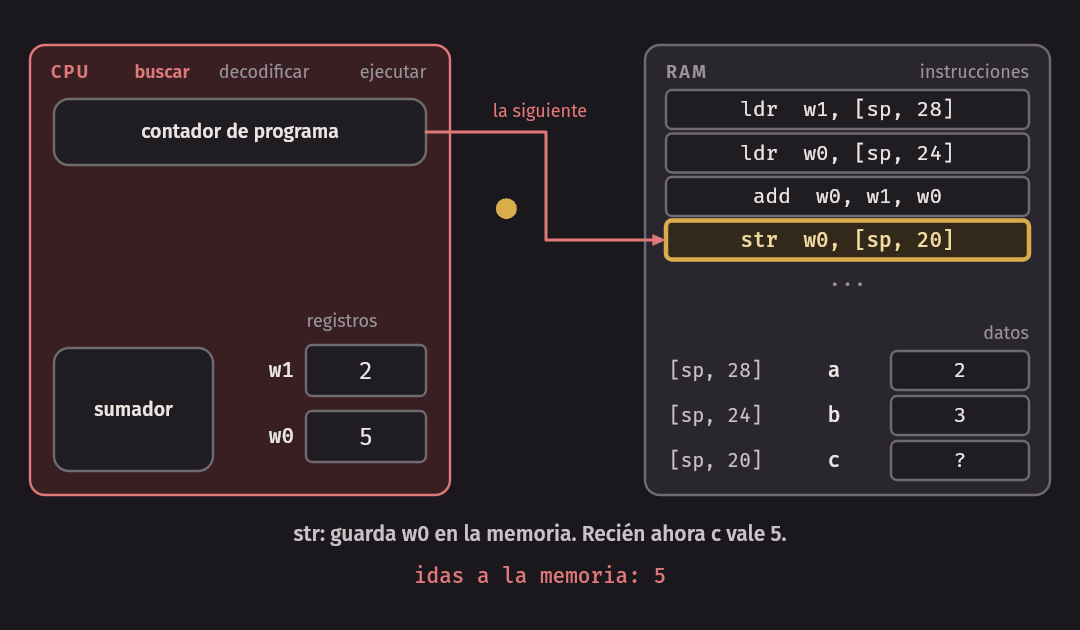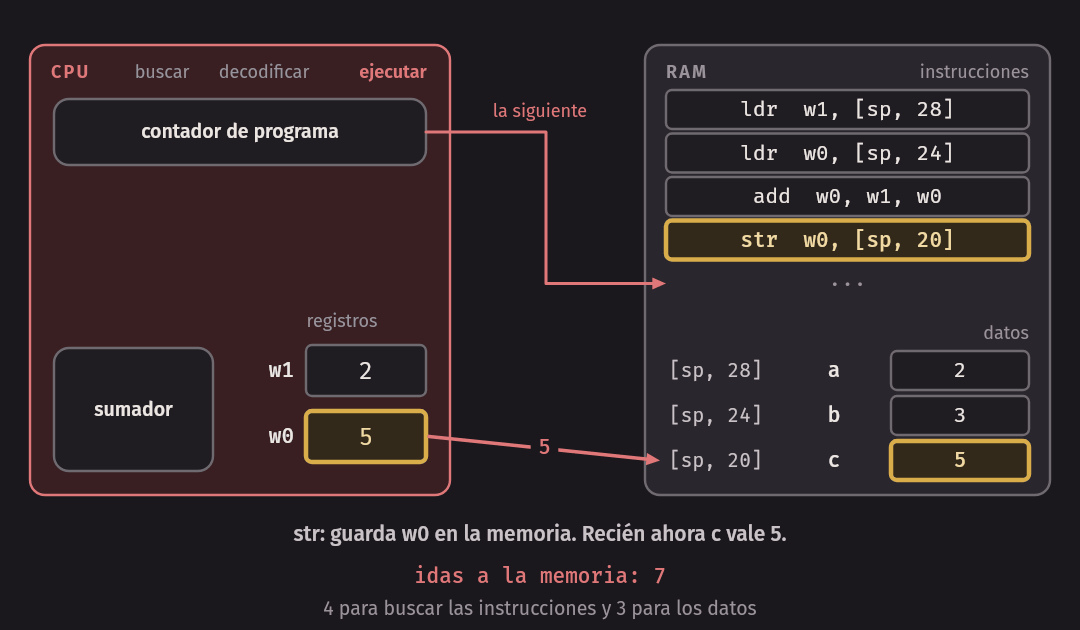
El ciclo de tres pasos es un modelo: describe lo que cada instrucción tiene que lograr. Las CPU modernas hacen mucho más a la vez, como adelantar varias instrucciones al mismo tiempo, pero el resultado de un programa como estos es el mismo que si las ejecutaran de una en una.
La jerarquía de memoria
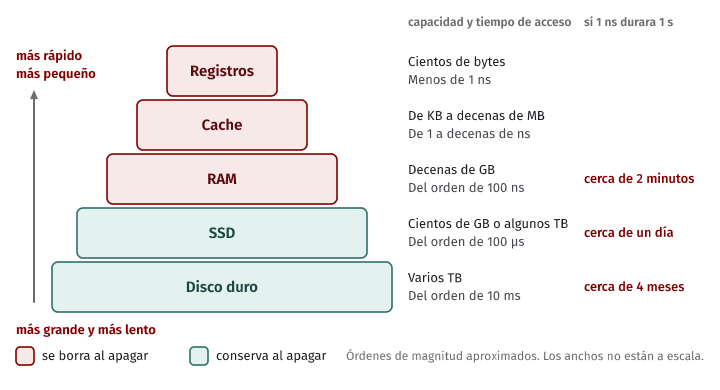
Lo ideal sería una memoria enorme, rápida, barata y que no se borre. No existe. Lo rápido es caro y pequeño, y lo grande es lento. La solución es usar varios niveles: poca memoria muy rápida cerca de la CPU, y mucha memoria lenta más lejos. A esto se le llama jerarquía de memoria.
La siguiente tabla da órdenes de magnitud aproximados. No son medidas: varían mucho de una máquina a otra. Lo que importa es la distancia entre los niveles. Un nanosegundo (ns) es la milésima parte de un microsegundo (µs), y un microsegundo es la milésima parte de un milisegundo (ms).
| Nivel | Capacidad (aproximada) | Tiempo de un acceso (aproximado) | ¿Conserva al apagar? |
|---|---|---|---|
| Registros | Cientos de bytes | Menos de 1 ns | No |
| Cache | De KB a decenas de MB | De 1 a decenas de ns | No |
| RAM | Decenas de GB | Del orden de 100 ns | No |
| SSD | Cientos de GB o algunos TB | Del orden de 100 µs | Sí |
| Disco duro | Varios TB | Del orden de 10 ms | Sí |
Esos prefijos son difíciles de imaginar. Hagamos una escala: supongamos que 1 ns dura 1 segundo. Entonces un acceso a la RAM tomaría cerca de 2 minutos, uno al SSD cerca de un día, y uno al disco duro cerca de 4 meses.
Para qué sirve la cache
La cache es una memoria pequeña y muy rápida, entre la CPU y la RAM, que guarda copias de lo usado recientemente. Cuando la CPU necesita un dato, primero mira ahí. Si está, es un acierto (hit) y se ahorra el viaje a la RAM. Si no está, es un fallo (miss): hay que traerlo, y queda una copia en la cache para la próxima vez.
Esto funciona porque los programas suelen tener localidad, y de dos tipos:
- Temporal: lo que se usó hace poco probablemente se volverá a usar. Piensen en la
variable
sumdentro de un ciclo, o en las instrucciones del propio ciclo. - Espacial: lo que está cerca de un dato usado probablemente se usará pronto. Por eso, en un fallo no se trae un solo byte, sino un bloque de bytes vecinos.
Un programa corre más rápido cuando sus datos caben en la cache porque casi todos sus accesos son aciertos, y evita la RAM, que es decenas de veces más lenta. La cache la maneja el hardware. El programador no escribe nada especial, pero sí influye con la forma de recorrer los datos. Como veremos hoy, un arreglo guarda sus elementos juntos, así que recorrerlo en orden es un caso muy favorable.
Idea clave. Ningún nivel es rápido y grande a la vez. La jerarquía da casi la velocidad del nivel rápido y casi la capacidad del nivel grande, porque lo que se usa ahora suele ser lo que se usó hace poco, o algo que está cerca.
Qué hace el sistema operativo
El sistema operativo (operating system) es el programa que administra la computadora y atiende a los demás programas. Linux, Windows, macOS y Android son sistemas operativos. Nuestro entorno usa Linux. Hace muchas cosas. Nos importan tres.
Procesos. Un proceso es un programa en ejecución. El ejecutable es el archivo;
el proceso es lo que existe mientras corre. Si corren el mismo ejecutable dos veces a la
vez, hay dos procesos. Suele haber más procesos de los que la CPU puede ejecutar a la vez, así que el sistema
operativo les va dando turnos muy cortos, y parece que todos corren al mismo tiempo. El
comando ps lista procesos. -o pid,comm pide dos columnas: el número del proceso (PID) y
su nombre. Esta es una corrida; ustedes verán otros números:
$ ps -o pid,comm
  PID COMMAND
36383 bash
36389 ps
bash es la shell con la que hablan y ps es el propio comando: también es un proceso.
Memoria. El sistema operativo le da memoria a cada proceso y los mantiene separados. Un programa no puede leer ni dañar la memoria de otro. Por eso las direcciones que ve un programa no son las posiciones físicas de la RAM: cada proceso tiene su propia numeración, y el hardware y el sistema operativo la traducen. Si un programa toca una dirección que no se le dio, el sistema operativo lo detiene. Ese es el segmentation fault que mencionamos en la semana 2.
Archivos. Para el hardware, el almacenamiento es solo una gran cantidad de bloques. La idea de archivos con nombre, carpetas y permisos, la de la semana 1, la pone el sistema operativo.
Los programas le piden estos servicios al sistema operativo. Cuando llaman a printf, esa
función termina pidiéndole que escriba en la terminal. Cuando main hace return 1, ese
número se lo entrega al sistema operativo, y así le llega a la shell para echo $?.
Sin sistema operativo, cada programa tendría que saber manejar por su cuenta la pantalla, el teclado y el disco de cada modelo de computadora, y compartir la CPU y la RAM con los demás de alguna forma, confiando en que ninguno dañe a otro.
La memoria es una fila de bytes numerados
Desde la semana 2 decimos que la memoria es una fila de bytes. Ahora, con precisión: cada byte tiene un número que lo identifica, su dirección de memoria (memory address). Es como la numeración de las casas de una calle.
Una variable de varios bytes ocupa varios números seguidos, y su dirección es la de su
primer byte. Si un int de 4 bytes está en la dirección 1000 (un número inventado, por
simplicidad), ocupa estos bytes:
| Dirección | 1000 | 1001 | 1002 | 1003 | 1004 |
|---|---|---|---|---|---|
| Contenido | age |
age |
age |
age |
otra cosa |
Ver direcciones con & y %p
En la semana 2 usaron & con scanf: &grade es la dirección de grade. También se puede
escribir una dirección con printf. Este es el formato:
printf("age     vale %d, ocupa %zu bytes, está en %p\n",
       age, sizeof(age), (void *) &age);
Hay tres cosas por explicar:
%pescribe una dirección, en nuestro entorno en hexadecimal, con el0xde la semana 3.(void *)es un cast, como el(double)de la semana 2.void *significa “una dirección, sin decir de qué tipo es el dato”.%pespera justamente eso, así que convertimos. Es una regla deprintf:%psiempre va con(void *).%zu, de la semana 2, es el formato del resultado desizeof.
El programa variable_addresses.c lo hace con tres variables. Lo corremos dos veces:
$ build/variable_addresses
age     vale 19, ocupa 4 bytes, está en 0xffff92c00030
average vale 14.5, ocupa 8 bytes, está en 0xffff92c00040
section vale A, ocupa 1 byte, está en 0xffff92c00020
$ build/variable_addresses
age     vale 19, ocupa 4 bytes, está en 0xffff81c00030
average vale 14.5, ocupa 8 bytes, está en 0xffff81c00040
section vale A, ocupa 1 byte, está en 0xffff81c00020
Sus direcciones serán otras, y además cambian entre corridas. Dependen de la máquina, de las opciones de compilación y del sistema operativo, que suele colocar la memoria de cada proceso en un lugar distinto como medida de seguridad. Por eso una dirección no es un dato que un programa pueda dar por conocido.
Error común. Sacar conclusiones de la distancia o del orden entre variables sueltas. C no promete nada sobre dónde quedan
ageyaverageuna respecto de la otra. En esta corrida están separadas por huecos, en parte porque-fsanitize=addressdeja espacio entre ellas para vigilarlas. La única garantía la veremos ahora: los elementos de un arreglo.
Arreglos
Supongan que quieren saber cuántos estudiantes superan el promedio del salón. Para saber el
promedio hay que leer todas las notas. Y solo después se puede comparar cada nota con él.
Con el acumulador de la semana 5 ya no se puede, porque cada nota se pierde al leer la
siguiente. Con una variable por nota, grade1, grade2, …, harían falta cuarenta if, y
no se podrían recorrer con un ciclo.
Un arreglo es una secuencia de elementos del mismo tipo, guardados uno al lado del otro en la memoria, a los que se llega con un número llamado índice (index).
En pseudocódigo, el elemento en la posición i del arreglo a se escribe a[i], y los
índices empiezan en 0. Este algoritmo escribe los n elementos de un arreglo a:
algoritmo escribir_arreglo(a, n)
    para i desde 0 hasta n - 1 hacer
        escribir a[i]
    fin para
fin algoritmo
En C, así se declara y se usa, en first_array.c:
#include <stdio.h>

// Guarda cinco notas en un arreglo, cambia dos y las escribe.
int main(void) {
    int grades[5] = {14, 9, 17, 11, 20};

    grades[1] = 12;
    grades[4] = grades[4] - 1;

    for (int i = 0; i < 5; i++) {
        printf("grades[%d] = %d\n", i, grades[i]);
    }
    return 0;
}
La línea int grades[5] = {14, 9, 17, 11, 20}; dice: un arreglo de 5 int, con esos valores
iniciales. Cada grades[i] es una variable int normal: se puede leer, asignar y usar en una
expresión. Y el índice puede ser cualquier expresión entera, como la variable i. Esa es la
gracia del arreglo: un ciclo lo puede recorrer.
Recuerden de la semana 5: i++ suma 1 a i, e int i dentro del for crea una variable
que solo existe en ese ciclo.
Índice i |
0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| Al inicio | 14 | 9 | 17 | 11 | 20 |
Después de grades[1] = 12; |
14 | 12 | 17 | 11 | 20 |
Después de grades[4] = grades[4] - 1; |
14 | 12 | 17 | 11 | 19 |
$ build/first_array
grades[0] = 14
grades[1] = 12
grades[2] = 17
grades[3] = 11
grades[4] = 19
Fíjense en dos cosas. Un arreglo de 5 elementos tiene los índices del 0 al 4: grades[5]
no existe. Y en la condición del for, el hasta n - 1 del pseudocódigo se convierte en
i < n.
En C. Los corchetes tienen dos usos. En una declaración,
int grades[5], el 5 es el tamaño. En una expresión,grades[4], el 4 es un índice.
Inicializar y dar nombre al tamaño
Un arreglo sin inicializar, como int copy[4];, contiene lo que haya quedado en esa parte de
la memoria, igual que una variable sin valor inicial (semana 2). Leer esos elementos antes de
asignarlos es un error. Estas son las formas de inicializar uno, en array_init.c:
int full[SIZE] = {3, 1, 4, 1, 5};
int partial[SIZE] = {7, 8};
int zeros[SIZE] = {0};
int counted[] = {10, 20, 30};fullda todos los valores.partialda menos valores que el tamaño: los que faltan quedan en 0.zerosaprovecha esa regla para poner todo en 0.countedno dice su tamaño. El compilador lo cuenta: son 3 elementos.
SIZE no es una variable. Es un nombre definido al inicio del archivo con #define:
#define SIZE 5Como vieron en la semana 1, el preprocesador atiende las líneas con #. Con #define
reemplaza SIZE por 5 en todo el archivo, antes de compilar. No lleva = ni ;, y por
costumbre se escribe en mayúsculas. Usarlo tiene una ventaja clara: para cambiar el tamaño
se cambia una sola línea, y el arreglo y todos los ciclos quedan de acuerdo.
sizeof con arreglos
sizeof aplicado a un arreglo declarado en esa misma función da el tamaño de todo el
arreglo, en bytes. Si se divide entre el tamaño de un elemento, da la cantidad de
elementos:
printf("sizeof(full)    = %zu\n", sizeof(full));
printf("sizeof(full[0]) = %zu\n", sizeof(full[0]));
printf("elementos de full    = %zu\n", sizeof(full) / sizeof(full[0]));
printf("elementos de counted = %zu\n", sizeof(counted) / sizeof(counted[0]));
$ build/array_init
i = 0: full 3, partial 7, zeros 0
i = 1: full 1, partial 8, zeros 0
i = 2: full 4, partial 0, zeros 0
i = 3: full 1, partial 0, zeros 0
i = 4: full 5, partial 0, zeros 0
sizeof(full) = 20
sizeof(full[0]) = 4
elementos de full = 5
elementos de counted = 3El 20 y el 4 valen en nuestro entorno, donde un int ocupa 4 bytes. C no fija ese
tamaño. La división, en cambio, da 5 en cualquier máquina. La semana que viene verán que este
truco deja de funcionar cuando el arreglo se pasa a una función.
Lo que no se puede hacer con un arreglo entero
Un arreglo no se comporta como una variable int. No se puede asignar con =. El programa
errors/assign_array.c intenta copy = original;:
$ gcc -Wall -Wextra -std=c17 errors/assign_array.c -o build/assign_array
errors/assign_array.c: In function ‘main’:
errors/assign_array.c:8:10: error: assignment to expression with array type
    8 |     copy = original;
      |          ^
Se copia elemento por elemento, con un ciclo, como en copy_array.c:
for (int i = 0; i < SIZE; i++) {
    copy[i] = original[i];
}
$ build/copy_array
original[0] = 5, copy[0] = 99Y == tampoco compara los contenidos. En errors/compare_arrays.c, dos arreglos con los
mismos valores salen “distintos”. gcc avisa, y su nota da la pista de lo que hace esa
comparación: pregunta si están en el mismo lugar, no si guardan lo mismo. Para
comparar contenidos, también hace falta un ciclo.
$ gcc -Wall -Wextra -std=c17 errors/compare_arrays.c -o build/compare_arrays
errors/compare_arrays.c: In function ‘main’:
errors/compare_arrays.c:8:15: warning: comparison between two arrays [-Warray-compare]
    8 |     if (first == second) {
      |               ^~
errors/compare_arrays.c:8:15: note: use ‘&first[0] == &second[0]’ to compare the addresses
$ build/compare_arrays
distintos
Cómo se guarda un arreglo en memoria
Los elementos de un arreglo están seguidos, sin huecos, en orden de índice. Esto sí lo
garantiza C. El programa array_addresses.c lo muestra:
for (int i = 0; i < SIZE; i++) {
    printf("prices[%d] = %4d está en %p\n", i, prices[i], (void *) &prices[i]);
}
%4d escribe el entero con al menos 4 espacios de ancho, rellenando por
la izquierda. Sirve para que las columnas queden alineadas.
$ build/array_addresses
sizeof(int) = 4
prices[0] =  350 está en 0xffffba300020
prices[1] = 1200 está en 0xffffba300024
prices[2] =   80 está en 0xffffba300028
prices[3] =  999 está en 0xffffba30002c
Otra vez, estas direcciones son de esta corrida. Lo que no cambia es el salto: cada
dirección es 4 más que la anterior, porque cada int ocupa 4 bytes en nuestro entorno. En
hexadecimal, 0x28 + 4 da 0x2c, porque c vale 12.
La cuenta de la dirección, y por qué se empieza en 0
Como los elementos van seguidos y todos ocupan lo mismo, la dirección de cualquiera sale de una cuenta:
dirección de a[i] = dirección de a[0] + i × tamaño de un elemento
Así queda la cuenta si un arreglo de int empieza en la dirección 2000 y cada int ocupa 4 bytes:
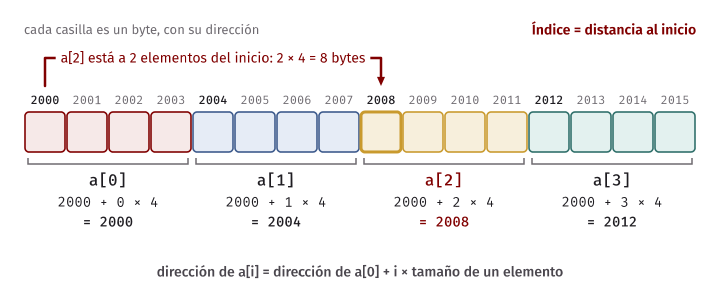
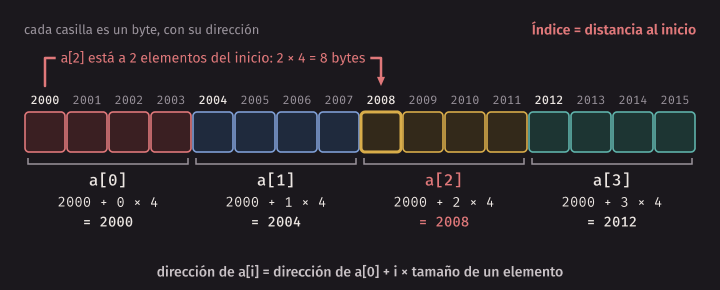
Aquí están las dos ideas de esta sección.
Calcular dónde está un elemento cuesta lo mismo para cualquiera. Para llegar a a[3] o a
a[3000] la CPU no recorre los anteriores: hace una multiplicación y una suma, y va directo.
Es la misma forma de llegar a un dato que vimos en el ensamblador: una base más una distancia.
Lo que tarde después el acceso depende de si el dato está en la cache, y por eso recorrer el
arreglo en orden ayuda.
Por eso los índices empiezan en 0. El índice dice a cuántos elementos de distancia está
del primero. El primero está a distancia 0 de sí mismo. Con índices desde 1, la
cuenta necesitaría un - 1 adicional.
Idea clave. El índice no es “el número del elemento”, sino su distancia al inicio. Para llegar a un elemento basta saber dónde empieza el arreglo y cuánto ocupa cada elemento.
El arreglo no es lo mismo que la dirección de su inicio. Lo acabamos de ver: sizeof(full) da
el tamaño de todo el arreglo. La relación exacta entre arreglos y direcciones la completaremos
la semana que viene, al pasar arreglos a funciones.
Patrones para recorrer un arreglo
Suma, promedio y mayor
Tenemos las temperaturas de una semana en un pueblo de la sierra (datos inventados, para el ejemplo). Queremos la suma, el promedio y la mayor, y además en qué día ocurrió. Por eso guardamos el índice del mayor, y no solo su valor.
algoritmo resumen_temperaturas(t, n)
    suma ← 0
    para i desde 0 hasta n - 1 hacer
        suma ← suma + t[i]
    fin para
    dia_mayor ← 0
    para i desde 1 hasta n - 1 hacer
        si t[i] > t[dia_mayor] entonces
            dia_mayor ← i
        fin si
    fin para
    escribir suma
    escribir suma / n
    escribir t[dia_mayor], dia_mayor
fin algoritmo
En C, en temperatures.c:
int temperatures[DAYS] = {-2, 1, 4, -5, 0, 3, 2};
int sum = 0;

for (int i = 0; i < DAYS; i++) {
    sum = sum + temperatures[i];
}

int max_day = 0;
for (int i = 1; i < DAYS; i++) {
    if (temperatures[i] > temperatures[max_day]) {
        max_day = i;
    }
}
Sigamos el segundo ciclo. max_day empieza en 0, el primer elemento, que por ahora es el
mayor visto. Por eso i puede empezar en 1.
i |
temperatures[i] |
temperatures[max_day] |
¿Mayor? | max_day después |
|---|---|---|---|---|
| 1 | 1 | -2 | sí | 1 |
| 2 | 4 | 1 | sí | 2 |
| 3 | -5 | 4 | no | 2 |
| 4 | 0 | 4 | no | 2 |
| 5 | 3 | 4 | no | 2 |
| 6 | 2 | 4 | no | 2 |
$ build/temperatures
Suma: 3
Promedio: 0.43
Mayor: 4, en el día 2
Error común. Guardar el valor mayor en una variable que empieza en 0 (
int max = 0;), en lugar de empezar con el primer elemento. Con temperaturas todas negativas, el programa diría que la mayor es 0, un valor que ni siquiera está en los datos.
Leer una cantidad variable de datos
El tamaño de un arreglo se fija al escribir el programa. Pero la cantidad de datos puede depender de la entrada. La solución es separar dos ideas:
- La capacidad: cuántos elementos caben. Es una constante,
MAX_VALUES. - La cantidad usada: cuántos hay ahora. Es una variable,
n.
Y hay una regla que no se negocia: antes de leer los datos, se comprueba que n quepa.
El dato n viene de afuera, y puede ser cualquier cosa. Este programa lee n enteros y
los escribe al revés, algo imposible sin guardarlos:
algoritmo escribir_al_reves()
    leer n
    si n < 1 o n > CAPACIDAD entonces
        escribir "n fuera de rango"
    sino
        para i desde 0 hasta n - 1 hacer
            leer a[i]
        fin para
        i ← n - 1
        mientras i ≥ 0 hacer
            escribir a[i]
            i ← i - 1
        fin mientras
    fin si
fin algoritmo
En C, en reverse.c:
#define MAX_VALUES 100

// Lee n enteros y los escribe en orden inverso.
int main(void) {
    int values[MAX_VALUES];
    int n;

    if (scanf("%d", &n) != 1) {
        printf("Entrada inválida\n");
        return 1;
    }
    if (n < 1 || n > MAX_VALUES) {
        printf("n debe estar entre 1 y %d\n", MAX_VALUES);
        return 1;
    }

    for (int i = 0; i < n; i++) {
        if (scanf("%d", &values[i]) != 1) {
            printf("Entrada inválida\n");
            return 1;
        }
    }

    for (int i = n - 1; i >= 0; i--) {
        printf("%d\n", values[i]);
    }
    return 0;
}
&values[i] es la dirección del elemento i, y scanf la necesita como con cualquier
int. i-- resta 1 a i. El ciclo que escribe al revés termina cuando i llega a -1.
$ echo 3 10 20 30 | build/reverse
30
20
10
$ echo 200 | build/reverse; echo $?
n debe estar entre 1 y 100
1
$ echo 3 10 20 | build/reverse; echo $?
Entrada inválida
1
Error común. Declarar
int values[n];connleído.gcclo acepta, pero en C17 es una característica opcional, y unnmuy grande puede hacer caer el programa sin que haya forma de revisarlo antes. En este curso, el tamaño de un arreglo es siempre una constante.
Un arreglo de contadores
El siguiente patrón usa el dato como índice. En una elección de delegado hay 3 candidatos,
y cada voto es un número del 1 al 3. Un 0 marca el final. Queremos un contador por candidato.
No hacen falta tres variables y tres if: basta con un arreglo. El voto v suma 1 en la
posición v - 1, porque los candidatos empiezan en 1 y los índices en 0.
algoritmo contar_votos()
    para i desde 0 hasta 2 hacer
        cuenta[i] ← 0
    fin para
    invalidos ← 0
    leer v
    mientras v ≠ 0 hacer
        si v ≥ 1 y v ≤ 3 entonces
            cuenta[v - 1] ← cuenta[v - 1] + 1
        sino
            invalidos ← invalidos + 1
        fin si
        leer v
    fin mientras
    para i desde 0 hasta 2 hacer
        escribir i + 1, cuenta[i]
    fin para
    escribir invalidos
fin algoritmo
La parte central de votes.c es esta. counts[vote - 1]++ suma 1 a ese elemento.
if (vote >= 1 && vote <= CANDIDATES) {
    counts[vote - 1]++;
} else {
    invalid++;
}
Con los votos 1, 2, 2 y 3, seguidos de un 7 inválido, otro 2 y el 0 final:
vote |
¿Válido? | counts[0] |
counts[1] |
counts[2] |
invalid |
|---|---|---|---|---|---|
| 1 | sí | 1 | 0 | 0 | 0 |
| 2 | sí | 1 | 1 | 0 | 0 |
| 2 | sí | 1 | 2 | 0 | 0 |
| 3 | sí | 1 | 2 | 1 | 0 |
| 7 | no | 1 | 2 | 1 | 1 |
| 2 | sí | 1 | 3 | 1 | 1 |
$ echo 1 2 2 3 7 2 0 | build/votes
Candidato 1: 1
Candidato 2: 3
Candidato 3: 1
Inválidos: 1
Error común. Usar un dato de la entrada como índice sin revisarlo. Sin ese
if, el voto 7 escribiría encounts[6], fuera del arreglo. Todo índice que venga de afuera se revisa.
Salirse del arreglo
En un arreglo de n elementos, los índices válidos son de 0 a n - 1. a[n] está una
posición más allá del final, y leerlo o escribirlo es comportamiento indefinido, igual
que el overflow de la semana 3: C no dice qué pasa. El caso más común es el error de salirse
por uno de la semana 5.
¿Por qué C no lo revisa? Por lo que acabamos de ver: a[i] es una cuenta y un acceso a
esa dirección. El programa no guarda el tamaño del arreglo para compararlo. Revisar cada acceso
costaría tiempo, y C deja esa responsabilidad al programador.
Sin ninguna ayuda
errors/off_by_one.c tiene el error clásico, un <= donde iba un <:
for (int i = 0; i <= SIZE; i++) {
    printf("grades[%d] = %d\n", i, grades[i]);
    sum = sum + grades[i];
}
Sin sanitizer, compila sin un solo aviso y el programa termina sin quejarse. Esto fue lo
que ocurrió en esta corrida. El número de grades[5] no significa nada. Puede ser otro
en su máquina, y C no promete ni que el programa llegue hasta ahí.
$ gcc -Wall -Wextra -std=c17 errors/off_by_one.c -o build/off_by_one
$ build/off_by_one
grades[0] = 14
grades[1] = 9
grades[2] = 17
grades[3] = 11
grades[4] = 20
grades[5] = 65535
Suma: 65606
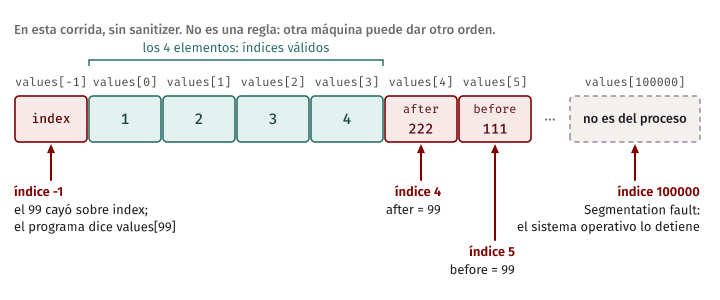
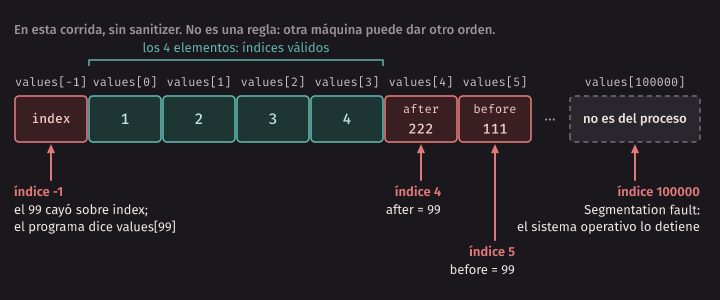
Escribir fuera es peor, porque daña lo que haya en ese lugar. errors/write_out.c lee un
índice y, sin revisarlo, hace values[index] = 99. Tiene otras dos variables, before y
after, que nadie toca en el código. Esta es una corrida, otra vez solo como ejemplo. En otra
máquina, o con otras opciones de compilación, todo puede ser distinto.
$ gcc -Wall -Wextra -std=c17 errors/write_out.c -o build/write_out
$ echo 3 | build/write_out
values[3] = 99
before = 111, after = 222
$ echo 4 | build/write_out
values[4] = 99
before = 111, after = 99
$ echo 5 | build/write_out
values[5] = 99
before = 99, after = 222
$ echo -1 | build/write_out
values[99] = 0
before = 111, after = 222
$ echo 100000 | build/write_out
Segmentation fault
Lean con calma lo que pasó aquí:
- Índice 4 y 5: cambió una variable que el programa nunca asigna, y no hubo ningún error. Este es el caso más peligroso: el programa sigue con un dato dañado, y el síntoma aparece lejos de la causa.
- Índice -1: el 99 cayó encima de la propia variable
index, por eso el programa dicevalues[99]. - Índice 100000: se fue tan lejos que tocó memoria que el proceso no tiene, y el sistema operativo lo detuvo.
No hay que memorizar estos resultados: no son reglas. Son un ejemplo de lo que significa
que el comportamiento sea indefinido. Ni el compilador ni la ejecución dieron un aviso de
error hasta el último caso. Incluso con un índice constante, como values[5] = 99; en un
arreglo de 5 elementos, gcc no dijo nada con estas opciones:
$ gcc -Wall -Wextra -std=c17 errors/fixed_constant.c -o build/fixed_constantCon -fsanitize=address
Desde la semana 1 compilamos con -g -fsanitize=address,undefined. Ahora vemos para qué:
-fsanitize=addressagrega al ejecutable revisiones de los accesos a la memoria. Deja zonas prohibidas alrededor de cada arreglo y, en cada acceso, revisa que no caiga en una de ellas. Es AddressSanitizer, o ASan.-gguarda en el ejecutable el nombre del archivo y los números de línea. Sin él, el informe dice en qué función, pero no en qué línea.
Compilamos solo con esas opciones y corremos. El informe real tiene decenas de líneas con
direcciones, y aquí está recortado; las líneas omitidas se marcan con ...:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address errors/off_by_one.c -o build/off_by_one_asan
$ build/off_by_one_asan
grades[0] = 14
grades[1] = 9
grades[2] = 17
grades[3] = 11
grades[4] = 20
=================================================================
==26852==ERROR: AddressSanitizer: stack-buffer-overflow on address 0xffffa5000034 ...
READ of size 4 at 0xffffa5000034 thread T0
    #0 0xaaaae2270db8 in main errors/off_by_one.c:11
...
    [32, 52) 'grades' (line 7) <== Memory access at offset 52 overflows this variable
...
SUMMARY: AddressSanitizer: stack-buffer-overflow errors/off_by_one.c:11 in main
...
Se lee así, de arriba abajo:
| Parte del informe | Qué dice |
|---|---|
stack-buffer-overflow |
Se accedió fuera de un arreglo local. Un buffer es una zona de memoria para datos, y el stack es la pila de la semana 7 |
READ of size 4 |
Fue una lectura de 4 bytes. Al escribir, dirá WRITE |
in main errors/off_by_one.c:11 |
En qué función, archivo y línea. Aquí vale -g |
'grades' (line 7) <== ... overflows this variable |
Qué arreglo fue, y dónde se declaró |
Noten lo que cambió frente a la corrida anterior. Compilar sigue siendo igual de silencioso:
esto no es un error de compilación, sino un informe que da el programa al correr. Solo aparece
si la ejecución llega al acceso malo, y el programa se detiene ahí. Por eso no se llegó a
imprimir grades[5], y el estado de salida ya no es 0.
Las líneas de grades[0] a grades[4] salen así en una terminal. Si la salida va a otro lado,
por ejemplo a un archivo, pueden perderse: printf guarda el texto un momento antes de
entregarlo, y el programa se detuvo antes de hacerlo. Es normal, y no cambia el informe.
Con las opciones del Makefile, que usan también -fsanitize=undefined, además aparece antes una línea de
UBSan, el sanitizer de la semana 3, que revisa el índice contra el tamaño del arreglo. Aquí
solo mostramos el principio de esa salida, recortada:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address,undefined errors/write_out.c -o build/write_out_both
$ echo 4 | build/write_out_both
errors/write_out.c:17:11: runtime error: index 4 out of bounds for type 'int [4]'
...
ERROR: AddressSanitizer: stack-buffer-overflow ...
WRITE of size 4 ...
...
El sanitizer no ve todo
Las zonas prohibidas de ASan rodean al arreglo. Un índice que se aleja lo suficiente puede saltar esa zona y caer en memoria válida del programa. En esta corrida ASan no dijo nada con el índice 100:
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address errors/write_out.c -o build/write_out_asan
$ echo 100 | build/write_out_asan
values[100] = 99
before = 111, after = 222
Y, como cualquier revisión mientras el programa corre, solo ve lo que se ejecuta. Si el camino con el error no se recorre en sus pruebas, no hay informe. Un programa sin informes no queda demostrado como correcto.
Idea clave. Salirse de un arreglo es comportamiento indefinido, y el programa puede parecer correcto. Compilen siempre con
-fsanitize=address,undefinedmientras desarrollan, prueben los bordes (nigual a 1 y a la capacidad) y revisen todo índice que venga de la entrada.
El laboratorio, paso a paso
El laboratorio tiene cuatro programas. Los archivos de partida están en
code/week-09/lab. En cada uno, el comentario inicial
dice exactamente qué debe escribir el programa. make test-lab los comprueba: falla hasta
que terminen. Aquí están las ideas, no el código. Los arreglos se usan dentro de main.
Direcciones de int y de char
En addresses.c, escriban la dirección de cada elemento de un arreglo de int y de uno de
char, con %p y (void *), como en array_addresses.c. Córranlo dos veces. Las direcciones
cambian, y los saltos no. Calculen el salto en hexadecimal, a mano, y comparen. La prueba
hace esa misma resta: espera un salto de 4 para int, que es su tamaño en nuestro entorno, y
de 1 para char, que vale en cualquier máquina.
N notas
En grades_stats.c se juntan varios patrones de hoy.
- Leer
N, revisar la lectura y revisar que quepa, antes de tocar el arreglo. - Leer las notas en un ciclo, revisando cada
scanfy el rango de cada nota. - Calcular la suma y el mayor.
- Con el promedio ya conocido, recorrer el arreglo otra vez y contar los mayores.
El paso 4 es la razón de usar un arreglo. Cuidado con el promedio: sum / n entre int es una
división entera, y por eso se usa el cast de la semana 2. Prueben con una nota igual al
promedio, que no debe contar: con 3 9 10 11, el promedio es 10.00 y solo el 11 lo supera.
Prueben los bordes: N igual a 1, a 100 y a 101, y el mayor como primer y último elemento.
Un dado y 10 000 lanzamientos
En dice.c, usen el arreglo de contadores de votes.c. Como en la semana 6, rand() % FACES + 1
da una cara entre 1 y 6. Piensen qué índice le corresponde a cada cara. Si usan counts[face]
en un arreglo de 6 elementos, la cara 6 cae fuera, y el sanitizer se los dirá.
Cada cara debería salir cerca de 10000 / 6, unas 1667 veces, pero no exactamente. El programa
lee la semilla para que un resultado se pueda repetir en la misma máquina. Otra implementación
de rand puede dar otros números con la misma semilla. Por eso las pruebas no comparan
números exactos: revisan que las caras sumen 10 000 y que cada una quede cerca de lo esperado.
Salirse a propósito
En out_of_bounds.c, lean un índice y hagan values[i] = 99 sin revisarlo. Compilen las dos
versiones:
$ gcc -Wall -Wextra -std=c17 lab/out_of_bounds.c -o build/oob_plain
$ gcc -Wall -Wextra -std=c17 -g -fsanitize=address lab/out_of_bounds.c -o build/oob_asan
Corran cada una con los índices 4, 5, 6, 20 y 100000, usando echo 5 | build/oob_plain, y anoten
qué pasa. Respondan: ¿con qué índices se queja cada versión? ¿Qué parte del informe dice la
línea del error? Si la versión sin sanitizer parece funcionar con el índice 5, ¿eso significa
que está bien? make test-lab solo comprueba los índices válidos y que el sanitizer detecte
el índice 5.
Resumen
- La CPU ejecuta instrucciones; la RAM guarda lo que está corriendo; el almacenamiento guarda archivos y conserva los datos sin energía.
- El ciclo de instrucción es buscar, decodificar y ejecutar. Es un modelo: las CPU modernas hacen más cosas a la vez.
- La jerarquía de memoria va de lo pequeño y rápido a lo grande y lento: registros, cache, RAM, almacenamiento. La cache funciona gracias a la localidad.
- El sistema operativo administra los procesos, la memoria y los archivos, y los programas le piden servicios.
- La memoria es una fila de bytes numerados.
&xes la dirección dex, y se escribe con%py(void *). Las direcciones cambian entre corridas. - Un arreglo son elementos del mismo tipo, seguidos en memoria.
int a[5]tiene los índices del 0 al 4. El tamaño es una constante, muchas veces con#define. a[i]está en la dirección dea[0]+i× tamaño del elemento. El índice es una distancia, y por eso empieza en 0.sizeof(a)da el tamaño de todo el arreglo en bytes, con%zu. Un arreglo no se asigna ni se compara con=o==: se recorre con un ciclo.- Antes de leer datos, se comprueba que
nquepa. Todo índice que venga de afuera se revisa. - Salirse del arreglo es comportamiento indefinido, también al leer
a[n], y C no avisa.-fsanitize=addresslo detecta al correr en muchos casos, pero no en todos.
Ejercicios
Los arreglos se usan dentro de main. Todo programa revisa su scanf.
-
Instrucciones. Sigan
int c = a - b;en la CPU, cona = 7yb = 3, como en la tabla del capítulo. En ARM, la resta essub w0, w1, w0. Escriban las cuatro instrucciones, qué tiene cada registro después de cada una y cuántas veces se va a la memoria en total. -
Órdenes de magnitud. Un programa hace un millón de accesos a datos. Usando la tabla de la jerarquía, estimen cuánto tarda si todos van a la cache (1 ns), a la RAM, al SSD y al disco duro. Solo buscamos el orden de magnitud.
-
¿Quién lo hace? ¿Cuáles de estas acciones, en un caso normal, requieren pedirle algo al sistema operativo, y cuáles no?
x = a + b;,printf("hola\n");,values[2] = 7;, leer conscanf, abrir un archivo. -
Direcciones a mano. Un arreglo
double d[6]empieza en la dirección 3000, y en este entorno cadadoubleocupa 8 bytes. ¿Dónde estád[4]? ¿Qué elemento está en la dirección 3040? ¿Qué pasa con la dirección 3048? -
sizeof. Antes de correrlo, predigan qué escribesizeofdeint a[10],char b[10],double c[10], ysizeof(c) / sizeof(c[0]). Comprueben con un programa. ¿Cuáles de esos números son iguales en cualquier máquina? -
Seguir a mano. Sin compilar, digan qué escribe este fragmento. Háganlo con una tabla y después comprueben.
int a[4] = {3, 1, 2, 0}; for (int i = 0; i < 4; i++) { a[i] = a[a[i]]; } printf("%d %d %d %d\n", a[0], a[1], a[2], a[3]); -
Encontrar el error. Este fragmento debe sumar los 5 elementos de
a. ¿Qué elemento no suma? ¿Qué elemento no existe? Corríjanlo. Antes de corregirlo, compílenlo con-g -fsanitize=addressy digan en qué línea del informe se ve el problema.int a[5] = {1, 2, 3, 4, 5}; int sum = 0; for (int i = 1; i <= 5; i++) { sum = sum + a[i]; } -
Pares e impares. Lean
n(de 1 a 50) ynenteros. Escriban primero los que están en las posiciones pares del arreglo (0, 2, 4…) y después los de las posiciones impares. Por ejemplo, con5 10 20 30 40 50deben escribir10 30 50 20 40. -
Invertir en el mismo arreglo. Lean
n(de 1 a 50) ynenteros, inviertan el arreglo sin usar otro arreglo, intercambiando elementos, y escríbanlo. Primero el pseudocódigo. ¿Hasta qué índice debe llegar el ciclo? ¿Qué pasa si recorren el arreglo completo? -
Buscar. Lean
n(de 1 a 50),nenteros y un valor. Escriban el índice de la primera vez que aparece el valor, oNo está. Prueben con el valor en la primera posición, en la última y ausente. -
Histograma de notas. Lean notas de 0 a 20 hasta un -1. Con un arreglo de contadores, escriban una línea por cada nota que apareció, con la nota y tantos asteriscos como veces apareció. Las notas fuera de rango se ignoran. ¿De qué tamaño debe ser el arreglo, y por qué? ¿Qué índice le corresponde a la nota?
Con
11 14 11 25 20 11 -1, deben escribir:11 *** 14 * 20 *