Apuntes · Capítulo 6Programación en C
Ciclos anidados y números aleatorios
Ciclos anidados y números aleatorios
La semana pasada aprendimos a repetir con while, do while y for. Un ciclo recorre
una sola línea de cosas: los números del 1 al 10, las notas de un salón, los caracteres de
un archivo. Pero muchos problemas tienen dos dimensiones. Una tabla de multiplicar tiene
filas y columnas. Lanzar dos dados tiene 6 resultados por cada resultado del primero. Para
esos problemas se pone un ciclo dentro de otro.
Este capítulo tiene dos partes que al final se juntan. La primera son los ciclos anidados: cómo se leen, cómo se escriben y cuántas veces corre cada línea. La segunda son los números aleatorios: de dónde salen, por qué no son tan al azar como parecen y cómo se pueden repetir. Con las dos cosas haremos una simulación: estimar la probabilidad de sacar 7 con dos dados, y comprobar con los mismos ciclos cuánto se acerca a la respuesta exacta.
Lectura. El código de este capítulo está en
code/week-06. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí.makecompila con-g, que guarda información para el debugger, y con-fsanitize=address,undefined, que agrega al programa revisiones mientras corre. Los programas deerrors/tienen errores a propósito y se compilan a mano, sin esas dos opciones, como se muestra en cada caso.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Un ciclo dentro de otro” y “La tabla de multiplicar”. Es lo mínimo para seguir la clase.
- En clase: “Cuántas veces corre cada línea”, “Patrones: cada fila depende de su número”, “Números que parecen al azar”, “La semilla”, “Un número en un rango”, “Simular: estimar una probabilidad” y “El error baja con más intentos”.
- Después de clase: para el laboratorio, “El laboratorio, paso a paso”; para repasar, “Resumen” y “Ejercicios”. Opcional: “Un ciclo que cuenta dentro de otro: los divisores”.
Un ciclo dentro de otro
Queremos dibujar un rectángulo de asteriscos de 2 filas y 5 columnas:
*****
*****
Pensémoslo por partes. Dibujar una fila es un ciclo que ya saben escribir: repetir 5 veces “escribir un asterisco” y al final pasar a la línea siguiente. Dibujar el rectángulo es repetir eso una vez por cada fila. Entonces el cuerpo de un ciclo contiene otro ciclo.
algoritmo rectangulo()
    leer filas, columnas
    para fila desde 1 hasta filas hacer
        para columna desde 1 hasta columnas hacer
            escribir "*" sin saltar de línea
        fin para
        saltar de línea
    fin para
fin algoritmo
Se llaman ciclos anidados (nested loops). El de afuera es el ciclo exterior y el de adentro, el ciclo interior. Así se lee: por cada vuelta del exterior, el interior da todas sus vueltas, desde el principio.
Un reloj funciona igual. El minutero da una vuelta completa, de 0 a 59, por cada hora que avanza el horario. Cuando el minutero termina, el horario avanza uno y el minutero vuelve a empezar.
En C, en rectangle.c:
for (int row = 1; row <= rows; row++) {
    for (int col = 1; col <= cols; col++) {
        printf("*");
    }
    printf("\n");
}
Recuerden que row++ suma 1 a row, y que una variable declarada en el for solo existe
dentro de ese ciclo. Fíjense dónde está cada printf. El de "*" está dentro de los dos
ciclos: corre una vez por cada casilla. El de "\n" está dentro del exterior, pero fuera
del interior: corre una vez por fila, cuando la fila ya terminó.
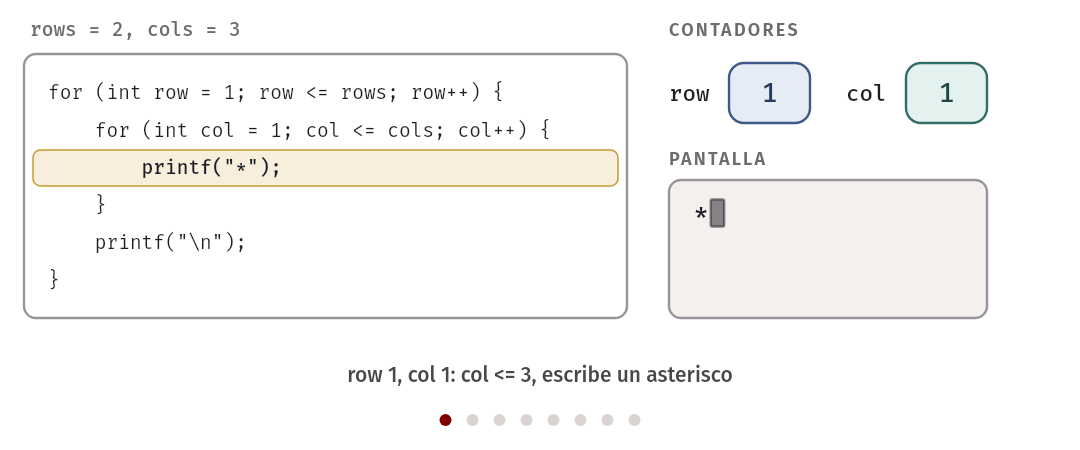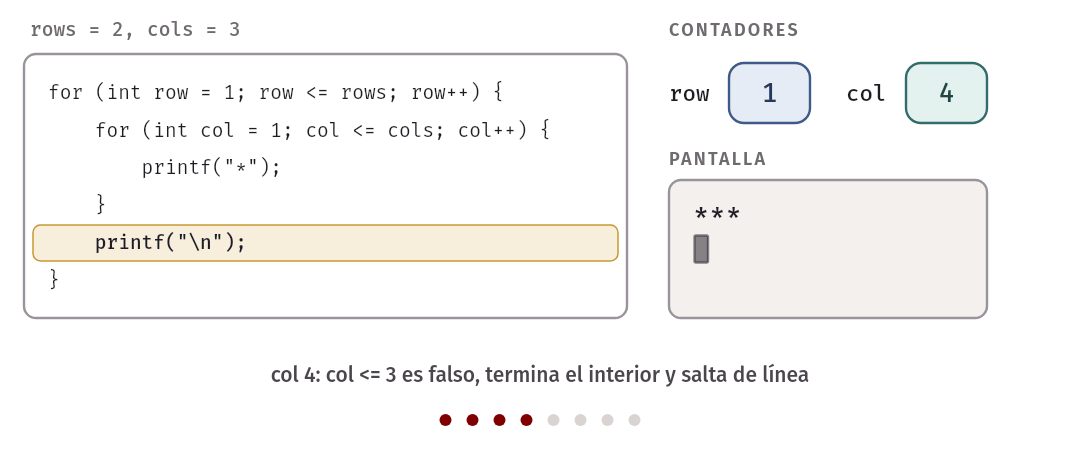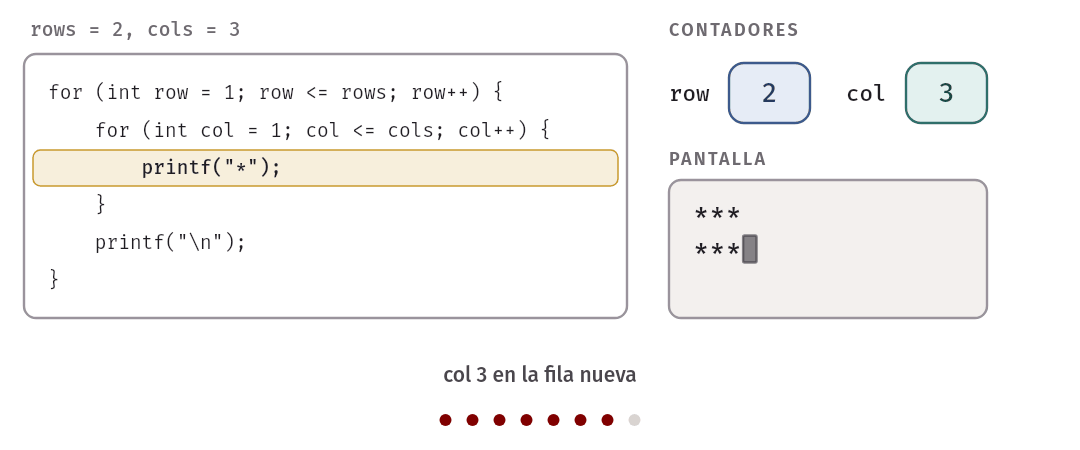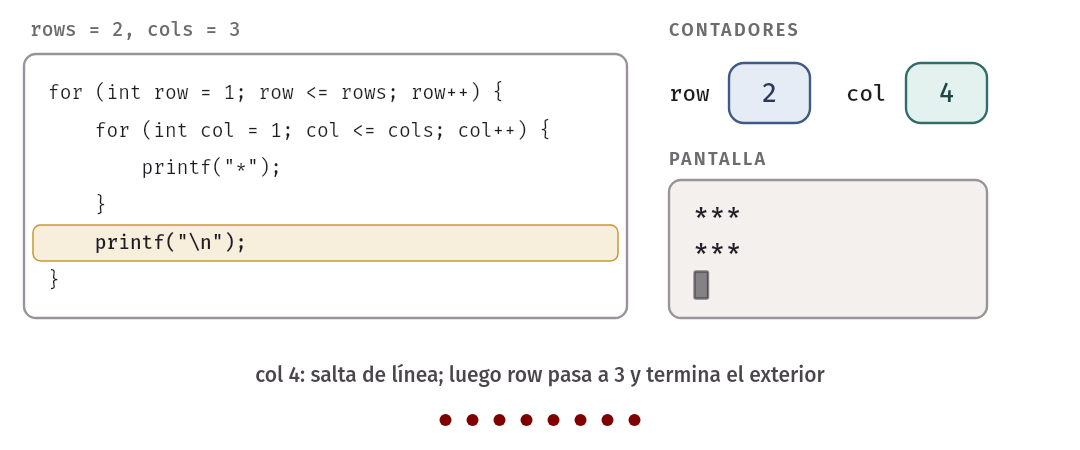
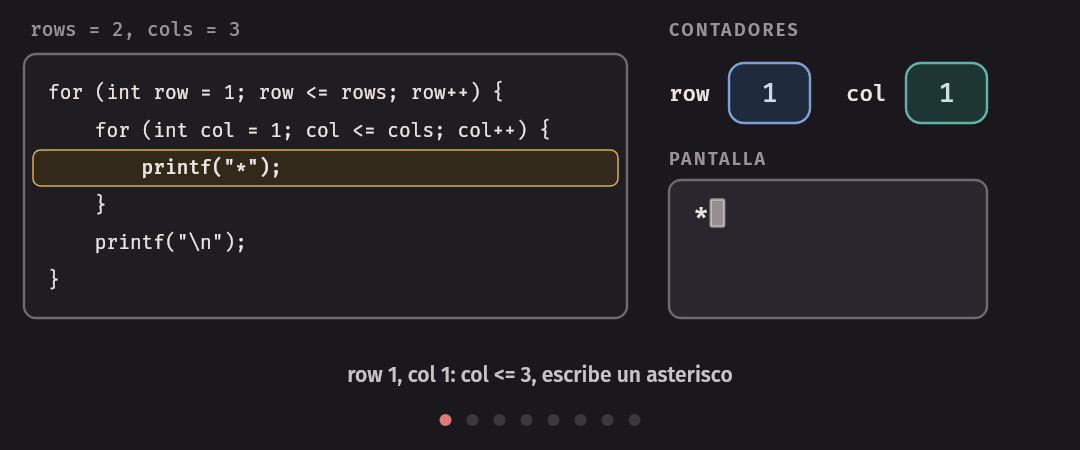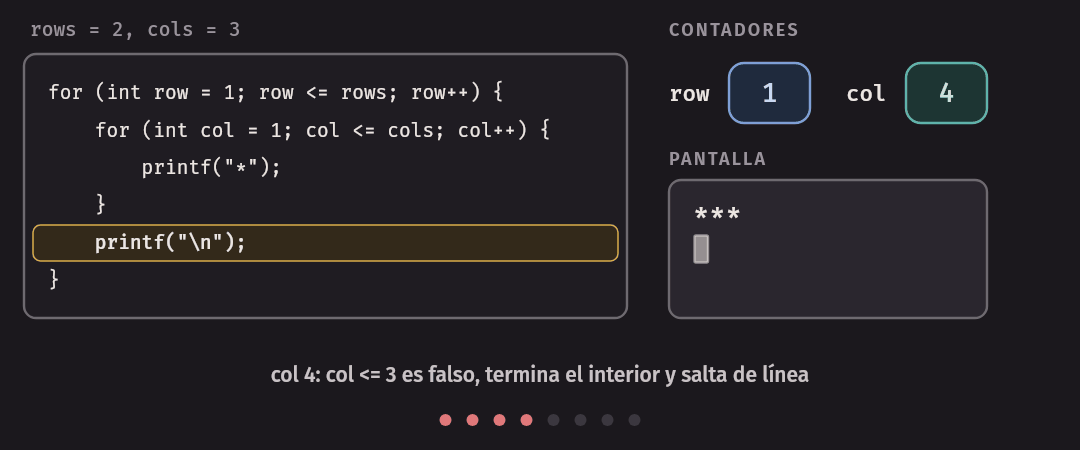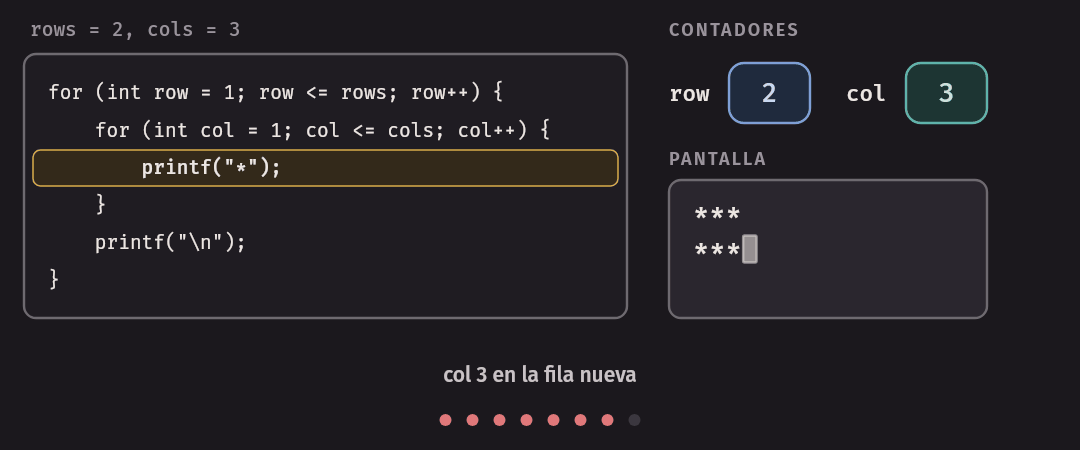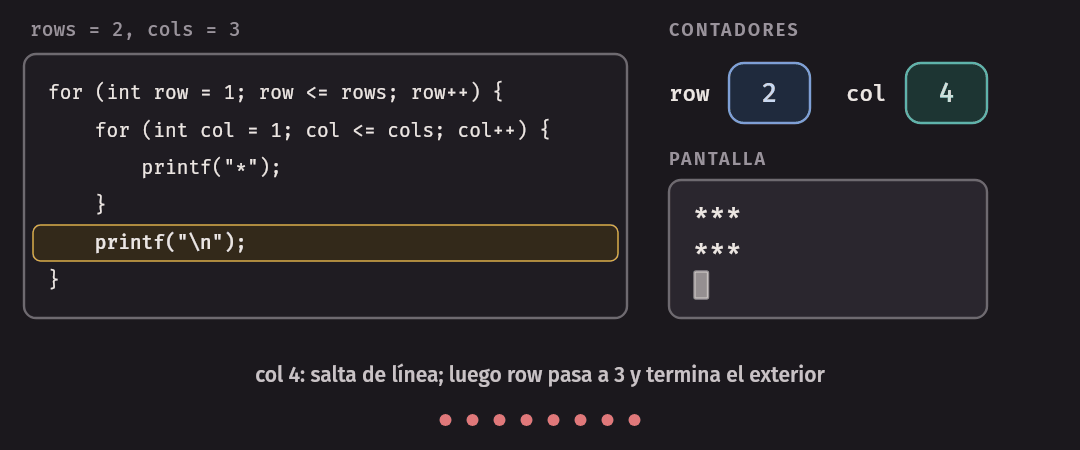
Sigámoslo a mano con 2 filas y 3 columnas.
row |
col |
¿col <= 3? |
Qué hace | Lo que va en pantalla |
|---|---|---|---|---|
| 1 | 1 | sí | escribe * |
* |
| 1 | 2 | sí | escribe * |
** |
| 1 | 3 | sí | escribe * |
*** |
| 1 | 4 | no | termina el interior, salta de línea | *** y salto |
| 2 | 1 | sí | escribe * |
* en la fila nueva |
| 2 | 2 | sí | escribe * |
** en la fila nueva |
| 2 | 3 | sí | escribe * |
*** en la fila nueva |
| 2 | 4 | no | termina el interior, salta de línea | *** y salto |
Después row pasa a 3, la condición row <= 2 es falsa y termina el exterior. Lo
importante de la tabla es que col vuelve a 1 cuando empieza la fila 2. Eso ocurre
porque el for interior empieza desde cero cada vez que se llega a él, y su primera
parte, int col = 1, se ejecuta de nuevo.
$ echo 2 5 | build/rectangle
*****
*****
$ echo abc | build/rectangle
Entrada inválida
echo 2 5 | le pasa esos datos al programa, como si se escribieran con el teclado. Como
en todos los programas desde la semana 4, se revisa lo que devuelve scanf. Aquí pedimos
dos datos, así que todo salió bien solo si devuelve 2.
Idea clave. Por cada vuelta del ciclo exterior, el ciclo interior corre completo. Para diseñar un ciclo anidado, primero piensen cómo se hace una fila. Después repitan eso.
La tabla de multiplicar
La tabla de multiplicar es el ejemplo clásico, porque cada casilla depende de las dos
variables: la casilla de la fila row y la columna col vale row * col.
algoritmo tabla_de_multiplicar()
    leer n
    para fila desde 1 hasta n hacer
        para columna desde 1 hasta n hacer
            escribir fila * columna sin saltar de línea
        fin para
        saltar de línea
    fin para
fin algoritmo
En times_table.c, el centro del programa es este:
for (int row = 1; row <= n; row++) {
    for (int col = 1; col <= n; col++) {
        printf("%4d", row * col);
    }
    printf("\n");
}
El formato %4d escribe el entero con un ancho mínimo de 4 caracteres: si el número
es más corto, printf lo completa con espacios a la izquierda. Por eso las columnas
quedan alineadas aunque unos números tengan una cifra y otros, tres.
$ echo 3 | build/times_table
   1   2   3
   2   4   6
   3   6   9
$ echo 13 | build/times_table
n debe estar entre 1 y 12
Sigamos a mano la tabla de 3 × 3, esta vez viendo el orden en que se llenan las casillas.
| Orden | row |
col |
row * col |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 2 | 1 | 2 | 2 |
| 3 | 1 | 3 | 3 |
| salto de línea | 1 | ||
| 4 | 2 | 1 | 2 |
| 5 | 2 | 2 | 4 |
| 6 | 2 | 3 | 6 |
| salto de línea | 2 | ||
| 7 | 3 | 1 | 3 |
| 8 | 3 | 2 | 6 |
| 9 | 3 | 3 | 9 |
| salto de línea | 3 |
La pantalla se escribe de izquierda a derecha y de arriba abajo, igual que una página. Por eso, en casi toda tabla, el ciclo exterior recorre las filas y el interior, las columnas. Si los intercambian, el programa escribe otra cosa: no se puede volver a una fila ya terminada.
Cuántas veces corre cada línea
Vamos a contar. Es la pregunta más útil sobre un ciclo anidado, porque dice cuánto trabajo
hace el programa. Ya no lo vamos a adivinar: en count_runs.c cada línea que nos interesa
suma 1 a un contador, y al final se imprimen los contadores.
for (int row = 1; row <= n; row++) {
    outer_runs++;
    for (int col = 1; col <= n; col++) {
        square_runs++;
    }
}
Antes de correrlo, piénsenlo. Si el exterior da 3 vueltas y en cada una el interior da 3,
la línea interior corre 3 × 3 = 9 veces. En general, n por n.
$ echo 3 | build/count_runs
n = 3
Línea del ciclo exterior: 3
Línea interior, cuadrado: 9
Línea interior, triángulo: 6
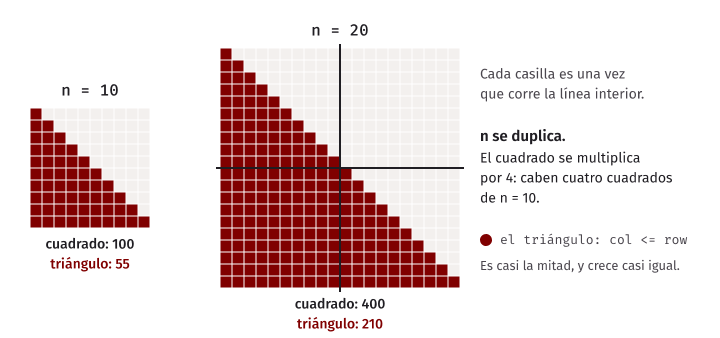
La línea del triángulo la veremos en un momento. Primero, ¿qué pasa si n se duplica?
$ echo 10 | build/count_runs
n = 10
Línea del ciclo exterior: 10
Línea interior, cuadrado: 100
Línea interior, triángulo: 55
$ echo 20 | build/count_runs
n = 20
Línea del ciclo exterior: 20
Línea interior, cuadrado: 400
Línea interior, triángulo: 210
El exterior se duplicó, de 10 a 20. La línea interior se cuadruplicó, de 100 a 400. Si
n se duplica, n * n se multiplica por 2 × 2 = 4. Si n se multiplica por 10, se
multiplica por 100. Esto explica por qué un programa con ciclos anidados puede ir bien con
datos pequeños y volverse muy lento con datos grandes. Volveremos a esta idea cuando
veamos eficiencia.
Un cuidado: un contador también es un int, y un int tiene límite. Como vieron en la
semana 3, pasarse del límite de un int con signo es comportamiento indefinido. Por eso
count_runs.c solo acepta n hasta 5000: en el peor caso cuenta 25 millones, que cabe de
sobra.
También se cuentan las partes del for
Un for no es una sola línea: tiene tres partes, y cada una corre una cantidad distinta
de veces. La condición siempre se evalúa una vez más que las vueltas, porque la última
evaluación es la que da falso y termina el ciclo. Para el ciclo cuadrado:
| Parte | Veces | Con n = 3 |
|---|---|---|
int row = 1 |
1 | 1 |
row <= n |
n + 1 |
4 |
row++ |
n |
3 |
int col = 1 |
n |
3 |
col <= n |
n * (n + 1) |
12 |
| cuerpo del interior | n * n |
9 |
col++ |
n * n |
9 |
Fíjense en int col = 1: corre una vez por cada fila, no una sola vez. Y col <= n corre
4 veces en cada una de las 3 filas: 12 en total.
Cuando el interior depende del exterior
No siempre el interior da la misma cantidad de vueltas. Con la condición col <= row, el
interior da 1 vuelta en la fila 1, 2 vueltas en la fila 2, y así:
for (int row = 1; row <= n; row++) {
    for (int col = 1; col <= row; col++) {
        triangle_runs++;
    }
}
Ahora el total ya no es una multiplicación, sino la suma 1 + 2 + 3 + ... + n. Hay un
truco para calcularla. Escríbanla dos veces, una al revés, y súmenlas columna por columna:
| 1.ª | 2.ª | 3.ª | 4.ª | 5.ª | |
|---|---|---|---|---|---|
| La suma | 1 | 2 | 3 | 4 | 5 |
| Al revés | 5 | 4 | 3 | 2 | 1 |
| Las dos juntas | 6 | 6 | 6 | 6 | 6 |
Con n = 5 son 5 columnas que valen 6 cada una: 30 en total. Eso es el doble de la suma
que buscamos, así que la suma es 15. En general, son n columnas que valen n + 1:
1 + 2 + 3 + ... + n = n * (n + 1) / 2Con n = 3 da 6, con n = 10 da 55 y con n = 20 da 210. Son justo los números que
imprimió count_runs. Es casi la mitad del cuadrado. ¿Y si n crece mucho?
$ echo 100 | build/count_runs
n = 100
Línea del ciclo exterior: 100
Línea interior, cuadrado: 10000
Línea interior, triángulo: 5050
$ echo 200 | build/count_runs
n = 200
Línea del ciclo exterior: 200
Línea interior, cuadrado: 40000
Línea interior, triángulo: 20100
Al duplicar n, el triángulo también se multiplica casi por 4: 20100 / 5050 da cerca de
3.98. Ser la mitad de un cuadrado sigue siendo crecer como un cuadrado.
Idea clave. Con dos ciclos anidados de
nvueltas, la línea interior corren * nveces. Sinse duplica, corre 4 veces más. Si el interior va hasta el valor del exterior, corren * (n + 1) / 2veces, y crece casi igual.
Patrones: cada fila depende de su número
La pregunta para dibujar cualquier patrón es: ¿qué tiene la fila número row? Con esa
respuesta se escribe el ciclo interior. Veamos este, en staircase.c:
$ echo 4 | build/staircase
  1
  1  2
  1  2  3
  1  2  3  4
La fila 1 tiene los números del 1 al 1. La fila 2, del 1 al 2. La fila row, del 1 a
row. Esa frase ya es el ciclo interior. Aquí %3d da a cada número un ancho mínimo de 3
caracteres:
for (int row = 1; row <= n; row++) {
    for (int col = 1; col <= row; col++) {
        printf("%3d", col);
    }
    printf("\n");
}
Hagan siempre esta tabla antes de programar un patrón:
| Fila | Primer número | Último número | Vueltas del interior |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 2 | 1 | 2 | 2 |
| 3 | 1 | 3 | 3 |
row |
1 | row |
row |
La última fila de la tabla, con row, es la que se traduce a C. El triángulo de
asteriscos del laboratorio se resuelve con el mismo método.
Dos errores típicos
Error común. Usar la misma variable en los dos ciclos. El interior le cambia el valor al exterior:
for (i = 1; i <= 3; i++) {
    for (i = 1; i <= 3; i++) {
        printf("*");
    }
    printf("\n");
}
Esperamos 3 filas, y sale una sola:
$ gcc -Wall -Wextra -std=c17 errors/same_counter.c -o build/same_counter
$ build/same_counter
***
Cuando termina el interior,
ivale 4. Se escribe el salto de línea, eli++del exterior la deja en 5, y5 <= 3es falso.gccno avisa, porque el programa es válido. Declarar cada contador dentro de sufor, conint, y darle otro nombre evita este error.
Error común. Con
while, el contador del interior no vuelve solo a su valor inicial. Unforlo reinicia porque su primera parte corre cada vez; unwhile, no, y hay que hacerlo a mano.while (row <= 3) { while (col <= 4) { printf("*"); col++; } printf("\n"); row++; }Aquí
colempezó en 1 antes de los ciclos. En la fila 1 llega a 5, y ahí se queda. En las filas 2 y 3 la condición ya es falsa, así que esas filas salen vacías:$ gcc -Wall -Wextra -std=c17 errors/no_reset.c -o build/no_reset $ build/no_reset ****La corrección es poner
col = 1;justo antes delwhileinterior.
Un ciclo que cuenta dentro de otro: los divisores
El ciclo interior no solo sirve para dibujar. También puede responder una pregunta sobre cada vuelta del exterior. Por ejemplo: ¿cuáles son los divisores de cada número del 1 al 12?
Para un número n, se prueba cada posible divisor d desde 1 hasta n. Si el resto
de dividir n entre d es 0, entonces d es divisor. Eso es lo que aprendieron la
semana pasada. Ahora se repite para cada n. Recuerden que mod es el resto de la
división.
algoritmo divisores_hasta(limite)
    para n desde 1 hasta limite hacer
        cuenta ← 0
        escribir n
        para d desde 1 hasta n hacer
            si n mod d = 0 entonces
                escribir d
                cuenta ← cuenta + 1
            fin si
        fin para
        escribir cuenta
    fin para
fin algoritmo
En divisors.c:
for (int n = 1; n <= limit; n++) {
    int count = 0;

    printf("%d:", n);
    for (int d = 1; d <= n; d++) {
        if (n % d == 0) {
            printf(" %d", d);
            count++;
        }
    }
    printf(" (%d)\n", count);
}
$ echo 12 | build/divisors
1: 1 (1)
2: 1 2 (2)
3: 1 3 (2)
4: 1 2 4 (3)
5: 1 5 (2)
6: 1 2 3 6 (4)
7: 1 7 (2)
8: 1 2 4 8 (4)
9: 1 3 9 (3)
10: 1 2 5 10 (4)
11: 1 11 (2)
12: 1 2 3 4 6 12 (6)Miren la posición de int count = 0: está dentro del exterior y fuera del interior. Cada
número empieza con su propia cuenta en 0. Si se declarara antes del exterior, la cuenta de
cada número se sumaría a la de los anteriores. Un acumulador se inicia justo antes del
ciclo que acumula.
Miren también la última columna. Los números con exactamente 2 divisores son 2, 3, 5, 7 y 11. Vamos a usar esto en el laboratorio.
Error común. Poner el
printfdel resultado dentro del ciclo interior. Con esa posición se imprime una vez por cadad, en lugar de una vez por cadan. Antes de escribir una línea, pregúntense cuántas veces debe correr; eso les dice en qué nivel va.
Números que parecen al azar
Cambiamos de tema. Un juego necesita lanzar un dado, y un programa de simulación necesita muchos lanzamientos. Pero una computadora sigue instrucciones exactas: con los mismos datos, un algoritmo da siempre el mismo resultado. ¿De dónde sale entonces el azar?
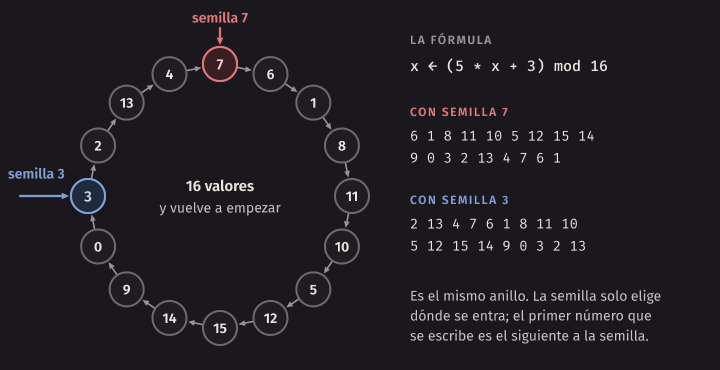
En la mayoría de los programas, no sale de ninguna parte. Son números pseudoaleatorios (pseudorandom): se calculan con una fórmula, pero la secuencia parece al azar. Cada número sale de un estado que el generador guarda y actualiza, y ese estado parte de un valor inicial llamado semilla (seed).
Un generador de juguete
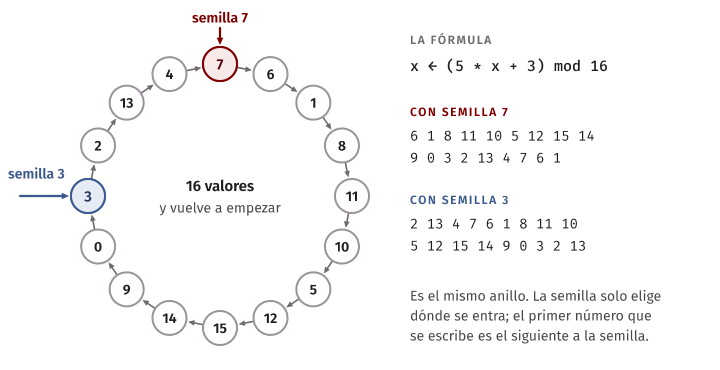
Para ver la idea, hagamos un generador pequeño, en toy_generator.c. La fórmula es esta:
x ← (5 * x + 3) mod 16Empecemos con la semilla 7 y calculemos a mano los primeros valores.
| Paso | x anterior |
5 * x + 3 |
mod 16 |
|---|---|---|---|
| 1 | 7 | 38 | 6 |
| 2 | 6 | 33 | 1 |
| 3 | 1 | 8 | 8 |
| 4 | 8 | 43 | 11 |
| 5 | 11 | 58 | 10 |
El programa es un solo ciclo:
for (int i = 1; i <= 18; i++) {
    x = (5 * x + 3) % 16;
    printf("%d ", x);
}
$ echo 7 | build/toy_generator
6 1 8 11 10 5 12 15 14 9 0 3 2 13 4 7 6 1
$ echo 3 | build/toy_generator
2 13 4 7 6 1 8 11 10 5 12 15 14 9 0 3 2 13A primera vista, 6 1 8 11 10 5 12 no tiene un orden claro. Pero este experimento muestra
tres propiedades que tienen todos los generadores de este tipo:
- Es determinista. Con la semilla 7 siempre sale lo mismo.
- La semilla elige el punto de partida. Con otra semilla se obtiene otro comienzo.
- Tarde o temprano se repite. El 6 vuelve a salir en la posición 17, y desde ahí todo
se repite: una vez que
xvuelve a un valor, el siguiente tiene que ser el mismo de antes. Aquí se repite cada 16 números, que es el período del generador.
El rand de C funciona con la misma idea, con una fórmula más elaborada, que cambia de
una implementación a otra, y con un período mucho más largo. Su estado suele ser más grande
que el número que devuelve: por eso un mismo número puede repetirse sin que se repita lo que
sigue. En este generador de juguete, el estado es x.
rand y RAND_MAX
rand está en stdlib.h. Cada llamada devuelve el número siguiente de la secuencia, un
int entre 0 y RAND_MAX, ambos incluidos.
printf("RAND_MAX = %d\n", RAND_MAX);

for (int i = 1; i <= 5; i++) {
    printf("%d\n", rand());
}
Esta salida es del entorno del curso. En otro sistema puede ser distinta.
$ build/rand_max
RAND_MAX = 2147483647
1804289383
846930886
1681692777
1714636915
1957747793
RAND_MAX no es el mismo en todos lados. El estándar de C solo exige que sea al menos
32767. Aquí es 2147483647, pero un programa que supone ese valor deja de funcionar bien en
otro sistema. Usen siempre el nombre RAND_MAX, nunca el número.
Corran el programa de nuevo. Salen los mismos números, cada vez. Así lo pide el
estándar: si no se elige una semilla, rand se comporta como si la semilla fuera 1.
Error común. Olvidar
#include <stdlib.h>. Con elgccdel curso es un error de compilación:$ gcc -Wall -Wextra -std=c17 errors/no_stdlib.c -o build/no_stdlib errors/no_stdlib.c: In function ‘main’: errors/no_stdlib.c:5:20: error: implicit declaration of function ‘rand’ [-Wimplicit-function-declaration] 5 | printf("%d\n", rand()); | ^~~~
La semilla
srand elige la semilla. Recibe un unsigned int (el entero sin signo de la semana 3).
Se llama una sola vez, antes de usar rand. El programa seed.c lee la semilla y
escribe los primeros números:
srand((unsigned) seed);

for (int i = 1; i <= 5; i++) {
    printf("%d\n", rand());
}
La conversión (unsigned) es explícita para que se vea el cambio de tipo. Por eso el
programa rechaza antes las semillas negativas.
Estas salidas también son del entorno del curso. Lo que sí vale en cualquier sistema es lo que se ve al compararlas, y lo probamos abajo.
$ echo 1 | build/seed
1804289383
846930886
1681692777
1714636915
1957747793
$ echo 42 | build/seed
71876166
708592740
1483128881
907283241
442951012
$ echo 42 | build/seed
71876166
708592740
1483128881
907283241
442951012
La semilla 1 da lo mismo que no elegir ninguna. La semilla 42 da otra secuencia, y la da igual las dos veces. Pero ojo: esa igualdad vale dentro de una misma implementación de C. Con la misma semilla, otro sistema puede dar otros números. Por eso las pruebas de este curso no comparan números aleatorios exactos entre sistemas; comprueban propiedades: que el número esté en su rango, o que dos corridas iguales den lo mismo.
¿Para qué sirve fijar la semilla?
Conviene fijarla cuando quieren repetir un resultado. Si un programa falla solo con ciertos números al azar, sin semilla fija nunca sabrían qué pasó. Con semilla fija, el error aparece igual cada vez, y se puede buscar. También sirve para que otra persona, en el mismo sistema, compruebe un resultado.
No conviene cuando se quiere que cada corrida sea distinta. Un juego en el que el dado saca siempre lo mismo no es un juego. Para eso se usa como semilla algo que cambia: la hora.
Sembrar con la hora
time, de time.h, da la hora actual como un número. En el entorno del curso, es la
cantidad de segundos transcurridos desde 1970. Su argumento es NULL, que aquí significa
“no hay dónde más guardar la hora”: solo nos interesa el valor que devuelve. El estándar
no fija el tipo exacto de ese valor; por eso lo convertimos con (unsigned).
srand((unsigned) time(NULL));

for (int i = 1; i <= 10; i++) {
    printf("%d ", 1 + rand() % 6);
}
La expresión 1 + rand() % 6 da un dado; la explicamos en la sección siguiente. Corramos
el programa dos veces seguidas y, después de esperar un segundo con el comando sleep 1,
una vez más. El ; del comando ejecuta una orden después de la otra. Estos números
cambian en cada corrida; esto es lo que salió en esta.
$ build/time_seed; build/time_seed; sleep 1; build/time_seed
6 6 3 1 3 1 2 5 5 4
6 6 3 1 3 1 2 5 5 4
1 5 5 3 1 5 3 1 4 1
Las dos primeras líneas son iguales. No es casualidad. Las dos corridas empezaron en el mismo segundo, así que recibieron la misma semilla. Si dos programas arrancan a la vez, no son independientes.
Error común. Llamar a
sranddentro del ciclo, “para que sea más aleatorio”. Cada llamada reinicia la secuencia en su comienzo. Dentro del mismo segundo, cada vuelta recibe la misma semilla, y el dado da el mismo número. La salida cambia de una corrida a otra; en esta salió así:$ gcc -Wall -Wextra -std=c17 errors/srand_in_loop.c -o build/srand_in_loop $ build/srand_in_loop 1 1 1 1 1 1 1 1 1 1
srandva una vez, al principio demain, antes del ciclo.
Idea clave. Misma semilla, misma secuencia, dentro de una misma implementación. Fijen la semilla para repetir un resultado y usen la hora para que cambie entre corridas.
randno sirve para seguridad, como generar contraseñas: quien conoce la fórmula y observa algunos números puede calcular los siguientes.
Un número en un rango
rand da números enormes, y queremos un dado. El operador % da la solución. Como el
resto de dividir entre 6 siempre está entre 0 y 5, rand() % 6 da algo de 0 a 5. Falta
correrlo una posición:
| Expresión | Da |
|---|---|
rand() |
de 0 a RAND_MAX |
rand() % 6 |
de 0 a 5 |
1 + rand() % 6 |
de 1 a 6 |
Recuerden que % tiene más precedencia que +, así que primero se calcula el resto. La
fórmula general da un número entre min y max, ambos incluidos. Hay max - min + 1
valores posibles:
printf("%d ", min + rand() % (max - min + 1));Prueben con los dados: para min = 1 y max = 6, hay 6 valores posibles y sale 1 + rand() % 6. Y con una nota de 0 a 20, hay 21 valores, no 20. Ese + 1 es el salirse
por uno de la semana pasada.
En pseudocódigo escribiremos azar(a, b) para decir “un entero al azar entre a y b,
ambos incluidos”. No es una palabra del lenguaje de pseudocódigo: es una operación que
definimos aquí.
El programa range.c lee el mínimo, el máximo y la semilla, y escribe diez números. Los
valores son del entorno del curso; lo que vale siempre es el rango.
$ echo 1 6 42 | build/range
1 1 6 4 5 5 2 1 6 6
$ echo 0 20 42 | build/range
12 9 17 18 7 1 10 3 11 14
$ echo -5 5 42 | build/range
5 4 -2 2 4 0 -2 -3 3 4
Error común. Olvidar el
1 +. Este programa lanza 100 000 veces un “dado” conrand() % 6, y anota el menor y el mayor valor que salieron. Un dado que da 0 y nunca da 6 no es un dado:$ gcc -Wall -Wextra -std=c17 errors/die_off_by_one.c -o build/die_off_by_one $ build/die_off_by_one Menor: 0 Mayor: 5
¿Todas las caras salen igual?
Contemos. Sin arreglos, que veremos en la semana 9, necesitamos un contador por cara. Por
eso die_counts.c usa un switch con seis variables. Es largo, y es una buena razón para
querer arreglos.
Con 60 lanzamientos esperaríamos unos 10 por cara, y con 600 000, unos 100 000. Estos conteos son del entorno del curso:
$ echo 42 60 | build/die_counts
Cara 1: 13
Cara 2: 6
Cara 3: 6
Cara 4: 13
Cara 5: 8
Cara 6: 14
$ echo 42 600000 | build/die_counts
Cara 1: 99986
Cara 2: 99434
Cara 3: 100661
Cara 4: 99990
Cara 5: 100184
Cara 6: 99745
En esta corrida, con 60 lanzamientos, los conteos están muy desiguales: unas caras salen más del doble que otras. Nada está mal: es normal que una muestra pequeña varíe mucho. Con 600 000, todas las caras quedan a menos de 1 % de lo esperado.
Una desviación pequeña
El método con % tiene un defecto pequeño, llamado sesgo (bias): no todos los
resultados son exactamente igual de probables. Para verlo, imaginemos un rand muy corto,
que solo diera los números del 0 al 7.
rand() |
0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|---|
rand() % 6 |
0 | 1 | 2 | 3 | 4 | 5 | 0 | 1 |
Los valores 0 y 1 salen por dos caminos, y los otros cuatro, por uno solo. Sobran dos números, porque 8 no se reparte exacto entre 6.
Con el RAND_MAX de nuestro entorno, hay 2147483648 números posibles. Al repartirlos
entre 6, dos caras reciben 357913942 números y las otras cuatro, 357913941. La diferencia
es de uno en cientos de millones, mucho menor que la variación que vimos arriba. Para un
dado o para este curso, no importa. Importaría si el rango fuera comparable con
RAND_MAX. Por eso range.c limita el rango a 20001 valores, que caben aun con el menor
RAND_MAX permitido.
Simular: estimar una probabilidad
¿Cuál es la probabilidad de que dos dados sumen 7? Tenemos dos maneras de responder. Una exacta y otra aproximada. Las vamos a hacer las dos, y las vamos a comparar.
La respuesta exacta
Con dos dados hay 6 × 6 = 36 resultados, todos igual de probables. Contar cuántos suman 7 es un ciclo anidado:
algoritmo formas_de_sumar_7()
    formas ← 0
    para d1 desde 1 hasta 6 hacer
        para d2 desde 1 hasta 6 hacer
            si d1 + d2 = 7 entonces
                formas ← formas + 1
            fin si
        fin para
    fin para
    escribir formas
fin algoritmo
El programa dice_exact.c lo hace para todas las sumas de 2 a 12, con un ciclo más por
fuera. Son tres ciclos anidados: se leen igual que dos. La línea del if corre 11 × 6
× 6 = 396 veces. %2d deja un ancho mínimo de 2 caracteres para la suma, y %.4f escribe
4 decimales.
for (int target = 2; target <= 12; target++) {
    int ways = 0;

    for (int d1 = 1; d1 <= 6; d1++) {
        for (int d2 = 1; d2 <= 6; d2++) {
            if (d1 + d2 == target) {
                ways++;
            }
        }
    }
    printf("Suma %2d: %d de 36, %.4f\n", target, ways, (double) ways / 36);
}
$ build/dice_exact
Suma 2: 1 de 36, 0.0278
Suma 3: 2 de 36, 0.0556
Suma 4: 3 de 36, 0.0833
Suma 5: 4 de 36, 0.1111
Suma 6: 5 de 36, 0.1389
Suma 7: 6 de 36, 0.1667
Suma 8: 5 de 36, 0.1389
Suma 9: 4 de 36, 0.1111
Suma 10: 3 de 36, 0.0833
Suma 11: 2 de 36, 0.0556
Suma 12: 1 de 36, 0.0278Son 6 formas de 36: (1,6), (2,5), (3,4), (4,3), (5,2) y (6,1). La probabilidad exacta es
6/36 = 1/6, cerca de 0.1667. El (double) es el mismo cast de la semana 2: sin él,
ways / 36 sería una división entera y daría 0.
La respuesta por simulación
Aquí contamos porque el problema es pequeño. Muchos problemas reales tienen demasiados casos para recorrerlos, o reglas demasiado complicadas para hacer la cuenta. Ahí se usa una simulación: se repite el experimento muchas veces con números aleatorios, y se mira con qué frecuencia ocurre el resultado.
algoritmo estimar_suma_7(intentos)
    aciertos ← 0
    para i desde 1 hasta intentos hacer
        d1 ← azar(1, 6)
        d2 ← azar(1, 6)
        si d1 + d2 = 7 entonces
            aciertos ← aciertos + 1
        fin si
    fin para
    escribir aciertos / intentos
fin algoritmo
Sigámoslo a mano con 5 intentos. Los dados de esta tabla los elegimos para el ejemplo; no salen de un programa.
i |
d1 |
d2 |
Suma | aciertos |
|---|---|---|---|---|
| 1 | 3 | 4 | 7 | 1 |
| 2 | 6 | 2 | 8 | 1 |
| 3 | 5 | 2 | 7 | 2 |
| 4 | 1 | 1 | 2 | 2 |
| 5 | 6 | 1 | 7 | 3 |
La estimación sería 3 / 5 = 0.6, muy lejos de 0.1667. Con 5 intentos no se puede esperar otra cosa: solo son posibles 0, 0.2, 0.4, 0.6, 0.8 y 1.
En dice_seven.c, el centro del programa es este:
srand((unsigned) seed);

for (int i = 1; i <= trials; i++) {
    int d1 = 1 + rand() % 6;
    int d2 = 1 + rand() % 6;

    if (d1 + d2 == 7) {
        hits++;
    }
}
Y al final:
printf("%d intentos, %d sumaron 7, estimación %.4f\n", trials, hits, (double) hits / trials);Cada dado se guarda en su propia variable, en dos instrucciones. Así queda claro qué
número es de qué dado: en una sola expresión con dos rand(), el lenguaje no fija cuál de
las dos llamadas corre primero.
Los comandos pasan la semilla y los intentos, separados por un espacio. Estos valores son del entorno del curso:
$ echo 42 100 | build/dice_seven
100 intentos, 22 sumaron 7, estimación 0.2200
$ echo 42 100 | build/dice_seven
100 intentos, 22 sumaron 7, estimación 0.2200
$ echo 7 100 | build/dice_seven
100 intentos, 23 sumaron 7, estimación 0.2300
La misma semilla da lo mismo. Otra semilla da otra estimación. Y las dos están bastante lejos de 0.1667.
Error común. Dividir dos enteros. El programa corre sin avisar, hace su millón de intentos y responde cero:
$ gcc -Wall -Wextra -std=c17 errors/int_probability.c -o build/int_probability
$ build/int_probability
Estimación: 0.0000
hits / trialses una división entera: mientrashitssea menor quetrials, da 0. Que el resultado se guarde en undoubleno cambia nada: la división ya se hizo. Es el error de la semana 2, en un sitio donde cuesta más verlo.
El error baja con más intentos
Una estimación no es un valor exacto. Depende de la semilla y de cuántos intentos se
hagan. Corrimos dice_seven con cinco semillas y tres cantidades de intentos. Estos
valores son del entorno del curso; en otro sistema serán otros, con el mismo
comportamiento. La última fila es el peor error de cada columna: la mayor distancia a 1/6.
| Semilla | 100 intentos | 10 000 intentos | 1 000 000 de intentos |
|---|---|---|---|
| 1 | 0.1600 | 0.1671 | 0.1663 |
| 2 | 0.1700 | 0.1659 | 0.1667 |
| 3 | 0.1600 | 0.1672 | 0.1666 |
| 7 | 0.2300 | 0.1723 | 0.1662 |
| 42 | 0.2200 | 0.1675 | 0.1670 |
| Peor error | 0.0633 | 0.0056 | 0.0005 |
Lean la tabla por columnas. Con 100 intentos, las estimaciones van de 0.16 a 0.23: de ahí no se podría sacar ni la segunda cifra decimal. Con un millón, todas están entre 0.1662 y 0.1670. La estimación varía menos cuando crecen los intentos, y se acerca más a la respuesta exacta.
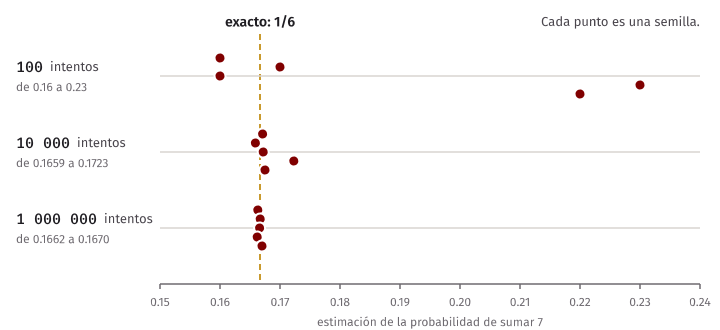
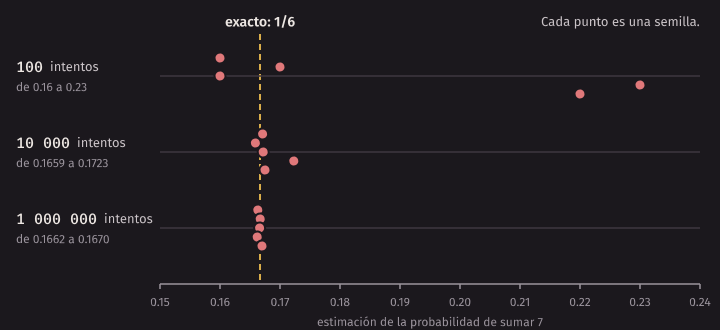
Lean también de una columna a la otra. Los intentos se multiplicaron por 100, y el peor error se dividió más o menos entre 10. Es un comportamiento general, que se demuestra en un curso de estadística: para reducir el error típico (el tamaño habitual del error) a la décima parte, hacen falta cerca de 100 veces más intentos. Es decir, cada cifra decimal correcta adicional se paga cara.
Tres cuidados al leer una simulación:
- Una estimación no tiene por qué dar el valor exacto. Con 100 intentos, solo se pueden obtener múltiplos de 0.01, y 1/6 no es uno de ellos. Esa simulación nunca podría dar 1/6.
- El peor error de la tabla no es un límite. Otra semilla podría dar un error mayor. Con más intentos, un error grande se vuelve cada vez menos probable, pero no imposible.
- Si la estimación se compara con un valor, se usa una tolerancia, como en la semana
4. Preguntar
estimate == 1.0 / 6es una mala pregunta por dos razones: la de losdoubley la de la simulación. La tolerancia depende de los intentos: en nuestras pruebas, con 1 000 000 de intentos exigimos estar a menos de 0.003 de 1/6, un margen muy amplio para esa cantidad, y con 10 000 exigimos 0.03.
Idea clave. Una simulación da una estimación, no un valor exacto. Repítanla con otras semillas para ver cuánto varía. Más intentos dan menos error, pero con un costo creciente. Si se conoce la respuesta exacta, comparen contra ella con una tolerancia.
El laboratorio, paso a paso
El laboratorio tiene tres programas, en lab/, y una pregunta. Cada archivo explica en su
comentario inicial qué debe escribir. Compruébenlos con make test-lab: falla hasta que
los terminen.
Un triángulo de asteriscos
lab/triangle.c lee la altura N y dibuja N filas. Hagan primero la tabla del patrón:
¿cuántos asteriscos tiene la fila 1, la fila 2, la fila row? Después, miren
staircase.c: el triángulo tiene la misma forma, y cambia lo que se escribe. Prueben con
1 y con 3. Los datos fuera de rango y lo que no es número también tienen su mensaje.
Los primos hasta N
Un número primo tiene exactamente dos divisores: 1 y él mismo. La semana pasada vieron
cómo decidirlo para un número. En lab/primes.c hay que hacerlo para cada número hasta
N. Es la misma forma de divisors.c: el exterior recorre los candidatos y el interior
busca divisores. Cambia lo que se escribe, y se escribe solo cuando la cuenta es 2. Si N
es 1 no hay primos, y el programa no escribe nada.
Este método no es el más rápido: para N = 10000, el interior da cerca de 50 millones de vueltas,
porque para cada n prueba todos los d hasta n. El ejercicio 7 les pide reducirlo.
Estimar con tres cantidades de intentos
lab/dice_estimate.c lee una semilla y hace tres estimaciones: con 100, con 10 000 y con
1 000 000 de intentos. Tomen el ciclo de dice_seven.c y pónganlo dentro de otro, que
recorra las tres cantidades. Se puede escribir así: for (int trials = 100; trials <= 1000000; trials *= 100), donde trials *= 100 es una abreviatura de trials = trials * 100. Sigan a mano ese ciclo para comprobar sus tres vueltas.
Dos detalles. hits debe volver a 0 para cada cantidad de intentos; piensen en qué nivel
va. Y el error es la distancia sin signo entre la estimación y 1.0 / 6. Usen fabs, de
math.h, como en compare_double.c de la semana 4.
¿Qué cambia con la semilla?
Corran dice_estimate dos veces con la misma semilla y una con otra. Antes de hacerlo,
escriban qué esperan. Después escriban en un comentario, al final de
lab/dice_estimate.c, qué cambió, qué no cambió y por qué. Fíjense en cuánto cambia la
línea de 100 intentos y cuánto la de 1 000 000.
Resumen
- En los ciclos anidados, por cada vuelta del exterior, el interior corre completo. El interior empieza desde el principio en cada vuelta.
- Para diseñar uno, primero piensen qué hace una fila. Si el contenido cambia por
fila, hagan una tabla con lo que tiene la fila
row. - La posición de cada línea dice cuántas veces corre: en el interior, una vez por casilla; en el exterior, una vez por fila.
- Dos ciclos de
nvueltas hacen correr la línea interiorn * nveces. Sinse duplica, corre 4 veces más. Si el interior va hastarow, corren * (n + 1) / 2veces. - Cada ciclo necesita su propio contador. Con
while, el contador del interior se reinicia a mano. Un acumulador se inicia justo antes del ciclo que acumula. rand, destdlib.h, da números pseudoaleatorios entre 0 yRAND_MAX, que depende de la implementación y es al menos 32767.srandelige la semilla, una sola vez. Misma semilla, misma secuencia, en una misma implementación. Sinsrand, la semilla es 1.srand((unsigned) time(NULL))cambia entre corridas, pero se repite dentro del mismo segundo.min + rand() % (max - min + 1)da un entero entreminymax. Tiene un sesgo muy pequeño si el rango es chico frente aRAND_MAX.- Una simulación estima una probabilidad repitiendo un experimento. Es una estimación: cambia con la semilla, y su error baja con más intentos. Para dividir el error típico entre 10 hacen falta cerca de 100 veces más intentos.
Ejercicios
Los ejercicios usan solo main, sin arreglos. Todo programa revisa su scanf. Si un
ejercicio pide comparar con valores de rand, recuerden que esos valores dependen de la
implementación.
-
Sin compilar, escriban lo que imprime este fragmento y cuántas veces corre cada
printf. Después compruébenlo con un programa.for (int i = 1; i <= 3; i++) { for (int j = 1; j <= 2; j++) { printf("%d ", i * j); } printf("\n"); } -
Para cada fragmento, digan cuántas veces corre
x++en función den. Calculen el resultado conn = 10y conn = 20. Comprueben con un programa que imprimax.for (int i = 1; i <= n; i++) { for (int j = 1; j <= 2 * n; j++) { x++; } } for (int i = 1; i <= n; i++) { for (int j = i; j <= n; j++) { x++; } } for (int i = 1; i <= n; i++) { for (int j = 1; j <= 5; j++) { x++; } }En el tercero, ¿qué pasa con
xal duplicarn? ¿Por qué no se cuadruplica? -
Escriban un programa que lea
n, entre 1 y 9, y escriba un triángulo invertido:nasteriscos en la primera fila,n - 1en la segunda, y uno en la última. Hagan primero la tabla del patrón. -
Escriban un programa que lea
n, entre 1 y 20, y dibuje el borde de un cuadrado den×n:*en la primera y última fila, y en la primera y última columna, y un espacio en el resto. Pruébenlo con1,2y5. -
Escriban un programa que lea
n, entre 1 y 20, y dibuje una pirámide centrada, denfilas, en la que la filarowtengan - rowespacios y2 * row - 1asteriscos. ¿Cuántos ciclos interiores necesita cada fila? Conn = 3, la última fila tiene 5 asteriscos y ningún espacio. -
Un número es perfecto si es igual a la suma de sus divisores menores que él. Por ejemplo, 6 = 1 + 2 + 3. Escriban primero el pseudocódigo y después un programa que escriba los números perfectos hasta 1000. ¿Cuántos encontró? ¿Dónde se pone en 0 la suma?
-
Tomen su
primes.cdel laboratorio y agréguenle un contador de las vueltas del ciclo interior. Hagan una versión en la que, para cadan,dempiece en 2 y el interior siga solo mientrasd * d <= ny no se haya encontrado ningún divisor. Comparen el contador conN = 1000y conN = 10000. Comprueben que las dos versiones escriben los mismos primos. ¿Por qué basta con llegar a la raíz den? -
Escriban la expresión con
randque da cada rango, y compruébenla en un programa que tome 100 000 valores y escriba el menor y el mayor que salieron: de 0 a 9; de 10 a 20; de -3 a 3; un número par entre 2 y 12. Para el último, piensen en multiplicar. -
Sigan
errors/die_off_by_one.c. ¿Por qué empiezasmallesten 100 ylargesten -100? Con 100 000 lanzamientos, ¿qué valores esperan? ¿Y con un solo lanzamiento? Cambien el 100000 por un 1, y comprueben lo que dijeron sin mirar el valor exacto:MenoryMayordeben ser iguales. -
Estimen por simulación la probabilidad de sacar al menos un 6 en 4 lanzamientos de un dado. Hacen falta dos ciclos: uno para los intentos y otro para los 4 dados de cada intento. La respuesta exacta es 1 menos la probabilidad de no sacar ningún 6: 1 - (5/6) × (5/6) × (5/6) × (5/6). Calcúlenla en C, y cuidado con
5 / 6: entre enteros da 0. Comparen. ¿Cuántos intentos necesitan para ver bien tres cifras decimales? -
Calculen con tres ciclos anidados de cuántas formas tres dados suman 10, de un total de 216. Después estímenlo con una simulación, con 100, 10 000 y 1 000 000 de intentos. ¿Cuántas veces corre la línea del
ifen el cálculo exacto? -
Con 100 intentos, ¿puede
dice_sevendar exactamente 1/6? ¿Con 600 intentos? Justifiquen, sin correrlo. ¿Una estimación con 600 intentos que da 1/6 estaría “más correcta” que una con 1 000 000 que da 0.1668? ¿En cuál confiarían más, y por qué?