Apuntes · Capítulo 3Fundamentos
Bits: cómo se representan los datos
Bits: cómo se representan los datos
En el capítulo anterior guardaron números y letras en variables de tipo int,
double y char, y con sizeof vieron cuántos bytes ocupa cada una. Pero dejamos
una pregunta sin responder: ¿qué hay realmente dentro de esos bytes?
Este capítulo responde esa pregunta. Dentro de la computadora todo se guarda con
bits. Veremos cómo escribir números en binario y en hexadecimal, cómo se guardan
los negativos, por qué un int puede hacer overflow, por qué 0.1 + 0.2 no da
exactamente 0.3 y por qué la ñ ocupa más espacio que la n. Con esto podrán
prever errores que parecen misteriosos si uno no conoce la representación.
Al final aprenderán lo básico de Git, la herramienta para guardar el historial de un trabajo. Cierra el laboratorio de esta semana.
Lectura. Este capítulo es el texto de la semana. Todo el código está en
code/week-03. Dentro del entorno del curso, en esa carpeta,makecompila los programas ymake testcomprueba que su salida coincide con lo que dice este capítulo.
Ruta de lectura.
- Antes de clase (lectura obligatoria, 15 a 20 minutos): la introducción, “Todo son bits” y “Sistemas posicionales”. Es lo mínimo para seguir la clase.
- En clase: “Bytes y múltiplos”, “Enteros con signo y complemento a dos”, “Overflow”, “Punto flotante”, “
chares un número pequeño: ASCII” y “Unicode y UTF-8”.- Después de clase: para el laboratorio, “Laboratorio: bits a mano” y “Primeros pasos con Git”; para repasar, “Resumen” y “Ejercicios”.
Todo son bits
Un bit es la unidad mínima de información: vale 0 o 1. La palabra viene de binary digit, dígito binario. Una computadora usa bits porque es fácil construir circuitos con dos estados bien separados, como voltaje alto y voltaje bajo. Es mucho más difícil distinguir con seguridad diez niveles distintos.
Un bit solo dice muy poco. Con varios bits se forman combinaciones: cada bit que se agrega duplica la cantidad.
| Bits | Combinaciones | Ejemplo de uso |
|---|---|---|
| 1 | 2 | sí o no |
| 3 | 8 | los días de la semana (sobra una combinación) |
| 8 | 256 | un byte |
| 32 | 4 294 967 296 | un int en nuestro entorno |
En general, con n bits hay 2ⁿ combinaciones.
Un byte es un grupo de 8 bits. Es la unidad con la que se organiza la memoria:
cada byte tiene su lugar propio, y por eso sizeof cuenta bytes y no bits.
Ahora lo más importante de la sección. Los bits no traen una etiqueta que diga qué
significan. El byte 01000001 puede ser el número 65 o la letra A, y son los mismos
ocho bits. Lo que decide cómo se leen es el tipo de la variable y el formato con
que se escribe. Por eso, en C, printf("%d", letra) y printf("%c", letra) escriben
cosas distintas a partir del mismo byte.
Idea clave. Un dato en memoria es solo un patrón de bits. Su significado lo pone el tipo con que se interpreta.
Sistemas posicionales
Decimal: lo que ya saben hacer
Escribimos los números con un sistema posicional: cada dígito vale según el lugar
donde está. En el número 202, los dos dígitos 2 valen distinto:
202 = 2 × 100 + 0 × 10 + 2 × 1Cada posición vale diez veces más que la de su derecha, porque usamos base 10, y por eso necesitamos diez dígitos, del 0 al 9. Nada obliga a usar el 10. Es la base que adoptamos, y cualquier otra funciona con la misma regla.
Binario: base 2
En base 2 hay solo dos dígitos, 0 y 1, y cada posición vale el doble que la de su derecha: 1, 2, 4, 8, 16, 32, 64, 128. Para leer un número en binario, se suman los pesos de las posiciones que tienen un 1.
Veamos 11001010:
| Peso | 128 | 64 | 32 | 16 | 8 | 4 | 2 | 1 |
|---|---|---|---|---|---|---|---|---|
| Bit | 1 | 1 | 0 | 0 | 1 | 0 | 1 | 0 |
| Suma | 128 | 64 | 8 | 2 |
128 + 64 + 8 + 2 = 202. El bit de la derecha es el de menor peso. Si vale 1, el número es impar.
De decimal a binario
Para ir al revés, dividimos entre 2 una y otra vez. Cada resto es un bit, y el primer
resto que sale es el de menor peso. En pseudocódigo escribimos n mod 2 para el resto
de la división y n div 2 para el cociente entero. En C son n % 2 y n / 2 entre
int, como vieron la semana pasada.
algoritmo decimal_a_binario(n)
    mientras n ≠ 0 hacer
        escribir n mod 2
        n ← n div 2
    fin mientras
fin algoritmo
Sigámoslo a mano con 202. Cada fila es una vuelta del mientras:
n al empezar |
n mod 2 (se escribe) |
n div 2 (nuevo n) |
|---|---|---|
| 202 | 0 | 101 |
| 101 | 1 | 50 |
| 50 | 0 | 25 |
| 25 | 1 | 12 |
| 12 | 0 | 6 |
| 6 | 0 | 3 |
| 3 | 1 | 1 |
| 1 | 1 | 0 |
El algoritmo escribe 0 1 0 1 0 0 1 1, es decir, del bit de menor peso al de mayor
peso. Leídos de abajo hacia arriba forman 11001010, y ya vimos que eso vale 202. Con n = 0 el
algoritmo no escribe nada, porque nunca entra al mientras. Es un caso que se debe tratar
aparte: 0 en binario es 0.
Todavía no tenemos ciclos en C: llegan en la semana 5. Pero sí podemos resolver el caso de un número de 8 bits repitiendo los dos pasos ocho veces:
// to_binary.c (extracto; el archivo tiene las ocho repeticiones)
int n = 0;
// Mostramos cuántos datos leyó scanf. Con if, la próxima semana, ya podremos reaccionar.
int read_count = scanf("%d", &n);
printf("scanf leyó %d dato(s)\n", read_count);

int b0 = n % 2;
n = n / 2;
int b1 = n % 2;
n = n / 2;
// ... lo mismo para b2, b3, b4, b5 y b6 ...
int b7 = n % 2;

// El primer resto es el bit de menor peso: se escribe al final.
printf("%d%d%d%d%d%d%d%d\n", b7, b6, b5, b4, b3, b2, b1, b0);
$ echo 202 | build/to_binary
scanf leyó 1 dato(s)
11001010Dos cosas nuevas en esa orden. echo escribe lo que le piden, y la barra | conecta
su salida con la entrada del programa, sin que tengamos que escribir el número con el
teclado. Es parecido al < de la semana pasada, pero con otro programa en lugar de un
archivo.
En C. El programa escribe cuántos datos leyó
scanf, porquescanfpuede fallar. Con la entradaholaescribescanf leyó 0 dato(s)y sigue connen 0. Eso es lo más que podemos hacer hoy. Si la entrada se termina antes de leer algo,scanfdevuelveEOF, que en nuestro entorno es -1, como vieron la semana pasada, y el programa escribescanf leyó -1 dato(s). Reaccionar a esos errores, por ejemplo terminando el programa con un mensaje, requiereif, y lo veremos la próxima semana. También falta rechazar un número mayor que 255: el programa daría solo sus 8 bits más bajos.
De binario a decimal
Leer 11001010 sumando pesos es cómodo a mano. Para un programa hay una forma mejor:
se recorre el número de izquierda a derecha y, por cada bit, se duplica lo acumulado y
se le suma el bit. para repite el bloque una vez por cada valor de i. Aquí n es la
cantidad de bits, y devolver entrega el resultado del algoritmo.
algoritmo binario_a_decimal(n)
    valor ← 0
    para i desde 0 hasta n - 1 hacer
        leer bit
        valor ← valor * 2 + bit
    fin para
    devolver valor
fin algoritmo
Sigámoslo con 10110110:
| Bit leído | Cálculo | valor |
|---|---|---|
| 1 | 0 × 2 + 1 | 1 |
| 0 | 1 × 2 + 0 | 2 |
| 1 | 2 × 2 + 1 | 5 |
| 1 | 5 × 2 + 1 | 11 |
| 0 | 11 × 2 + 0 | 22 |
| 1 | 22 × 2 + 1 | 45 |
| 1 | 45 × 2 + 1 | 91 |
| 0 | 91 × 2 + 0 | 182 |
En C, otra vez sin ciclos, ocho veces lo mismo. El formato %1d le pide a scanf un
solo dígito, así que 10110110 no se lee como un número grande sino como ocho datos:
// from_binary.c (extracto; el par de líneas se repite ocho veces)
// %1d lee un solo dígito. scanf devuelve 1 cada vez que lo logra.
read_count = read_count + scanf("%1d", &bit);
value = value * 2 + bit;
// ... siete veces más ...

printf("scanf leyó %d dígitos\n", read_count);
printf("decimal: %d\n", value);
printf("hexadecimal: %x\n", value);
$ echo 10110110 | build/from_binary
scanf leyó 8 dígitos
decimal: 182
hexadecimal: b6Ese programa no comprueba que cada dígito sea 0 o 1: si recibe 2, lo usa igual. Tampoco
controla que lleguen los ocho. Con la entrada 101, las cinco lecturas que fallan devuelven
-1, y el total deja de contar dígitos: escribe scanf leyó -2 dígitos, y su decimal no
sirve. Para detectar estos casos también hace falta if.
Hexadecimal: base 16
El binario es lo que hay en la máquina, pero es incómodo para las personas: 11001010
se lee mal y es fácil perder un dígito. El hexadecimal resuelve esto. Es base 16, y
como solo tenemos diez dígitos, se agregan seis letras:
| Hex | Decimal | Binario | Hex | Decimal | Binario | |
|---|---|---|---|---|---|---|
| 0 | 0 | 0000 | 8 | 8 | 1000 | |
| 1 | 1 | 0001 | 9 | 9 | 1001 | |
| 2 | 2 | 0010 | a | 10 | 1010 | |
| 3 | 3 | 0011 | b | 11 | 1011 | |
| 4 | 4 | 0100 | c | 12 | 1100 | |
| 5 | 5 | 0101 | d | 13 | 1101 | |
| 6 | 6 | 0110 | e | 14 | 1110 | |
| 7 | 7 | 0111 | f | 15 | 1111 |
Lo útil es esto: como 16 = 2⁴, un dígito hexadecimal equivale exactamente a 4 bits. Para convertir, se agrupan los bits de cuatro en cuatro desde la derecha y se reemplaza cada grupo:
1100 1010
   c    a
Así, 11001010 en binario es ca en hexadecimal. Un byte siempre son dos dígitos
hexadecimales, y por eso las herramientas que muestran bytes usan esta base.
Para volver a decimal se usa la misma regla posicional, con pesos 16 y 1:
ca vale 12 × 16 + 10 × 1 = 202. Y el mismo algoritmo de divisiones sirve para pasar
de decimal a hexadecimal, dividiendo entre 16: 202 entre 16 da cociente 12 (c) y
resto 10 (a).
En C, un número escrito en el código que empieza con 0x está en hexadecimal, y printf escribe en esa
base con %x (minúsculas) o %X (mayúsculas):
// bases.c (extracto)
int n = 202;
int m = 0xCA;  // 0x indica que el literal está en hexadecimal

printf("%x en hexadecimal, con minúsculas\n", n);
printf("0xCA vale %d\n", m);
$ build/bases
202 en decimal
ca en hexadecimal, con minúsculas
CA en hexadecimal, con mayúsculas
0xCA vale 202Las variables n y m guardan exactamente lo mismo. La base es solo la forma de
escribir el número, no algo que quede guardado en la variable.
Error común. Creer que un número “está en hexadecimal” dentro de la variable. En memoria siempre hay bits. Decimal y hexadecimal son dos maneras de mostrarlos.
Bytes y múltiplos
Para cantidades grandes se usan múltiplos, y aquí hay una confusión muy extendida. Hay dos familias: la decimal, con potencias de 1000, y la binaria, con potencias de 1024.
| Decimal | Bytes | Binario | Bytes |
|---|---|---|---|
| 1 kB (kilobyte) | 1000 | 1 KiB (kibibyte) | 1024 |
| 1 MB (megabyte) | 1000² | 1 MiB (mebibyte) | 1024² |
| 1 GB (gigabyte) | 1000³ | 1 GiB (gibibyte) | 1024³ |
Muchos fabricantes de discos usan la familia decimal, y varios programas informan la binaria aunque escriban “GB”. Por eso un disco de 500 GB aparece como unos 465.66 GiB: son los mismos 500 000 000 000 bytes, divididos entre 1024³. No falta espacio. Cuando leamos en este curso “kB” o “KiB”, significan lo que dice esta tabla.
Otra confusión común: b minúscula es bit y B mayúscula es byte. Las velocidades de conexión se suelen dar en megabits por segundo (Mbps). Un plan de 100 Mbps transfiere como máximo 12.5 MB por segundo, porque un byte tiene 8 bits.
Cuánto ocupa cada tipo
Este programa lo muestra en nuestro entorno. Agrega limits.h, un archivo estándar
que define los límites de los tipos, y usa el formato %zu, que es el que corresponde
al resultado de sizeof.
// sizes.c (extracto)
printf("sizeof(int)    = %zu\n", sizeof(int));
printf("INT_MAX = %d\n", INT_MAX);
printf("INT_MIN = %d\n", INT_MIN);
$ build/sizes
bits en un byte: 8
sizeof(char) = 1
sizeof(int) = 4
sizeof(double) = 8
INT_MAX = 2147483647
INT_MIN = -2147483648sizeof(char) es 1 por definición, en todas las plataformas. Los otros tamaños
dependen de la plataforma: C solo garantiza que un int tenga al menos 16 bits. En las
computadoras actuales lo habitual, y lo que tenemos en el entorno del curso, es que
ocupe 4 bytes, es decir, 32 bits. Enseguida veremos de dónde salen los dos límites.
Enteros con signo y complemento a dos
Sin signo
Con 8 bits hay 256 combinaciones. Si todas representan números no negativos, el rango
va de 00000000 (0) a 11111111 (255). Es la lectura que venimos usando. En C, este
tipo se llama unsigned char, y lo usaremos en este capítulo.
Una primera idea que no funciona bien
¿Y los negativos? Lo primero que se nos ocurre es reservar el bit de la izquierda para
el signo: 0 para positivo y 1 para negativo. Así, 00000011 sería 3 y 10000011 sería
-3. Tiene dos problemas. Primero, hay dos ceros: 00000000 y 10000000. Segundo, la suma
común y corriente da un resultado equivocado: 3 + (-3) daría 10000110, que sería -6.
Complemento a dos
La solución usada en las computadoras actuales es el complemento a dos (two’s complement). La idea es simple: el bit de la izquierda tiene peso negativo. Con 8 bits los pesos son:
| Peso | -128 | 64 | 32 | 16 | 8 | 4 | 2 | 1 |
|---|
Todo lo demás se lee igual que siempre. Veamos los ocho bits de 11111101:
-128 + 64 + 32 + 16 + 8 + 4 + 1 = -3.
Con 4 bits, los pesos son -8, 4, 2 y 1, y se pueden mostrar todos los valores:
| Bits | Valor | Bits | Valor | |
|---|---|---|---|---|
| 0000 | 0 | 1000 | -8 | |
| 0001 | 1 | 1001 | -7 | |
| 0010 | 2 | 1010 | -6 | |
| 0011 | 3 | 1011 | -5 | |
| 0100 | 4 | 1100 | -4 | |
| 0101 | 5 | 1101 | -3 | |
| 0110 | 6 | 1110 | -2 | |
| 0111 | 7 | 1111 | -1 |
Miren lo que muestra la tabla:
- Hay un solo cero.
- Si el bit de la izquierda es 1, el número es negativo.
1111es -1, con cualquier cantidad de bits: el peso negativo es uno más que la suma de todos los demás.- El rango no es simétrico. Con 4 bits va de -8 a 7, porque el 0 ocupa uno de los lugares del lado no negativo.
En general, con n bits el rango va de -2ⁿ⁻¹ a 2ⁿ⁻¹ - 1. Con 8 bits, de -128 a 127.
Con 32 bits, de -2147483648 a 2147483647, los valores de INT_MIN e INT_MAX que
imprimió sizes.
Cómo cambiar el signo: invertir y sumar 1
Para obtener -x a partir de x: se invierten todos los bits y se suma 1. Con -3 en 8 bits:
| Paso | Bits |
|---|---|
| 3 | 00000011 |
| Invertir | 11111100 |
| Sumar 1 | 11111101 |
¿Por qué funciona? Si se suma un número con su versión invertida, todas las posiciones
dan 1, y 11111111 es -1. O sea, x + invertido(x) = -1. Despejando, invertido(x) + 1 = -x.
Hay un caso especial. Si lo aplican a -128 (10000000), invierten a 01111111, suman 1 y
vuelven a 10000000. No es un error del método: +128 no existe en 8 bits.
Por qué conviene: la suma es la misma
La ventaja principal es que el circuito que suma no necesita saber si hay negativos. Suma en binario como siempre, y el acarreo que no cabe se descarta. Veamos 5 + (-3):
   00000101     5
 + 11111101    -3
 ----------
 1 00000010     2
El 1 de la izquierda no cabe en 8 bits y se pierde. Lo que queda es 2, el resultado
correcto. Por eso restar se reduce a sumar el negativo. Volveremos a esto al ver las
compuertas lógicas y el sumador.
Del número a sus bits
Un número en complemento a dos de 8 bits también se puede ver como un número sin signo.
Si x es negativo, sus bits leídos sin signo valen x + 256. Por ejemplo, -3 da 253, y
253 en binario es 11111101.
algoritmo patron_8_bits(x)
    si x < 0 entonces
        devolver x + 256
    sino
        devolver x
    fin si
fin algoritmo
En C todavía no tenemos if, pero el resto da el mismo resultado sin él:
(x + 256) % 256. Para x = -3 calcula 253 % 256 = 253; para x = 5 calcula 261 % 256 = 5.
Después se escriben los bits, dividiendo entre los pesos: pattern / 128 % 2 es el bit
de peso 128, y así con los demás. Recuerden que / y % tienen la misma precedencia y
se evalúan de izquierda a derecha.
// twos_complement.c (extracto)
// Sin if: si x es negativo da x + 256; si no, da x. Solo vale de -128 a 127.
int pattern = (x + 256) % 256;

printf("%d en 8 bits: %d%d%d%d%d%d%d%d\n", x,
       pattern / 128 % 2, pattern / 64 % 2, pattern / 32 % 2, pattern / 16 % 2,
       pattern / 8 % 2, pattern / 4 % 2, pattern / 2 % 2, pattern % 2);
// %x espera un valor sin signo: por eso el cast. Es el int completo, de 32 bits.
printf("%d en un int: %08x\n", x, (unsigned int) x);
$ echo -3 | build/twos_complement
scanf leyó 1 dato(s)
-3 en 8 bits: 11111101
-3 en un int: fffffffd
$ echo -1 | build/twos_complement
scanf leyó 1 dato(s)
-1 en 8 bits: 11111111
-1 en un int: ffffffff
$ echo 127 | build/twos_complement
scanf leyó 1 dato(s)
127 en 8 bits: 01111111
127 en un int: 0000007f%08x significa hexadecimal, con 8 dígitos como mínimo y rellenando con ceros a la
izquierda. Fíjense en que ffffffff son 32 unos: -1 en un int.
En C.
%xespera un valorunsigned int, un entero sin signo del mismo tamaño queint. Por eso se hace la conversión (cast)(unsigned int) x. C define esa conversión: suma 2³² a un negativo, y el resultado tiene justamente los bits del complemento a dos. Pasar unintnegativo directamente a%xno es correcto, aunque el compilador no lo señale con las opciones que usamos. Unintpositivo, como 202, sí se puede pasar.
En C. El estándar C17 todavía admite otras representaciones de los negativos, aunque ninguna computadora actual las usa en la práctica. El gcc de nuestro entorno usa complemento a dos, y el estándar siguiente, C23, ya lo exige.
Overflow
La idea: el odómetro
Piensen en el contador de kilómetros de un carro antiguo, con 6 dígitos. Después de
999999 vuelve a 000000: el resultado real no cabe. Pasa lo mismo con los bits. Un
overflow es un resultado que no cabe en el tipo que debe guardarlo.
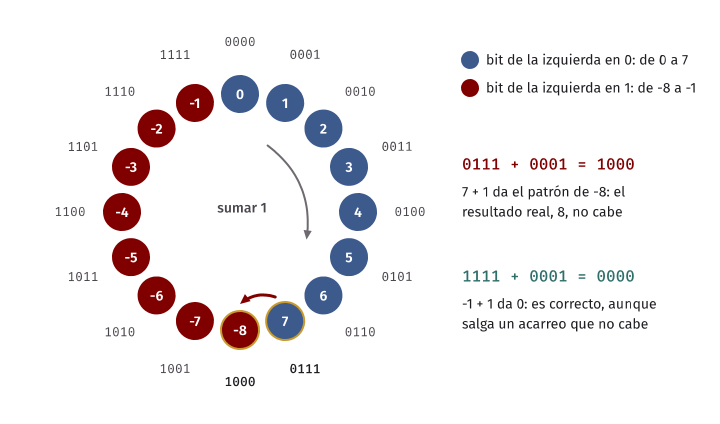
Con 8 bits en complemento a dos, sumemos 127 + 1 a nivel de bits:
   01111111    127
 + 00000001      1
 ----------
   10000000   -128
El circuito suma correctamente, pero el patrón que resulta es el de -128. Sumando dos positivos salió un negativo. Eso es lo que hace el hardware.
En C, el overflow con signo es comportamiento indefinido
Aquí hay que tener cuidado, porque la regla de C no es “da la vuelta”. En C, el overflow de un entero con signo es comportamiento indefinido (undefined behavior). Quiere decir que el estándar no dice qué debe pasar: no promete un resultado ni un error. El compilador tiene derecho a suponer que eso nunca ocurre y a generar su código a partir de esa suposición. Un programa con comportamiento indefinido puede parecer correcto hoy y dar otro resultado mañana, con otra versión del compilador o con otras opciones.
Para detectarlo tenemos el sanitizer de comportamiento indefinido, UBSan. Es una
ayuda que gcc agrega al ejecutable con la opción -fsanitize=undefined: el programa
revisa las operaciones mientras corre y avisa si encuentra un problema. Las opciones de
nuestro Makefile lo incluyen, junto con address, que vigila la memoria.
// Suma 1 a un int leído con scanf. Con INT_MAX se produce overflow.
#include <stdio.h>

int main(void) {
    int n = 0;
    int read_count = scanf("%d", &n);
    printf("scanf leyó %d dato(s), n = %d\n", read_count, n);

    int next = n + 1;
    printf("n + 1 = %d\n", next);
    return 0;
}
Con un valor normal no pasa nada especial. Con el mayor int posible:
$ echo 41 | build/overflow
scanf leyó 1 dato(s), n = 41
n + 1 = 42
$ echo 2147483647 | build/overflow
scanf leyó 1 dato(s), n = 2147483647
overflow.c:9:9: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
n + 1 = -2147483648
Leamos el mensaje por partes:
| Parte | Significado |
|---|---|
overflow.c:9:9 |
Archivo, línea y columna |
runtime error |
Error de ejecución, no de compilación |
signed integer overflow |
Overflow de un entero con signo |
2147483647 + 1 cannot be represented in type 'int' |
Esa suma no cabe en un int |
Error común. Ver
n + 1 = -2147483648y concluir que “en C elintda la vuelta”. Ese valor es lo que salió en esta ejecución, en esta máquina, con estas opciones. Sin el sanitizer no hay ningún mensaje, y C no garantiza ese número ni ningún otro. El error ya ocurrió al calcular la suma. Lo que se imprime después no sirve.
Por qué se lee con scanf
Si el valor está escrito en el código, el compilador hace la cuenta al compilar y avisa:
$ gcc -Wall -Wextra -std=c17 bad/constant_overflow.c -o build/constant_overflow
bad/constant_overflow.c: In function ‘main’:
bad/constant_overflow.c:6:24: warning: integer overflow in expression of type ‘int’ results in ‘-2147483648’ [-Woverflow]
    6 |     int next = INT_MAX + 1;
      |                        ^
UBSan, en cambio, trabaja mientras el programa corre, y en este caso no tiene nada que
vigilar: la suma ya no existe en el ejecutable. Compilado con -fsanitize=undefined, ese
programa no da ningún mensaje al ejecutarse. Por eso, para ver el sanitizer en acción, el
valor tiene que llegar en la ejecución. scanf hace justamente eso.
También hay un límite en la lectura misma. Si escriben un número que no cabe en un int,
como 2147483648, C tampoco define qué guarda scanf. Es otra razón para probar con
2147483647, que sí cabe.
En C. Al programa le falta algo: con la entrada
hola,scanfno lee nada y escribescanf leyó 0 dato(s), n = 0. Hoy no podemos hacer más que mostrarlo. Y por haber inicializadonen 0, al menos no usamos una variable sin valor. La próxima semana, conif, el programa va a poder detenerse en ese caso, y también comprobar antes de sumar si la suma cabe.
Los tipos sin signo sí dan la vuelta
Los enteros sin signo tienen otra regla: C define que su aritmética da la vuelta, módulo 2ⁿ. Aquí es correcto hablar de “dar la vuelta” y no hay nada indefinido:
// unsigned_wrap.c (extracto)
unsigned char b = 255;
printf("b = %d\n", b);
b = b + 1;
printf("b = %d\n", b);
$ build/unsigned_wrap
b = 255
b = 0El orden importa. En b = b + 1, la suma se hace como int y da 256. Al guardarla en el
unsigned char se reduce módulo 256, y queda 0.
No es un problema teórico
- El año 2038. Muchos sistemas contaron el tiempo como segundos desde el 1 de enero de 1970 en un entero de 32 bits con signo. Ese contador llega a su máximo, 2147483647, el 19 de enero de 2038. Los sistemas actuales están pasando a 64 bits por esto.
- Ariane 5. En 1996, en su vuelo inaugural, este cohete se destruyó segundos después del despegue. Su software convertía un valor de punto flotante a un entero de 16 bits con signo, y el valor no cabía.
Idea clave. Un
inttiene un máximo. Antes de multiplicar o de acumular, piensen si el resultado cabe. Si puede no caber, el programa está mal aunque hoy pase sus pruebas.
Punto flotante
Decimales en binario
La regla posicional también funciona a la derecha del punto. En decimal, las posiciones valen 1/10, 1/100, 1/1000. En binario valen 1/2, 1/4, 1/8, 1/16. Por ejemplo:
| Binario | Cálculo | Decimal |
|---|---|---|
0.1 |
1/2 | 0.5 |
0.01 |
1/4 | 0.25 |
0.11 |
1/2 + 1/4 | 0.75 |
Hasta aquí todo es exacto. Pero en decimal ya conocemos números que no terminan: 1/3 es
0.3333..., porque 3 no divide a ninguna potencia de 10. Con el binario pasa lo mismo,
y con números que en decimal se ven inocentes. 0.1 no tiene escritura finita en binario.
Cómo sacar los bits de 0.1
Se duplica el número una y otra vez. Cada vez, la parte entera, 0 o 1, es el siguiente bit, y se sigue trabajando solo con la parte fraccionaria.
algoritmo fraccion_a_binario(x, k)
    para i desde 0 hasta k - 1 hacer
        x ← x * 2
        si x < 1 entonces
            escribir 0
        sino
            escribir 1
            x ← x - 1
        fin si
    fin para
fin algoritmo
x al empezar |
x * 2 |
Bit escrito | x queda en |
|---|---|---|---|
| 0.1 | 0.2 | 0 | 0.2 |
| 0.2 | 0.4 | 0 | 0.4 |
| 0.4 | 0.8 | 0 | 0.8 |
| 0.8 | 1.6 | 1 | 0.6 |
| 0.6 | 1.2 | 1 | 0.2 |
| 0.2 | 0.4 | 0 | 0.4 |
En la sexta fila volvemos a 0.2, igual que en la segunda. A partir de ahí se repite
sin fin: 0.1 en binario es 0.0001100110011..., con el grupo 0011 repitiéndose.
Sin if todavía, en C el bit se obtiene con el cast (int) x, que descarta los decimales:
// fraction_to_binary.c (extracto; se repite para los 9 bits)
double x = 0.0;
int read_count = scanf("%lf", &x);
printf("scanf leyó %d dato(s)\n", read_count);

// Cada paso duplica x. La parte entera, 0 o 1, es el bit; el cast la obtiene.
x = x * 2;
int b1 = (int) x;
x = x - b1;
// ... lo mismo para b2 a b9 ...
$ echo 0.1 | build/fraction_to_binary
scanf leyó 1 dato(s)
0.000110011...El formato %lf es el que scanf usa para leer un double.
Qué es un double
Como la memoria es finita, hay que cortar en algún punto. En nuestro entorno y en casi todas
las computadoras actuales, un double usa 64 bits, con un formato llamado IEEE 754. C no lo
exige, pero es lo que encontrarán. Guarda el número como en la notación científica, en base 2:
número = signo × 1.xxxxx (en binario) × 2^exponente| Parte | Bits | Para qué |
|---|---|---|
| Signo | 1 | Positivo o negativo |
| Exponente | 11 | Dónde cae el punto (de ahí “punto flotante”) |
| Mantisa | 52 | Los dígitos xxxxx después del 1. |
Tres consecuencias:
- Un
doubleconserva unas 15 a 17 cifras decimales significativas. - Llega a números enormes, de unos 308 dígitos. Lo que tiene de alcance no lo tiene de precisión: no puede guardar con todas sus cifras un número tan grande.
- Solo algunos números se guardan exactamente: los que son una suma finita de potencias
de 2 y caben en esos bits. 0.5, 0.25 y 0.75 sí. 0.1, 0.2 y 0.3 no. Para esos se guarda
el
doublemás cercano.
Por qué 0.1 + 0.2 no da 0.3
Con %.20f pedimos 20 decimales, y se empieza a ver lo que realmente está guardado:
// float_sum.c (extracto)
double a = 0.1;
double b = 0.2;
double c = 0.3;
double sum = a + b;

printf("0.1 + 0.2 = %.20f\n", sum);
printf("diferencia = %.20f\n", sum - c);
// Una comparación vale 1 si es verdadera y 0 si es falsa.
printf("sum == c vale %d\n", sum == c);
$ build/float_sum
con %f: 0.300000
0.1 = 0.10000000000000000555
0.2 = 0.20000000000000001110
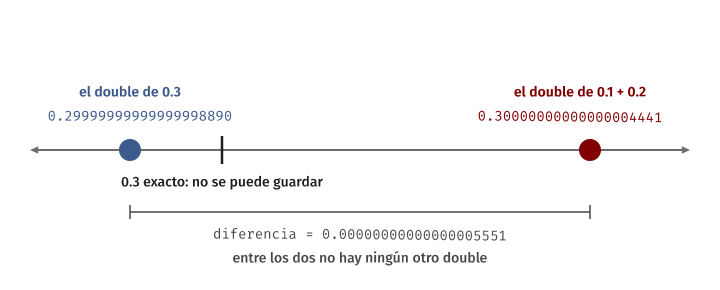
0.3 = 0.29999999999999998890
0.1 + 0.2 = 0.30000000000000004441
diferencia = 0.00000000000000005551
sum == c vale 0Sigamos lo que pasó:
- El
doublemás cercano a 0.1 es un poco mayor que 0.1. El de 0.2, también. - Al sumarlos, el resultado exacto tampoco cabe, así que se redondea a un
doublevecino. Aquí cae justo en medio de dos, y una regla de desempate elige el de arriba. - Ese
doubleno es el más cercano a 0.3. Son dos valores vecinos, y no hay ningún otrodoubleentre ellos.
La primera línea explica por qué esto pasa desapercibido: %f escribe solo 6 decimales
y redondea, y entonces parece 0.3.
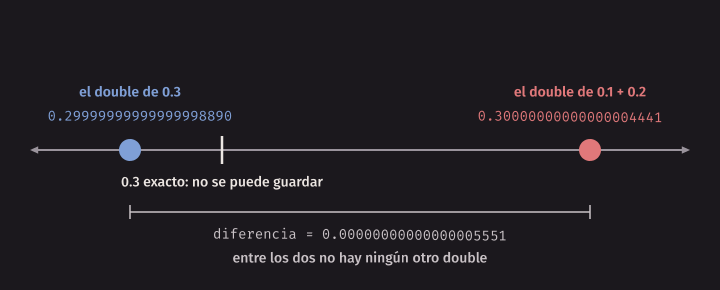
Esto no es un bug de C ni de gcc. Es la consecuencia de guardar en binario y en una
cantidad fija de bits. Cualquier lenguaje que use double da lo mismo.
Idea clave. Un
doublees casi siempre una aproximación. El error es muy pequeño, pero existe, y las operaciones lo arrastran.
Error común: comparar double con ==
La línea sum == c vale 0 usa un operador que adelantamos: == compara dos valores, y = asigna. Una comparación en C vale 1 si
es verdadera y 0 si es falsa. La usaremos en serio con if, la próxima semana. Aquí nos
muestra que para C 0.1 + 0.2 y 0.3 son valores distintos.
Error común. Comparar dos
doublecon==. Los números que “deberían” ser iguales rara vez coinciden en todos sus bits.
Lo correcto es preguntar si están suficientemente cerca: si el valor absoluto de la
diferencia es menor que una tolerancia. fabs es de math.h, y por eso se compila con -lm:
// compare_doubles.c (extracto)
double sum = 0.1 + 0.2;
double target = 0.3;
double tolerance = 0.000000001;

printf("sum == target vale %d\n", sum == target);
printf("fabs(sum - target) < tolerance vale %d\n", fabs(sum - target) < tolerance);
$ build/compare_doubles
sum == target vale 0
fabs(sum - target) < tolerance vale 1La tolerancia se elige según el problema. Una de 0.000000001 tiene sentido con
valores cercanos a 1, pero no con números de mil millones, donde los errores son mayores.
Los errores se acumulan y la precisión se acaba
Tres líneas más sobre lo que un double puede y no puede hacer, de float_limits.c:
$ build/float_limits
0.5 + 0.25     = 0.75000000000000000000
diez veces 0.1 = 0.99999999999999988898
big            = 9007199254740992.0
big + 1        = 9007199254740992.0
La primera línea es exacta, como esperábamos. En la segunda, los errores pequeños se van
sumando. En las dos últimas, big vale 2⁵³. A partir de ahí, los 52 bits de la mantisa ya
no alcanzan para distinguir enteros consecutivos, y sumar 1 no cambia nada.
El dinero se guarda en céntimos
Si un error de 0.00000000000000005 parece inofensivo, piensen en una cuenta que debe quedar
exactamente en cero. La solución habitual es no usar decimales: en vez de guardar soles, se
guardan céntimos en un int. Los enteros son exactos mientras no haya overflow.
// money.c (extracto)
int price_cents = 110;
int total_cents = price_cents * 3;
printf("3 x 110 céntimos:    %d\n", total_cents);
printf("en soles:            S/ %d.%02d\n", total_cents / 100, total_cents % 100);
$ build/money
3 x 1.10 con double: 3.30000000000000026645
lo mismo con %.2f: 3.30
saldo con double: 0.00000000000000013878
3 x 110 céntimos: 330
en soles: S/ 3.30
saldo en céntimos: 0El saldo empieza en un sol y se le restan diez veces 10 céntimos. Con double no llega a
cero. Con int, sí. Para mostrar el monto, total_cents / 100 da los soles y
total_cents % 100 los céntimos. El formato %02d escribe al menos 2 dígitos, rellenando
con ceros: 5 céntimos se ven como 05, y no como 5, que se leería como 50 céntimos.
Esta forma también tiene un límite. Un int de 32 bits llega a 2147483647 céntimos, es
decir, S/ 21 474 836.47. Para una cuenta personal alcanza. Para un banco se usaría un
entero más grande.
char es un número pequeño: ASCII
Un char ocupa un byte, y lo que guarda es un número. Para que ese número represente una
letra, hace falta una tabla que asigne un número a cada carácter. La tabla básica es
ASCII, de la década de 1960. Usa 7 bits, así que define 128 códigos, del 0 al 127:
| Caracteres | Códigos |
|---|---|
Salto de línea (\n) |
10 |
| Espacio | 32 |
'0' a '9' |
48 a 57 |
'A' a 'Z' |
65 a 90 |
'a' a 'z' |
97 a 122 |
Hay un orden pensado: las letras son consecutivas, y cada minúscula está 32 lugares después de su mayúscula. Por eso se puede hacer aritmética con caracteres:
// char_codes.c (extracto)
char letter = 'A';
char digit = '7';

printf("%c tiene el código %d\n", letter, letter);
printf("%c tiene el código %d\n", letter + 1, letter + 1);
printf("'a' - 'A' = %d\n", 'a' - 'A');
printf("minúscula de %c: %c\n", letter, letter + 32);
printf("%c tiene el código %d\n", digit, digit);
printf("'7' - '0' = %d\n", digit - '0');
$ build/char_codes
A tiene el código 65
B tiene el código 66
'a' - 'A' = 32
minúscula de A: a
7 tiene el código 55
'7' - '0' = 7Error común. Confundir el carácter
'7'con el número 7. Elcharguarda el código 55. Para obtener el valor del dígito, se resta'0'. Y las comillas importan:'A'es un carácter, un número en el fondo, mientras que"A"es otra cosa, que veremos al estudiar las cadenas.
En C. C no dice si
chara secas tiene signo: lo decide cada plataforma. Entre 0 y 127 no hay diferencia, y por eso ASCII funciona igual en todas partes. Pero un byte de 128 o más se ve distinto. Este programa,char_sign.c, lee un byte y lo muestra de dos maneras. Le pasamos el texto conprintfen la terminal, que a diferencia deechono agrega salto de línea:$ printf "ñ" | build/char_sign scanf leyó 1 dato(s) CHAR_MIN = 0, CHAR_MAX = 255 como char: 195 como unsigned char: 195Esa salida es de Linux sobre un procesador ARM, donde se prepararon estos apuntes. En Linux sobre un procesador x86-64, como el de GitHub Codespaces,
chartiene signo. Con la opción-fsigned-chardegccse puede ver ese caso en cualquier máquina:$ gcc -Wall -Wextra -std=c17 -fsigned-char char_sign.c -o build/char_sign_signed $ printf "ñ" | build/char_sign_signed scanf leyó 1 dato(s) CHAR_MIN = -128, CHAR_MAX = 127 como char: -61 como unsigned char: 195Es el mismo byte, leído con otro tipo. Si les interesa el valor de un byte de 128 o más, usen
unsigned char.
Unicode y UTF-8
Carácter, código y byte
ASCII alcanza para el inglés, pero no incluye la ñ ni la á. Durante años, cada región
usó sus propias tablas de un byte para los códigos del 128 al 255. La tabla Latin-1, por
ejemplo, ponía la ñ en el 241, mientras que otras tablas tenían otro carácter en ese
lugar. Un mismo archivo se veía distinto en cada computadora.
Unicode resolvió esto con una sola tabla para todos los sistemas de escritura. Conviene separar tres ideas que se suelen mezclar:
| Concepto | Qué es | Ejemplo |
|---|---|---|
| Carácter | La letra o el símbolo, como idea | la letra ñ |
| Código (code point) | El número que Unicode le asigna, escrito U+ y en hexadecimal |
U+00F1, que es 241 |
| Bytes | Cómo se guarda ese número en un archivo o en memoria | c3 b1 en UTF-8 |
Unicode define las dos primeras columnas. La tercera la define una codificación. La que se usa casi siempre hoy es UTF-8.
Cómo guarda UTF-8 un código
UTF-8 usa de 1 a 4 bytes, según el tamaño del código:
| Rango de códigos | Bytes | Patrón de bits |
|---|---|---|
U+0000 a U+007F (0 a 127) |
1 | 0xxxxxxx |
U+0080 a U+07FF (128 a 2047) |
2 | 110xxxxx 10xxxxxx |
U+0800 a U+FFFF (2048 a 65535) |
3 | 1110xxxx 10xxxxxx 10xxxxxx |
U+10000 a U+10FFFF |
4 | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
Las x son los bits del código. Todo lo demás marca la estructura: el primer byte dice
cuántos bytes tiene el carácter, y los siguientes siempre empiezan con 10.
La ñ, a mano
- El código de la
ñesU+00F1, que es 241. Es mayor que 127 y menor que 2048: usa 2 bytes. - 241 en binario es
11110001. El patrón de 2 bytes tiene 11 lugares para bits, así que completamos con ceros a la izquierda:00011110001. - Repartimos: los 5 primeros van al primer byte y los 6 últimos al segundo.
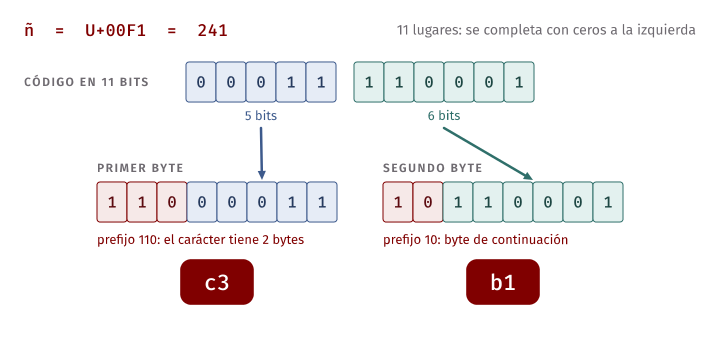
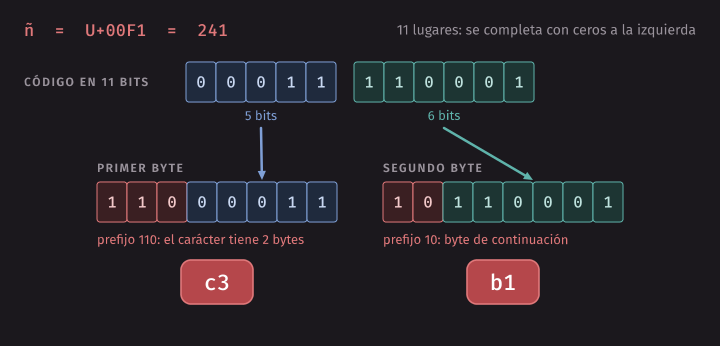
La ñ se guarda como c3 b1. La n, cuyo código 110 está en el rango de ASCII, usa un
solo byte: 6e. Por eso la ñ ocupa 2 bytes y la n ocupa 1.
Tomar los 6 bits de abajo es lo mismo que calcular el resto entre 64, y los bits de arriba
son el cociente. En cuanto a los prefijos, 110 seguido de 5 ceros vale 192, y 10 seguido
de 6 ceros vale 128. Así se calcula sin mirar los bits uno por uno:
algoritmo dos_bytes_utf8(codigo)
    primero ← 192 + codigo div 64
    segundo ← 128 + codigo mod 64
    escribir primero, segundo
fin algoritmo
// utf8_two_bytes.c (extracto)
// Sin if no podemos rechazar otros códigos: fuera del rango, el resultado no sirve.
int first = 192 + code / 64; // 110xxxxx: los 5 bits altos
int second = 128 + code % 64; // 10xxxxxx: los 6 bits bajos
printf("bytes: %x %x\n", first, second);
printf("carácter: %c%c\n", first, second);$ echo 241 | build/utf8_two_bytes
scanf leyó 1 dato(s)
bytes: c3 b1
carácter: ñ
$ echo 233 | build/utf8_two_bytes
scanf leyó 1 dato(s)
bytes: c3 a9
carácter: éEse programa solo sirve para códigos de 128 a 2047. Elegir el patrón según el rango de la
tabla es trabajo para if.
Mirar los bytes de verdad
xxd es un programa que muestra los bytes de un archivo. Creemos un archivo con la palabra
año. Usamos year.txt, porque los nombres de archivo van sin ñ en este curso:
$ echo "año" > year.txt
$ xxd year.txt
00000000: 61c3 b16f 0a                             a..o.
$ wc -c year.txt
5 year.txt
Cómo se lee la línea de xxd:
| Columna | Contenido |
|---|---|
00000000: |
Posición del primer byte de la línea, en hexadecimal |
61c3 b16f 0a |
Los bytes, en hexadecimal, en grupos de dos |
a..o. |
Los mismos bytes como texto; un punto indica un byte que no es un carácter ASCII visible |
Los bytes son 61 (a), c3 b1 (ñ), 6f (o) y 0a. Este último es el salto de línea, el
código 10, que echo agrega al final. Son 3 caracteres visibles, y 5 bytes en total, como dice
wc -c, que cuenta bytes.
Dos caracteres más, mirados del mismo modo. El último 0a de cada línea sigue siendo el salto
de línea de echo, no parte del carácter:
$ echo "€" | xxd
00000000: e282 ac0a                                ....
$ echo "😀" | xxd
00000000: f09f 9880 0a .....| Carácter | Código | Bytes en UTF-8 | Cuántos |
|---|---|---|---|
n |
U+006E |
6e |
1 |
ñ |
U+00F1 |
c3 b1 |
2 |
€ |
U+20AC |
e2 82 ac |
3 |
| 😀 | U+1F600 |
f0 9f 98 80 |
4 |
Por lo mismo, un archivo puede tener 5 caracteres y 7 bytes. La palabra ñandú tiene dos
caracteres de 2 bytes y tres de 1 byte:
$ echo "ñandú" | xxd
00000000: c3b1 616e 64c3 ba0a                      ..and...
Sin contar el salto de línea final, son 7 bytes.
Idea clave. Número de caracteres y número de bytes no son lo mismo. Un texto en ASCII coincide, y por eso es fácil no notar la diferencia. Con
ñy tildes deja de coincidir.
UTF-8 tiene una ventaja que explica por qué se impuso: todo texto ASCII ya es UTF-8 válido, con los mismos bytes. Los programas viejos siguieron funcionando.
Cuando los bytes se leen con la tabla equivocada
Si un programa lee bytes UTF-8 como si fueran Latin-1, cada byte se toma como un carácter
aparte. iconv convierte de una codificación a otra, y aquí le decimos a propósito que el
archivo está en Latin-1, aunque no sea cierto:
$ iconv -f latin1 -t utf8 year.txt
año
Seguramente ya vieron algo así en un correo o en una página web. No es un archivo dañado:
c3 en Latin-1 es à y b1 es ±. Los bytes están bien; la tabla es la equivocada.
La ñ no cabe en un char
Como la ñ son dos bytes en UTF-8, no cabe en un char. Si lo intentan, gcc avisa:
$ gcc -Wall -Wextra -std=c17 bad/char_enye.c -o build/char_enye
bad/char_enye.c: In function ‘main’:
bad/char_enye.c:5:14: warning: multi-character character constant [-Wmultichar]
    5 |     char c = 'ñ';
      |              ^~~
bad/char_enye.c:5:14: warning: unsigned conversion from ‘int’ to ‘char’ changes value from ‘50097’ to ‘177’ [-Woverflow]
Lean la primera advertencia: dentro de las comillas simples hay más de un carácter, pues el
compilador ve dos bytes. La segunda es que 50097 (c3b1 en hexadecimal) no cabe en un char,
y queda solo 177 (b1), que no es un carácter válido por sí solo. Esta segunda línea
depende de la plataforma: donde char tiene signo, el mensaje es otro.
%c tampoco lee “un carácter”, sino un byte. Este programa lee los primeros 4 bytes de
la entrada. Con año, esos 4 bytes son 3 caracteres:
// read_bytes.c (extracto)
int read_count = scanf("%c%c%c%c", &b0, &b1, &b2, &b3);
printf("scanf leyó %d byte(s)\n", read_count);
// El cast evita que un byte de 128 o más se vea negativo donde char tiene signo.
printf("%02x %02x %02x %02x\n", (unsigned char) b0, (unsigned char) b1,
       (unsigned char) b2, (unsigned char) b3);
$ printf "año" | build/read_bytes
scanf leyó 4 byte(s)
61 c3 b1 6fUnicode también permite escribir la ñ como dos códigos: una n seguida de una tilde
combinable, U+0303. Se ve igual, pero son los bytes 6e cc 83. Lo habitual en un texto escrito
con teclado en español es U+00F1, y es lo que usamos en este curso.
Laboratorio: bits a mano
El laboratorio está en code/week-03/lab/. Allí encontrarán tres programas por completar y el
archivo answers.txt, donde anotan sus respuestas. Mientras trabajan, make test-lab les dice
qué falta. Falla hasta que terminen.
Actividad 1: 202 a mano. Conviertan 202 a binario con las divisiones y a hexadecimal
agrupando bits. Anótenlo en answers.txt. Después completen lab/hex_202.c para comprobarlo con
printf("%x").
Actividad 2: leer el mensaje del sanitizer. En lab/int_overflow.c, lean un int con scanf,
súmenle 1 y escriban el resultado. Hagan lo mismo que en overflow.c, pero escribiéndolo ustedes.
Luego:
make lab
echo 2147483647 | build/lab/int_overflow
Busquen la línea runtime error y anoten en answers.txt el número de línea que indica. Debe ser
la línea donde hacen la suma.
Actividad 3: 20 decimales. En lab/float_print.c, escriban 0.1 + 0.2 con %.20f. Comparen
con lo que sale con %f.
Actividad 4: la ñ con xxd. Dentro de la carpeta lab/, creen el archivo year.txt con año
y mírenlo con xxd. Identifiquen los bytes de la ñ y anoten el total de bytes del archivo.
Actividad 5: Git. La siguiente sección la explica paso a paso. No tiene prueba automática: se revisa en el laboratorio.
Primeros pasos con Git
Para qué sirve
Cuando se trabaja en algo durante semanas, tarde o temprano se rompe algo que funcionaba, y
uno quisiera volver atrás. La solución ingenua son archivos como tarea_final.c,
tarea_final2.c, tarea_final_ahora_si.c. Git resuelve esto bien: guarda el historial de una
carpeta, con cada estado anterior y una descripción de qué cambió.
Tres palabras:
- Repositorio: la carpeta cuyo historial lleva Git. El historial se guarda en una
subcarpeta oculta llamada
.git. - Commit: un registro de cómo estaban los archivos en un momento, con un mensaje que dice qué cambió.
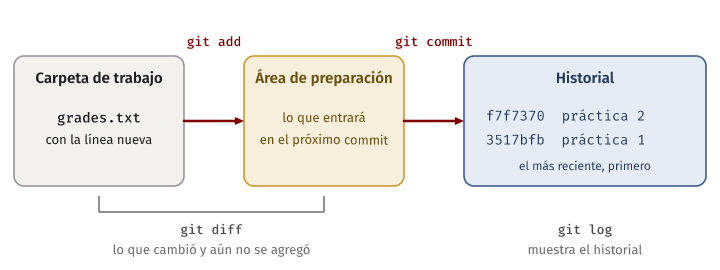
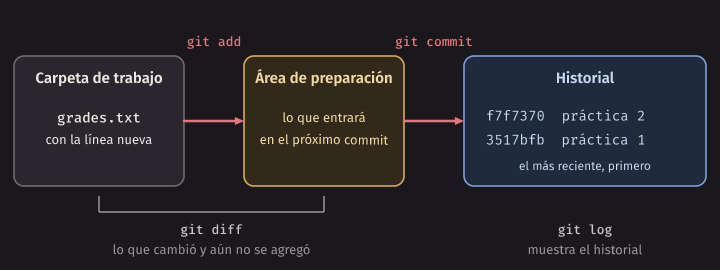
- Área de preparación (staging area): la lista de cambios que van a entrar en el próximo commit.
El flujo básico tiene dos pasos, y esa es la diferencia entre los dos comandos principales:
| Comando | Qué hace |
|---|---|
git add archivo |
Pone los cambios del archivo en el área de preparación. Todavía no guarda nada en el historial. |
git commit -m "mensaje" |
Crea un commit con lo que está en el área de preparación. |
¿Por qué dos pasos? Porque así se elige qué cambios van juntos. Si hoy tocaron dos cosas sin relación, pueden hacer un commit para cada una.
Dónde crear el repositorio
Git no es solo para código, y este repositorio de práctica es desechable. Créenlo en su carpeta
personal, ~, y no dentro de la carpeta del curso. La carpeta del curso puede ser ya un
repositorio, y un repositorio dentro de otro complica las cosas sin necesidad.
Un trabajo con dos commits
Una sesión completa, con un archivo de notas. Los mensajes de Git están en inglés.
$ cd ~
$ mkdir lab03-git
$ cd lab03-git
$ git init
hint: Using 'master' as the name for the initial branch. This default branch name
hint: is subject to change. To configure the initial branch name to use in all
hint: of your new repositories, which will suppress this warning, call:
hint:
hint: 	git config --global init.defaultBranch <name>
hint:
hint: Names commonly chosen instead of 'master' are 'main', 'trunk' and
hint: 'development'. The just-created branch can be renamed via this command:
hint:
hint: 	git branch -m <name>
Initialized empty Git repository in /root/lab03-git/.git/
git init convierte la carpeta en repositorio. Las líneas hint: son solo sugerencias, y por
ahora las podemos ignorar: hablan de branches, que no veremos en este curso. La ruta de
la última línea depende de su entorno.
Ahora creamos un archivo y preguntamos el estado con git status, el comando que conviene
usar todo el tiempo:
$ echo "Práctica 1: 15" > grades.txt
$ git status
On branch master

No commits yet

Untracked files:
  (use "git add <file>..." to include in what will be committed)
	grades.txt

nothing added to commit but untracked files present (use "git add" to track)
Untracked quiere decir que Git ve el archivo pero todavía no lleva su historial. Lo agregamos:
$ git add grades.txtgit status ahora lo mostraría bajo Changes to be committed: ya está en el área de preparación.
Hagamos el commit. La primera vez, Git puede quejarse:
$ git commit -m "Agrega la nota de la práctica 1"
Author identity unknown

*** Please tell me who you are.

Run

  git config --global user.email "you@example.com"
  git config --global user.name "Your Name"

to set your account's default identity.
Omit --global to set the identity only in this repository.

fatal: unable to auto-detect email address (got 'root@616988be0ce2.(none)')
Cada commit guarda quién lo hizo, y Git todavía no lo sabe. El mensaje dice cómo resolverlo. Se hace una sola vez, con su propio nombre y correo. Lo que aparece entre comillas al final de ese mensaje cambia según la máquina, y en algunos entornos la identidad ya viene configurada y no verán este error.
$ git config --global user.name "Ana Quispe"
$ git config --global user.email "ana@example.com"
$ git commit -m "Agrega la nota de la práctica 1"
[master (root-commit) 3517bfb] Agrega la nota de la práctica 1
 1 file changed, 1 insertion(+)
 create mode 100644 grades.txt
El 3517bfb identifica el commit y será otro en su máquina: depende del contenido, del autor y de
la fecha.
Agreguemos una segunda nota. El operador >> agrega al final del archivo, a diferencia de >, que
lo reemplaza:
$ echo "Práctica 2: 17" >> grades.txt
$ git diff
diff --git a/grades.txt b/grades.txt
index 12e499b..c4a572a 100644
--- a/grades.txt
+++ b/grades.txt
@@ -1 +1,2 @@
 Práctica 1: 15
+Práctica 2: 17
git diff muestra lo que cambió en la carpeta y todavía no se agregó con git add. La línea que
empieza con + es la nueva. Hay que leer el diff antes de hacer un commit: es la última
oportunidad de ver lo que van a guardar.
$ git add grades.txt
$ git diff
$ git commit -m "Agrega la nota de la práctica 2"
[master f7f7370] Agrega la nota de la práctica 2
 1 file changed, 1 insertion(+)
$ git log
commit f7f7370f44d4394951d5cf9a47ef6e9f423a6987
Author: Ana Quispe <ana@example.com>
Date:   Mon Nov 2 07:52:42 2026 +0000

    Agrega la nota de la práctica 2

commit 3517bfb6bcc1946cfd3249b6357c2a3172d879ec
Author: Ana Quispe <ana@example.com>
Date:   Mon Nov 2 07:52:42 2026 +0000

    Agrega la nota de la práctica 1
Después de git add, git diff no muestra nada: ese comando no incluye lo que ya está en el área de
preparación. git log muestra el historial, con el commit más reciente primero. Los
identificadores y las fechas serán otros en su máquina. Si la lista no cabe en la pantalla, se
sale de ella con la tecla q. También existe una versión corta:
$ git log --oneline
f7f7370 Agrega la nota de la práctica 2
3517bfb Agrega la nota de la práctica 1
Error común. Editar un archivo, hacer
git commity creer que quedó guardado. Singit add, el cambio no entra en el commit.git statusles dice qué va a entrar y qué no.
Error común. Escribir mensajes como “cambios” o “arreglo”. Dentro de un mes no van a decir nada. Un buen mensaje dice qué cambió: “Agrega la nota de la práctica 2”.
Por ahora todo esto vive en su propia máquina. Git no necesita internet para funcionar. GitHub es un servicio para guardar y compartir repositorios en línea, y no lo necesitamos esta semana.
Resumen
- Un bit vale 0 o 1, y un byte son 8 bits. Con n bits hay 2ⁿ combinaciones. Un patrón de bits no significa nada hasta que un tipo lo interpreta.
- En un sistema posicional, cada dígito vale según su lugar. De decimal a binario se divide entre 2 y se leen los restos al revés. Un dígito hexadecimal son 4 bits, y un byte son dos dígitos.
- 1 kB son 1000 bytes y 1 KiB son 1024.
bes bit yBes byte. - En complemento a dos, el bit de la izquierda pesa negativo. Con n bits el rango va de -2ⁿ⁻¹ a 2ⁿ⁻¹ - 1. Para cambiar el signo se invierten los bits y se suma 1.
- El overflow de un entero con signo es comportamiento indefinido en C. UBSan lo reporta para valores que llegan en la ejecución. Los enteros sin signo sí dan la vuelta, porque C lo define.
- Un
doubletiene 64 bits y casi siempre guarda una aproximación. No se comparan con==, sino con una tolerancia. El dinero se guarda en céntimos, en un entero. - Un
chares un número pequeño. ASCII asigna códigos del 0 al 127. C no dice sichartiene signo. - Unicode asigna un código a cada carácter, y UTF-8 lo guarda en 1 a 4 bytes. La
ñesU+00F1y se guarda comoc3 b1.xxdmuestra los bytes. - Git guarda el historial de una carpeta:
git init,git status,git add,git diff,git commitygit log.git addprepara ygit commitregistra.
Ejercicios
- Conviertan
10110110a decimal y a hexadecimal. - Conviertan a mano 45 y 200 a binario de 8 bits y a hexadecimal. Comprueben el resultado con
to_binaryyprintf("%x"). - ¿Cuántos valores distintos se pueden representar con 10 bits? ¿Y cuántos bytes hacen falta para
un
intde 32 bits? Un archivo de 3 KiB, ¿cuántos bytes tiene exactamente? - ¿Cuál es el mayor entero con signo de 8 bits? ¿Cómo se escribe -1 en complemento a dos? ¿Y -20? Muestren el proceso de invertir y sumar 1.
- Sumen en binario, con 8 bits en complemento a dos, 100 + 27 y 100 + 28. ¿En cuál hay overflow? ¿Cómo se nota en los bits?
- Sin ejecutarlo, ¿qué pueden decir de lo que escribe un programa que lee 2147483647 en un
intny escriben + 1? ¿Qué cambia sinesunsigned char, vale 255 y se ejecutan = n + 1? - Con el algoritmo
fraccion_a_binario, saquen los primeros 8 bits de 0.3 y de 0.625. ¿Cuál de los dos se guarda exactamente en undouble? ¿Por qué? - ¿Por qué no conviene guardar el saldo de una cuenta en un
double? Escriban un programa que lea un precio en céntimos y una cantidad, y escriba el total en el formatoS/ 12.05. - Sin ejecutarlo, ¿qué escribe
printf("%c %d\n", 'C' + 32, '9' - '0');? Después compruébenlo. - Un archivo tiene 5 caracteres y 7 bytes en UTF-8. ¿Cómo es posible? Den otro ejemplo de una palabra
con 6 caracteres y 8 bytes, y compruébenlo con
xxd. - Calculen a mano los bytes UTF-8 de la
é(U+00E9) y de laá(U+00E1). ¿Cuántos bytes ocupa€y por qué? Usen la tabla de patrones. - ¿Para qué sirven
git addygit commit, y en qué se diferencian? En un repositorio de práctica, hagan tres commits: uno crea un archivo y los otros dos lo modifican. Muestrengit log --oneliney expliquen qué mostraríagit diffjusto antes de cadagit add.